算法合集

前导

算法讲解019【必备】算法笔试中处理输入和输出_哔哩哔哩_bilibili

这是很必要的

简单来说用BufferReader可以把所有文件用内存来托管

然后用StreamTokenizer可以忽略所有的空格和换行把一个个数字读出来

按行读

不推荐用动态

推荐使用全局静态空间

IO模板规定数据量的题性型

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
import java.io.*;

public class Main{

//题目给定的行最大数据量
public static int MAXN = 201;

//题目给定的列的最大数据量
public static int MAXM = 201;

//静态的空间,不停的复用
public static int[][] mat = new int[MAXN][MAXM];
//能用静态就用静态


public static void main(String[] args) throws IOException{
//把文件里的内容,load进来,保存在内存里,很高效
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
//一个一个读数字
StreamTokenizer in = new StreamTokenizer(br);

//提交答案的时候用的,也是一个内存托管区
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){//文件没有结束就继续
//n,二维数组的行
int n = (int) in.nval;
in.nextToken();
//m,二维数组的列
int m = (int) in.nval;
//装数字的矩阵,临时动态生成
int[][] mat = new int[n][m];
for(int i = 0 ; i < n ;i++){
for(int j = 0 ; j < m ;j++){
in.nextToken();
mat[i][j] = (int) in.nval;
}
}
out.println(...);

}
out.flush();
out.close();

}
}

按行读数的题型

不告诉你每组数据的规模,这里就不能用StreamTokenizer了因为不知道什么时候结束了。

那就把每行读出来之后在自己切分

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class Main{
public static String line;

public static String[] parts;

public static int sum;
public static void main(String[] args){
BufferReader in = new BufferReader(new InputStreamReader(System.in));
PrintWriter out = new PrintWriter(new OutputStream(System.out));
while((line = in.readLine()) != null){
parts = line.split(" ");
sum = 0;
for(String num : parts){
sum += Integer.valueOf(num));
}
out.println(sum);
}
out.flush();
in.close();
out.close();
}
}

数组的操作

方法 描述 时间复杂度
添加元素
add(E e) 将元素 e 添加到列表末尾。 O(1) 摊销
add(int index, E element) 在指定 index 位置插入元素 element。后续元素向后移动。 O(n)
删除元素
remove(int index) 删除指定 index 位置的元素,并返回它。后续元素向前移动。 O(n)
remove(Object o) 删除列表中第一次出现的指定元素 o。 O(n)
clear() 移除列表中的所有元素。 O(1)
修改元素
set(int index, E element) 将指定 index 位置的元素替换为 element,并返回原来的元素。 O(1)
查询元素
get(int index) 返回指定 index 位置的元素。 O(1)
indexOf(Object o) 返回指定元素 o 第一次出现的索引,如果不存在则返回 -1。 O(n)
lastIndexOf(Object o) 返回指定元素 o 最后一次出现的索引,如果不存在则返回 -1。 O(n)
contains(Object o) 判断列表是否包含指定元素 o。 O(n)
获取信息
size() 返回列表中元素的个数。 O(1)
isEmpty() 判断列表是否为空。 O(1)
转换
toArray() 将列表转换为一个数组。 O(n)

链表的操作

这些方法让你可以像操作普通列表一样使用 LinkedList。

方法 描述 时间复杂度
add(E e) 将元素 e 添加到链表末尾。 O(1)
add(int index, E element) 在指定的 index 位置插入元素 element。 O(n)
addFirst(E e) 将元素 e 添加到链表开头。 O(1)
addLast(E e) 将元素 e 添加到链表末尾 (等同于 add)。 O(1)
get(int index) 获取指定 index 位置的元素。 O(n)
getFirst() 获取链表第一个元素。 O(1)
getLast() 获取链表最后一个元素。 O(1)
set(int index, E element) 将指定 index 位置的元素替换为 element。 O(n)
remove(int index) 删除指定 index 位置的元素并返回它。 O(n)
remove(Object o) 删除链表中第一次出现的指定元素 o。 O(n)
removeFirst() 删除并返回链表第一个元素。 O(1)
removeLast() 删除并返回链表最后一个元素。 O(1)
size() 返回链表中元素的个数。 O(1)
isEmpty() 判断链表是否为空。 O(1)
contains(Object o) 判断链表中是否包含指定元素 o。 O(n)
clear() 清空链表,移除所有元素。 O(1)

数组排序方法

1
2
int[] nums = {2,-1,2,4,5,6};
nums = IntStream.of(nums).boxed().sorted((o1,o2) -> Math.abs(o2) - Math.abs(o1)).mapToInt(Integer::intValue).toArray();

我们一步步拆解:


🔹 1. int[] nums = {2, -1, 2, 4, 5, 6};

定义一个基本类型 int 的数组,初始值为:[2, -1, 2, 4, 5, 6]


🔹 2. IntStream.of(nums)

  • IntStream.of(nums):将 int[] 数组包装成一个 IntStream(Java 8 的流,专门处理 int 类型)。
  • 它是流式操作的起点。

此时你有一个 IntStream,里面的数据是:2, -1, 2, 4, 5, 6

🔹 3. .boxed()

  • 将 IntStream 中的每个 int 装箱(boxing)为对应的 Integer 对象。
  • 结果是一个 Stream<Integer>。

✅ 为什么需要这一步?
因为接下来我们要使用 .sorted() 并传入一个 Comparator,而 IntStream 本身不支持自定义比较器排序(除非是基本排序),所以我们需要转成对象流 Stream<Integer> 才能使用 (o1, o2) -> ... 这种比较方式。

👉 现在流变成了:Stream<Integer>,包含 [2, -1, 2, 4, 5, 6]


🔹 4. .sorted((o1, o2) -> Math.abs(o2) - Math.abs(o1))

这是排序的核心逻辑。

参数说明:

  • o1, o2:流中的两个 Integer 对象
  • Math.abs(o1):o1 的绝对值
  • Math.abs(o2):o2 的绝对值

比较逻辑:

1
Math.abs(o2) - Math.abs(o1)
  • 如果结果 > 0:o2 的绝对值更大,o2 应该排在前面(降序)
  • 如果结果 < 0:o1 的绝对值更大,o1 应该排在前面
  • 如果结果 = 0:相等,顺序不变(稳定排序)

👉 所以这个 Comparator 实现的是:按绝对值从大到小排序(降序)


🔹 5. .mapToInt(Integer::intValue)

  • mapToInt:将 Stream<Integer> 转换回 IntStream
  • Integer::intValue:方法引用,等价于 x -> x.intValue(),把 Integer 对象“拆箱”回 int 值

✅ 为什么需要这一步?
因为 .toArray() 在对象流上会返回 Integer[],但我们最终想要的是 int[],所以必须先转回 IntStream,再调用 .toArray() 得到 int[]


🔹 6. .toArray()

  • 对 IntStream 调用 .toArray(),生成一个新的 int[] 数组
  • 内容是排序后的 int 值

除法运算

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 计算并返回 double 类型,保留2位小数(四舍五入)
public static double div2(double a, double b) {
return Math.round(a / b * 100.0) / 100.0;
}

// 直接打印,保留2位小数
public static void printDiv2(double a, double b) {
System.out.printf("%.2f%n", a / b);
}

// 整数相除向上取整
public static long divideCeil(int a, int b) {
return (a + b - 1) / b;
}

// 整数相除向下取整
public static long divideFloor(int a, int b) {
return a / b;
}

二维数组的排序

1
2
Arrays.sort(intervals, (a, b) -> Integer.compare(a[0], b[0]));
//对二维数组 intervals 按照每个子数组的第一个元素(即区间的起始位置)进行升序排序。

两个整数相加后除以2保证不会溢出

1
int avg = a + (b - a) / 2;

操作字符串!!!

首先String是不可变类,一旦创建就不能修改

字符串存储在字符串常量池中

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
//2、字符访问
String str = 'java';
char c = str.charAt(0);
//字符串拼接
StringBuilder sb = new StringBuilder();
sb.append("Hello").append(" ").append("World");
String res = sb.toString();
//大小写转换
str.toLowerCase();
str.toUpperCase();
//去除首尾空格
str.trim();
//子字符串截取
str.substring(0,5);//这个是左包含,右不包含
String str = "Hello World";

String str = "Hello World";
str.indexOf('o'); // 4(第一次出现)
str.lastIndexOf('o'); // 7(最后一次出现)
str.indexOf("World"); // 6
str.contains("World"); // true
str.replace("World", "Java"); // "Hello Java"
String str = "apple,banana,orange";
String[] fruits = str.split(",");

类型 转换方式
int → String String.valueOf(123) 或 123 + ""
String → int Integer.parseInt("123")
double → String String.valueOf(3.14)
String → double Double.parseDouble("3.14")

操作栈

Deque其实是双端队列

1
Deque<Integer> st = new ArrayDeque<>();

Deque 提供了丰富的操作方法,通常每种操作都有两种形式:

方法类型 抛异常 返回特殊值(null 或 false)
插入 addFirst(e), addLast(e) offerFirst(e), offerLast(e)
删除 removeFirst(), removeLast() pollFirst(), pollLast()
查看 getFirst(), getLast() peekFirst(), peekLast()
操作 Deque(推荐) Stack(不推荐)
创建 new ArrayDeque<>() new Stack<>()
入栈 push(e) 或 addFirst(e) push(e)
出栈 pop() 或 removeFirst() pop()
查看栈顶 peek() 或 peekFirst() peek()
性能 ⚡ 快(ArrayDeque 基于数组) 🐢 慢(Stack 继承 Vector,加锁)
线程安全 否(更高效) 是(带同步,性能差)
推荐程度 ✅✅✅ 强烈推荐 ❌ 避免使用

操作图

使用HashMap

方法 说明
put(K key, V value) 插入或更新键值对
get(Object key) 根据键获取值,不存在返回 null
remove(Object key) 删除键值对
containsKey(Object key) 是否包含某个键
containsValue(Object value) 是否包含某个值(较慢)
size() 返回键值对数量
isEmpty() 是否为空
clear() 清空所有数据
keySet() 返回所有键的集合
values() 返回所有值的集合
entrySet() 返回所有键值对(Map.Entry)的集合

排序

快排

思路其实是递归,然后主题思路就是找一个基准数可以是第一个,然后有两个指针,指向第2个和最后一个,然后移动指针,如果右边的数比基准数小就交换第一个指针,然后第一个指针向后移动,如果大于就向左移动,最后让左边的跟基准交换,然后递归,结束条件就是第一个指针大于或者等于后面的指针。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import java.util.*;
import java.io.*;

public class Main{
public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){
int n = (int)in.nval;
while(n-- > 0){
in.nextToken();
int size = (int)in.nval;
int[] arr = new int[size];
for(int i = 0 ; i < size ; i++){
in.nextToken();
arr[i] = (int)in.nval;
}
quickSort(arr,0,size - 1);

for(int i = 0 ; i < size ; i++){
if(i == size - 1){
out.print(arr[i]);
out.println();
}else{
out.print(arr[i] + " ");
}
}

}
out.flush();
out.close();
}
}

public static void quickSort(int[] arr,int left,int right){
if(left >= right){
return;
}
int pivotIndex = partition(arr,left,right);
quickSort(arr,left,pivotIndex - 1);
quickSort(arr,pivotIndex + 1, right);
}

public static partition(int[] arr,int left,int right){
int i = left;
int pivot = arr[right];
for(int j = right; j > i ; j--){
if(arr[j] <= pivot){
swap(arr,arr[i],arr[j]);
i++
}
}
return i;
}

public static swap(int[] arr,int i,int j){
int tmp = i;
i = j;
j = tmp;
}
}

归并

主要思路就是把原数组划分为两个子数组,然后两个子数组排序,最后合并,合并再排序。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
import java.util.*;
import java.io.*;

public class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval;
while (n-- > 0) {
in.nextToken();
int size = (int) in.nval;
int[] arr = new int[size];
for (int i = 0; i < size; i++) {
in.nextToken();
arr[i] = (int) in.nval;
}


mergeSort(arr, 0, size - 1);

for (int i = 0; i < size; i++) {
if (i == size - 1) {
out.print(arr[i]);
out.println();
} else {
out.print(arr[i] + " ");
}
}
}
}


out.flush();
out.close();
}

public static void mergeSort(int[] arr, int left, int right) {
if (left >= right) return;

int mid = left + (right - left) / 2;


mergeSort(arr, left, mid);
mergeSort(arr, mid + 1, right);

merge(arr, left, mid, right);
}


public static void merge(int[] arr, int left, int mid, int right) {
int[] temp = new int[right - left + 1];
int i = left;
int j = mid + 1;
int k = 0;

while (i <= mid && j <= right) {
if (arr[i] <= arr[j]) {
temp[k++] = arr[i++];
} else {
temp[k++] = arr[j++];
}
}


while (i <= mid) {
temp[k++] = arr[i++];
}
while (j <= right) {
temp[k++] = arr[j++];
}


for (int p = 0; p < temp.length; p++) {
arr[left + p] = temp[p];
}
}
}

第一章 数组

1、数组理论基础

数组是存放在连续内存空间上的相同类型的集合

  • 数组的下标都是从0开始
  • 数组内存空间的地址是连续的

正式因为数组 在内存空间的地址是连续的,所以我们在删除或者添加元素的时候,难免要移动其他元素的地址

!!!数组的元素是不能删的,只能覆盖!!!

二维数组的话第一个索引是行,第二个索引是列

C++中二维数组在地址空间上是连续的,Java的二维数组在地址空间上的地址就不连续了,而是经历过几次跳转。

2、二分查找

力扣二分查找题目连接

题目建议: 大家今天能把 704.二分查找 彻底掌握就可以,至于 35.搜索插入位置 和 34. 在排序数组中查找元素的第一个和最后一个位置 ,如果有时间就去看一下,没时间可以先不看,二刷的时候在看。

给定一个 n 个元素有序的(升序)整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 target,如果目标值存在返回下标,否则返回 -1。

示例 1:

1
2
3
输入: nums = [-1,0,3,5,9,12], target = 9     
输出: 4
解释: 9 出现在 nums 中并且下标为 4

示例 2:

1
2
3
输入: nums = [-1,0,3,5,9,12], target = 2     
输出: -1
解释: 2 不存在 nums 中因此返回 -1

提示:

  • 你可以假设 nums 中的所有元素是不重复的。
  • n 将在 [1, 10000]之间。
  • nums 的每个元素都将在 [-9999, 9999]之间。

思路

这道题目的前提是数组是有序数组,同时题目还强调 数组中没有重复元素,因为一旦有重复元素,使用二分查找法返回的元素下标可能不是唯一的,这都是使用二分法的前提条件。

难点是边界条件的控制

区间的定义就是不变量在二分查找的过程中,保持不变量,就是在while寻找中每一次边界的处理都要坚持根据区间的定义 来操作,这就是循环不变量规则。

写二分法,区间的定义一般为两种,左闭右闭即[left, right],或者左闭右开即[left, right)。

思路一:区间左闭右闭[left,right]

第一种写法,我们定义target式在一个左闭右闭的区间里,也就是[left,right]。

因为定义了这个区间,所以

  • while(left <= right) 要使用<=,因为left==right是有意义的,所以使用<=
  • if(nums[mid] > target)right要赋值为middle-1,因为当前这个nums[mid]一定不是target,那么接下来要查找的做区间结束下标就是right = mid-1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public int search(int[] nums, int target) {
int l = 0;
int r = nums.length - 1;
int m = (l+r)/2;
while(l <= r){//因为当left==right,区间依然有效所以用<=
if(nums[m] == target){
return m;
}
if(nums[m] < target){
l = m + 1;
m = (l + r) / 2;

}else{
r = m - 1;
m = (l + r) / 2;
}
}
return -1;
}
}
思路二:区间左闭右开[left,right)
  • while (left < right),这里使用 < ,因为left == right在区间[left, right)是没有意义的
  • if (nums[middle] > target) right 更新为 middle,因为当前nums[middle]不等于target,去左区间继续寻找,而寻找区间是左闭右开区间,所以right更新为middle,即:下一个查询区间不会去比较nums[middle]
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public int search(int[] nums, int target) {
int l = 0;
int r = nums.length;//右开是因为这个超了
int m = (l+r)/2;
while(l < r){
if(nums[m] == target){
return m;
}
if(nums[m] < target){
l = m + 1;
m = (l + r) / 2;

}else{
r = m ;
m = (l + r) / 2;
}
}
return -1;
}
}

其他题目

3、移出元素

题目建议: 暴力的解法,可以锻炼一下我们的代码实现能力,建议先把暴力写法写一遍。 双指针法 是本题的精髓,今日需要掌握,至于拓展题目可以先不看。

移除元素题目链接

给你一个数组 nums 和一个值 val,你需要 原地 移除所有数值等于 val 的元素,并返回移除后数组的新长度。

不要使用额外的数组空间,你必须仅使用 O(1) 额外空间并原地修改输入数组。

元素的顺序可以改变。你不需要考虑数组中超出新长度后面的元素。

示例 1: 给定 nums = [3,2,2,3], val = 3, 函数应该返回新的长度 2, 并且 nums 中的前两个元素均为 2。 你不需要考虑数组中超出新长度后面的元素。

示例 2: 给定 nums = [0,1,2,2,3,0,4,2], val = 2, 函数应该返回新的长度 5, 并且 nums 中的前五个元素为 0, 1, 3, 0, 4。

你不需要考虑数组中超出新长度后面的元素。

!!!数组中的元素不能删除,只能覆盖!!!

思路

思路一:暴力破解

首先外面用一个size,另一个类似于指针

两层for循环,一个for循环遍历数组元素 ,第二个for循环更新数组。

一个是外面的size控制数组的长度,里面那层类似于指针从0开始到size结束,如果指针找到对应的val那么就用一个for循环把后面的数向前移动一格,移动完之后,指针到下一个地址。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Solution {
public int removeElement(int[] nums, int val) {

int size = nums.length;
for (int i = 0; i < size; i++) {
if (nums[i] == val) { // 发现需要移除的元素,就将数组集体向前移动一位
for (int j = i + 1; j < size; j++) {
nums[j - 1] = nums[j];
}
i--; // 因为下标i以后的数值都向前移动了一位,所以i也向前移动一位
size--; // 此时数组的大小-1
}
}
return size;
}
}
思路二:快慢指针

一个快指针,一个慢指针,快指针在前面探查新元素是否匹配规则,慢指针负责更新数据。

当快指针超过数组长度结束,一开始快指针和慢指针指向第一个数,如果第一个数不等于val那么,快指针和慢指针就会一起向后移动一格,如果快指针指向的数等于val,那么快指针就会移动到新的元素,然后慢指针不动,如果快指针的下一个元素还是等于那么快指针向下移动一格,慢指针还是不动,如果快指针的下一个不等于val了,那么快指针指向的数就会和慢指针指向的数交换并且慢指针和快指针都向后移动一格

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int removeElement(int[] nums, int val) {
int len = nums.length;
int fast = 0 ;
int slow = 0;
while(fast < len){
if(nums[fast] != val){
nums[slow] = nums[fast];
fast++;
slow++;
}else if(nums[fast] == val){
fast++;
}
}
return slow;

}
}

其他题目推荐

4、有序数组的平方

有序数组的平方链接

给你一个按 非递减顺序 排序的整数数组 nums,返回 每个数字的平方 组成的新数组,要求也按 非递减顺序 排序。

示例 1:

  • 输入:nums = [-4,-1,0,3,10]
  • 输出:[0,1,9,16,100]
  • 解释:平方后,数组变为 [16,1,0,9,100],排序后,数组变为 [0,1,9,16,100]

示例 2:

  • 输入:nums = [-7,-3,2,3,11]

  • 输出:[4,9,9,49,121]

思路

思路一:每个数平方然后排个序
1
2
3
4
5
6
7
8
9
class Solution {
public int[] sortedSquares(int[] nums) {
for(int i = 0 ; i < nums.length ; i++){
nums[i] = nums[i] * nums[i];
}
Arrays.sort(nums);//利用Arrays工具类
return nums;
}
}
思路二:利用双指针

一开始是非递减也就是递增的数组,所以最大的数只能在左右两边,左边或者右边,不可能是中间,所以先用两个指针指在数组的左右两边,一开始新建一个结果数组然后,比较两个数左右两边谁大,如果右边大,那么右边向左移动一格,然后结果数组的最后一位放右边的数,如果左边大,那么左边向右移动一格,然后数组的最后一位放左边的数,之后左边向右移动一格,如果一样大,那么左边向右边移动一格,放左边的数,直到左边大于右边指针地址(等于的时候放最后一个数)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public int[] sortedSquares(int[] nums) {
int l = 0 ;
int r = nums.length - 1;
int[] res = new int[r + 1];
int idx = r;
while(l <= r){
int left = nums[l] * nums[l];
int right = nums[r] * nums[r];
if( left < right){
res[idx] = right;
idx--;
r--;
}
if(left == right){
res[idx] = left;
idx--;
l++;
}
if(left > right){
res[idx] = left;
idx--;
l++;
}
}
return res;
}
}

5、长度最小的子数组

题目建议: 本题关键在于理解滑动窗口

力扣题目链接

给定一个含有 n 个正整数的数组和一个正整数 s ,找出该数组中满足其和 ≥ s 的长度最小的 连续 子数组,并返回其长度。如果不存在符合条件的子数组,返回 0。

示例:

  • 输入:s = 7, nums = [2,3,1,2,4,3]
  • 输出:2
  • 解释:子数组 [4,3] 是该条件下的长度最小的子数组。

提示:

  • 1 <= target <= 10^9
  • 1 <= nums.length <= 10^5
  • 1 <= nums[i] <= 10^5

思路

思路一:暴力破解

这道题目暴力解法当然是 两个for循环,然后不断的寻找符合条件的子序列,时间复杂度很明显是O(n^2)。

一个变量存储答案数组的长度,一个存储和,一个存储子数组长度,然后两个for循环,如果和大于或者等于目标值就结束,然后如果子数组长度小于答案数组长度就更新答案数组的长度。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public int minSubArrayLen(int target, int[] nums) {
int minLen = 0 ;
int ans = Integer.MAX_VALUE;
int arrLen = 0;
for(int i = 0 ; i < nums.length ; i++){
int sum = 0 ;
arrLen = 0;
for(int j = i ; j < nums.length ; j++){
sum+=nums[j];
arrLen++;
if(sum >= target && arrLen < ans){
ans = arrLen;
break;
}
}
}
return ans == Integer.MAX_VALUE ? 0 : ans;
}
}
思路二:滑动窗口

接下来就开始介绍数组操作中另一个重要的方法:滑动窗口。

所谓滑动窗口,就是不断的调节子序列的起始位置和终止位置,从而得出我们要想的结果。

在暴力解法中,是一个for循环滑动窗口的起始位置,一个for循环为滑动窗口的终止位置,用两个for循环 完成了一个不断搜索区间的过程。

那么滑动窗口如何用一个for循环来完成这个操作呢。

首先要思考 如果用一个for循环,那么应该表示 滑动窗口的起始位置,还是终止位置。

如果只用一个for循环来表示 滑动窗口的起始位置,那么如何遍历剩下的终止位置?

此时难免再次陷入 暴力解法的怪圈。

所以 只用一个for循环,那么这个循环的索引,一定是表示 滑动窗口的终止位置。

然后思考滑动窗口的起始位置怎么移动?

首先有两个指针一个指针用于表示起始位置,一个指针表示向后探索的位置,一个sum记录指针从起始位置到另一个指针的和,如果和小于目标值,那么另一个指针向后移动一格,再次计算sum,如果大于等于就更新长度如果比最小长度小的话,如果不是就不用更新,然后起始位置的指针向后移动一格,后面的指针也向后移动一格,如果后面的指针超过数组长度直接结束,返回最小长度。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public int minSubArrayLen(int target, int[] nums) {
int slow = 0;
int sum = 0;
int ans = Integer.MAX_VALUE;

for (int fast = 0; fast < nums.length; fast++) {
sum += nums[fast]; // 扩展右边界

while (sum >= target) {
// 当前窗口满足条件,尝试缩小左边界
ans = Math.min(ans, fast - slow + 1);
sum -= nums[slow]; // 减去即将移出窗口的元素
slow++;
}
}

return ans == Integer.MAX_VALUE ? 0 : ans;
}
}

滑动窗口“逐步累加”的高效特性

相关题目

6、螺旋矩阵

给定一个正整数 n,生成一个包含 1 到 n^2 所有元素,且元素按顺时针顺序螺旋排列的正方形矩阵。

示例:

输入: 3 输出: [ [ 1, 2, 3 ], [ 8, 9, 4 ], [ 7, 6, 5 ] ]

思路

这道题目可以说在面试中出现频率较高的题目,本题并不涉及到什么算法,就是模拟过程,但却十分考察对代码的掌控能力。

要如何画出这个螺旋排列的正方形矩阵呢?

相信很多同学刚开始做这种题目的时候,上来就是一波判断猛如虎。

结果运行的时候各种问题,然后开始各种修修补补,最后发现改了这里那里有问题,改了那里这里又跑不起来了。

大家还记得我们在这篇文章数组:每次遇到二分法,都是一看就会,一写就废 (opens new window)中讲解了二分法,提到如果要写出正确的二分法一定要坚持循环不变量原则。

而求解本题依然是要坚持循环不变量原则。

模拟顺时针画矩阵的过程:

  • 填充上行从左到右
  • 填充右列从上到下
  • 填充下行从右到左
  • 填充左列从下到上

由外向内一圈一圈这么画下去。

可以发现这里的边界条件非常多,在一个循环中,如此多的边界条件,如果不按照固定规则来遍历,那就是一进循环深似海,从此offer是路人。

这里一圈下来,我们要画每四条边,这四条边怎么画,每画一条边都要坚持一致的左闭右开,或者左开右闭的原则,这样这一圈才能按照统一的规则画下来。

那么我按照左闭右开的原则,来画一圈,大家看一下:

image-20250627002017341

这里每一种颜色,代表一条边,我们遍历的长度,可以看出每一个拐角处的处理规则,拐角处让给新的一条边来继续画。

这也是坚持了每条边左闭右开的原则。

一些同学做这道题目之所以一直写不好,代码越写越乱。

就是因为在画每一条边的时候,一会左开右闭,一会左闭右闭,一会又来左闭右开,岂能不乱。

代码如下,已经详细注释了每一步的目的,可以看出while循环里判断的情况是很多的,代码里处理的原则也是统一的左闭右开。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
class Solution {
public int[][] generateMatrix(int n) {
int[][] nums = new int[n][n];
int startX = 0, startY = 0; // 每一圈的起始点
int offset = 1;
int count = 1; // 矩阵中需要填写的数字
int loop = 1; // 记录当前的圈数
int i, j; // j 代表列, i 代表行;

while (loop <= n / 2) {

// 顶部
// 左闭右开,所以判断循环结束时, j 不能等于 n - offset
for (j = startY; j < n - offset; j++) {
nums[startX][j] = count++;
}

// 右列
// 左闭右开,所以判断循环结束时, i 不能等于 n - offset
for (i = startX; i < n - offset; i++) {
nums[i][j] = count++;
}

// 底部
// 左闭右开,所以判断循环结束时, j != startY
for (; j > startY; j--) {
nums[i][j] = count++;
}

// 左列
// 左闭右开,所以判断循环结束时, i != startX
for (; i > startX; i--) {
nums[i][j] = count++;
}
startX++;
startY++;
offset++;
loop++;
}
if (n % 2 == 1) { // n 为奇数时,单独处理矩阵中心的值
nums[startX][startY] = count;
}
return nums;
}
}


7、区间和

区间和题目链接

题目描述

给定一个整数数组 Array,请计算该数组在每个指定区间内元素的总和。

输入描述

第一行输入为整数数组 Array 的长度 n,接下来 n 行,每行一个整数,表示数组的元素。随后的输入为需要计算总和的区间下标:a,b (b > = a),直至文件结束。

输出描述

输出每个指定区间内元素的总和。

输入示例

1
2
3
4
5
6
7
8
5
1
2
3
4
5
0 1
1 3

输出示例

1
2
3
9

提示信息

数据范围:
0 < n <= 100000

思路

本题我们来讲解 数组 上常用的解题技巧:前缀和

首先来看本题,我们最直观的想法是什么?

那就是给一个区间,然后 把这个区间的和都累加一遍不就得了,是一道简单不能再简单的题目。

代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
#include <iostream>
#include <vector>
using namespace std;
int main() {
int n, a, b;
cin >> n;
vector<int> vec(n);
for (int i = 0; i < n; i++) cin >> vec[i];
while (cin >> a >> b) {
int sum = 0;
// 累加区间 a 到 b 的和
for (int i = a; i <= b; i++) sum += vec[i];
cout << sum << endl;
}
}

代码一提交,发现超时了…..

我在制作本题的时候,特别制作了大数据量查询,卡的就是这种暴力解法。

来举一个极端的例子,如果我查询m次,每次查询的范围都是从0 到 n - 1

那么该算法的时间复杂度是 O(n * m) m 是查询的次数

如果查询次数非常大的话,这个时间复杂度也是非常大的。

接下来我们来引入前缀和,看看前缀和如何解决这个问题。

前缀和的思想是重复利用计算过的子数组之和,从而降低区间查询需要累加计算的次数。

前缀和 在涉及计算区间和的问题时非常有用!

前缀和的思路其实很简单,我给大家举个例子很容易就懂了。

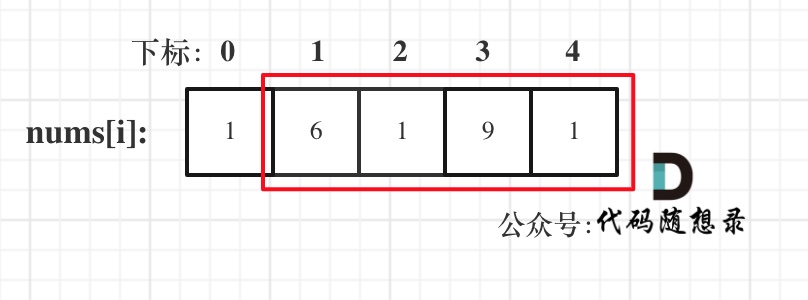
例如,我们要统计 vec[i] 这个数组上的区间和。

我们先做累加,即 p[i] 表示 下标 0 到 i 的 vec[i] 累加 之和。

如图:

img

如果,我们想统计,在vec数组上 下标 2 到下标 5 之间的累加和,那是不是就用 p[5] - p[1] 就可以了。

为什么呢?

1
2
3
p[1] = vec[0] + vec[1];
p[5] = vec[0] + vec[1] + vec[2] + vec[3] + vec[4] + vec[5];
p[5] - p[1] = vec[2] + vec[3] + vec[4] + vec[5];

这不就是我们要求的 下标 2 到下标 5 之间的累加和吗。

如图所示:

img

p[5] - p[1] 就是 红色部分的区间和。

而 p 数组是我们之前就计算好的累加和,所以后面每次求区间和的之后 我们只需要 O(1) 的操作。

特别注意: 在使用前缀和求解的时候,要特别注意 求解区间。

如上图,如果我们要求 区间下标 [2, 5] 的区间和,那么应该是 p[5] - p[1],而不是 p[5] - p[2]。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
import java.io.*;
import java.util.*;

public class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval;
int[] arr = new int[n];
int[] sum = new int[n];

for (int i = 0; i < n; i++) {
in.nextToken();
arr[i] = (int) in.nval;
}

function(arr, n, sum);
while (in.nextToken() != StreamTokenizer.TT_EOF) {
int start = (int) in.nval;
in.nextToken();
int end = (int) in.nval;
int ans = sum(sum, start, end);
out.println(ans);
}
}

out.flush();
out.close();
}

public static void function(int[] arr, int n, int[] sum) {
if (n <= 0) {
return;
}
int slow = 0;
sum[0] = arr[0];

for (int i = 1; i < n; i++) {
sum[i] = sum[slow] + arr[i];
slow++;
}
}

public static int sum(int[] sum, int start, int end) {
return start == 0 ? sum[end] : sum[end] - sum[start - 1];
}
}

8、 开发商购买土地

本题为代码随想录后续扩充题目,还没有视频讲解,顺便让大家练习一下ACM输入输出模式(笔试面试必备)

题目链接(opens new window)

【题目描述】

在一个城市区域内,被划分成了n * m个连续的区块,每个区块都拥有不同的权值,代表着其土地价值。目前,有两家开发公司,A 公司和 B 公司,希望购买这个城市区域的土地。

现在,需要将这个城市区域的所有区块分配给 A 公司和 B 公司。

然而,由于城市规划的限制,只允许将区域按横向或纵向划分成两个子区域,而且每个子区域都必须包含一个或多个区块。

为了确保公平竞争,你需要找到一种分配方式,使得 A 公司和 B 公司各自的子区域内的土地总价值之差最小。

注意:区块不可再分。

【输入描述】

第一行输入两个正整数,代表 n 和 m。

接下来的 n 行,每行输出 m 个正整数。

输出描述

请输出一个整数,代表两个子区域内土地总价值之间的最小差距。

【输入示例】

3 3 1 2 3 2 1 3 1 2 3

【输出示例】

0

【提示信息】

如果将区域按照如下方式划分:

1 2 | 3 2 1 | 3 1 2 | 3

两个子区域内土地总价值之间的最小差距可以达到 0。

【数据范围】:

  • 1 <= n, m <= 100;
  • n 和 m 不同时为 1。

思路

看到本题,大家如果想暴力求解,应该是 n^3 的时间复杂度,

一个 for 枚举分割线, 嵌套 两个for 去累加区间里的和。

如果本题要求 任何两个行(或者列)之间的数值总和,大家在0058.区间和 的基础上 应该知道怎么求。

就是前缀和的思路,先统计好,前n行的和 q[n],如果要求矩阵 a行 到 b行 之间的总和,那么就 q[b] - q[a - 1]就好。

至于为什么是 a - 1,大家去看 0058.区间和 的分析,使用 前缀和 要注意 区间左右边的开闭情况。

本题也可以使用 前缀和的思路来求解,先将 行方向,和 列方向的和求出来,这样可以方便知道 划分的两个区间的和。

前缀和

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
import java.util.*;
import java.io.*;

public class Main{
public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){
int n = (int)in.nval;
in.nextToken();
int m = (int)in.nval;
int[][] di = new int[n][m];
for(int i = 0 ; i < n ; i++){
for(int j = 0 ; j < m ; j++){
in.nextToken();
di[i][j] = (int)in.nval;
}
}

int[] hang = hang(di,n,m);
int[] lie = lie(di,n,m);
int[] arr1 = arr(hang,n);
int[] arr2 = arr(lie,m);

int min1 = min(arr1,n);
int min2 = min(arr2,m);
int res = min1 < min2 ? min1 : min2;
out.println(res);
}
out.flush();
out.close();
}

public static int[] hang(int[][] di,int n,int m){
int[] hang = new int[n];
for(int i = 0 ; i < n ; i++){
for(int j = 0 ; j < m ; j++){
hang[i] += di[i][j];
}
}
return hang;
}
public static int[] lie(int[][] di,int n,int m){
int[] lie = new int[m];
for(int j = 0 ; j < m ;j++){
for(int i = 0 ; i < n ; i++){
lie[j] += di[i][j];
}
}
return lie;
}
public static int[] arr(int[] sum,int size){

int[] arr = new int[size];
arr[0] = sum[0];
for(int i = 1 ; i < size ; i++){
arr[i] = arr[i - 1] + sum[i];
}
return arr;
}
public static int min(int[] arr,int size){
int min = Integer.MAX_VALUE;
for(int i = 0 ; i < size ; i++){
min = Math.min(Math.abs(arr[size - 1] - arr[i] - arr[i] ),min);
}
return min;
}
}

优化暴力

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
import java.util.Scanner;

public class Main {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
int m = scanner.nextInt();
int sum = 0;
int[][] vec = new int[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
vec[i][j] = scanner.nextInt();
sum += vec[i][j];
}
}

int result = Integer.MAX_VALUE;
int count = 0; // 统计遍历过的行

// 行切分
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
count += vec[i][j];
// 遍历到行末尾时候开始统计
if (j == m - 1) {
result = Math.min(result, Math.abs(sum - 2 * count));
}
}
}

count = 0;
// 列切分
for (int j = 0; j < m; j++) {
for (int i = 0; i < n; i++) {
count += vec[i][j];
// 遍历到列末尾时候开始统计
if (i == n - 1) {
result = Math.min(result, Math.abs(sum - 2 * count));
}
}
}

System.out.println(result);
scanner.close();
}
}

第二章 链表

1、链表理论基础

链表理论基础
什么是链表,链表是一种通过指针串联在一起的线性结构,每一个节点由两部分组成,一个是数据域一个是指针域(存放指向下一个节点的指针),最后一个节点的指针域指向null(空指针的意思)。
链表的入口节点称为链表的头结点也就是head。
如图所示:

image-20250701091304213

链表的类型

接下来说一下链表的几种类型:

单链表

刚刚说的就是单链表。

双链表

单链表中的指针域只能指向节点的下一个节点。

双链表:每一个节点有两个指针域,一个指向下一个节点,一个指向上一个节点。

双链表 既可以向前查询也可以向后查询。

如图所示: 链表2

循环链表

循环链表,顾名思义,就是链表首尾相连。

循环链表可以用来解决约瑟夫环问题。

链表4

链表的存储方式

了解完链表的类型,再来说一说链表在内存中的存储方式。

数组是在内存中是连续分布的,但是链表在内存中可不是连续分布的。

链表是通过指针域的指针链接在内存中各个节点。

所以链表中的节点在内存中不是连续分布的 ,而是散乱分布在内存中的某地址上,分配机制取决于操作系统的内存管理。

如图所示:

链表3

这个链表起始节点为2, 终止节点为7, 各个节点分布在内存的不同地址空间上,通过指针串联在一起。

链表的定义

接下来说一说链表的定义。

链表节点的定义,很多同学在面试的时候都写不好。

这是因为平时在刷leetcode的时候,链表的节点都默认定义好了,直接用就行了,所以同学们都没有注意到链表的节点是如何定义的。

而在面试的时候,一旦要自己手写链表,就写的错漏百出。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class ListNode {
// 结点的值
int val;

// 下一个结点
ListNode next;

// 节点的构造函数(无参)
public ListNode() {
}

// 节点的构造函数(有一个参数)
public ListNode(int val) {
this.val = val;
}

// 节点的构造函数(有两个参数)
public ListNode(int val, ListNode next) {
this.val = val;
this.next = next;
}
}

所以如果不定义构造函数使用默认构造函数的话,在初始化的时候就不能直接给变量赋值!

链表的操作

删除节点

删除D节点,如图所示:

链表-删除节点

只要将C节点的next指针 指向E节点就可以了。

那有同学说了,D节点不是依然存留在内存里么?只不过是没有在这个链表里而已。

是这样的,所以在C++里最好是再手动释放这个D节点,释放这块内存。

其他语言例如Java、Python,就有自己的内存回收机制,就不用自己手动释放了。

添加节点

如图所示:

链表-添加节点

可以看出链表的增添和删除都是O(1)操作,也不会影响到其他节点。

但是要注意,要是删除第五个节点,需要从头节点查找到第四个节点通过next指针进行删除操作,查找的时间复杂度是O(n)。

性能分析

再把链表的特性和数组的特性进行一个对比,如图所示:

链表-链表与数据性能对比

数组在定义的时候,长度就是固定的,如果想改动数组的长度,就需要重新定义一个新的数组。

链表的长度可以是不固定的,并且可以动态增删, 适合数据量不固定,频繁增删,较少查询的场景。

2、移除链表元素

203. 移除链表元素 - 力扣(LeetCode)

题意:删除链表中等于给定值 val 的所有节点。

示例 1: 输入:head = [1,2,6,3,4,5,6], val = 6 输出:[1,2,3,4,5]

示例 2: 输入:head = [], val = 1 输出:[]

示例 3: 输入:head = [7,7,7,7], val = 7 输出:[]

思路

这里以链表 1 4 2 4 来举例,移除元素4。

203_链表删除元素1

当然如果使用java ,python的话就不用手动管理内存了。

这种情况下的移除操作,就是让节点next指针直接指向下下一个节点就可以了,

那么因为单链表的特殊性,只能指向下一个节点,刚刚删除的是链表的中第二个,和第四个节点,那么如果删除的是头结点又该怎么办呢?

这里就涉及如下链表操作的两种方式:

  • 直接使用原来的链表来进行删除操作。
  • 设置一个虚拟头结点在进行删除操作。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public ListNode removeElements(ListNode head, int val) {
// 创建一个哑节点,指向头节点
ListNode dummy = new ListNode(0, head);
ListNode cur = dummy; // cur 从哑节点开始

// 遍历链表
while (cur.next != null) {
if (cur.next.val == val) {
// 如果下一个节点的值等于 val,跳过该节点
cur.next = cur.next.next;
} else {
// 否则,移动到下一个节点
cur = cur.next;
}
}

// 返回哑节点的下一个节点(即新链表的头节点)
return dummy.next;
}
}

3、设计链表

707. 设计链表 - 力扣(LeetCode)

在链表类中实现这些功能:

  • get(index):获取链表中第 index 个节点的值。如果索引无效,则返回-1。
  • addAtHead(val):在链表的第一个元素之前添加一个值为 val 的节点。插入后,新节点将成为链表的第一个节点。
  • addAtTail(val):将值为 val 的节点追加到链表的最后一个元素。
  • addAtIndex(index,val):在链表中的第 index 个节点之前添加值为 val 的节点。如果 index 等于链表的长度,则该节点将附加到链表的末尾。如果 index 大于链表长度,则不会插入节点。如果index小于0,则在头部插入节点。
  • deleteAtIndex(index):如果索引 index 有效,则删除链表中的第 index 个节点。

707示例

删除链表节点: 链表-删除节点

添加链表节点: 链表-添加节点

这道题目设计链表的五个接口:

  • 获取链表第index个节点的数值
  • 在链表的最前面插入一个节点
  • 在链表的最后面插入一个节点
  • 在链表第index个节点前面插入一个节点
  • 删除链表的第index个节点

可以说这五个接口,已经覆盖了链表的常见操作,是练习链表操作非常好的一道题目

链表操作的两种方式:

  1. 直接使用原来的链表来进行操作。
  2. 设置一个虚拟头结点在进行操作。

单链表

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
//单链表
class MyLinkedList {

class ListNode {
int val;
ListNode next;
ListNode(int val) {
this.val=val;
}
}
//size存储链表元素的个数
private int size;
//注意这里记录的是虚拟头结点
private ListNode head;

//初始化链表
public MyLinkedList() {
this.size = 0;
this.head = new ListNode(0);
}

//获取第index个节点的数值,注意index是从0开始的,第0个节点就是虚拟头结点
public int get(int index) {
//如果index非法,返回-1
if (index < 0 || index >= size) {
return -1;
}
ListNode cur = head;
//第0个节点是虚拟头节点,所以查找第 index+1 个节点
for (int i = 0; i <= index; i++) {
cur = cur.next;
}
return cur.val;
}

public void addAtHead(int val) {
ListNode newNode = new ListNode(val);
newNode.next = head.next;
head.next = newNode;
size++;

// 在链表最前面插入一个节点,等价于在第0个元素前添加
// addAtIndex(0, val);
}


public void addAtTail(int val) {
ListNode newNode = new ListNode(val);
ListNode cur = head;
while (cur.next != null) {
cur = cur.next;
}
cur.next = newNode;
size++;

// 在链表的最后插入一个节点,等价于在(末尾+1)个元素前添加
// addAtIndex(size, val);
}

// 在第 index 个节点之前插入一个新节点,例如index为0,那么新插入的节点为链表的新头节点。
// 如果 index 等于链表的长度,则说明是新插入的节点为链表的尾结点
// 如果 index 大于链表的长度,则返回空
public void addAtIndex(int index, int val) {
if (index < 0 || index > size) {
return;
}

//找到要插入节点的前驱
ListNode pre = head;
for (int i = 0; i < index; i++) {
pre = pre.next;
}
ListNode newNode = new ListNode(val);
newNode.next = pre.next;
pre.next = newNode;
size++;
}

public void deleteAtIndex(int index) {
if (index < 0 || index >= size) {
return;
}

//因为有虚拟头节点,所以不用对index=0的情况进行特殊处理
ListNode pre = head;
for (int i = 0; i < index ; i++) {
pre = pre.next;
}
pre.next = pre.next.next;
size--;
}
}

双链表

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
//双链表
class MyLinkedList {

class ListNode{
int val;
ListNode next, prev;
ListNode(int val){
this.val = val;
}
}

//记录链表中元素的数量
private int size;
//记录链表的虚拟头结点和尾结点
private ListNode head, tail;

public MyLinkedList() {
//初始化操作
this.size = 0;
this.head = new ListNode(0);
this.tail = new ListNode(0);
//这一步非常关键,否则在加入头结点的操作中会出现null.next的错误!!!
this.head.next = tail;
this.tail.prev = head;
}

public int get(int index) {
//判断index是否有效
if(index < 0 || index >= size){
return -1;
}
ListNode cur = head;
//判断是哪一边遍历时间更短
if(index >= size / 2){
//tail开始
cur = tail;
for(int i = 0; i < size - index; i++){
cur = cur.prev;
}
}else{
for(int i = 0; i <= index; i++){
cur = cur.next;
}
}
return cur.val;
}

public void addAtHead(int val) {
//等价于在第0个元素前添加
addAtIndex(0, val);
}

public void addAtTail(int val) {
//等价于在最后一个元素(null)前添加
addAtIndex(size, val);
}

public void addAtIndex(int index, int val) {
//判断index是否有效
if(index < 0 || index > size){
return;
}

//找到前驱
ListNode pre = head;
for(int i = 0; i < index; i++){
pre = pre.next;
}
//新建结点
ListNode newNode = new ListNode(val);
newNode.next = pre.next;
pre.next.prev = newNode;
newNode.prev = pre;
pre.next = newNode;
size++;

}

public void deleteAtIndex(int index) {
//判断index是否有效
if(index < 0 || index >= size){
return;
}

//删除操作
ListNode pre = head;
for(int i = 0; i < index; i++){
pre = pre.next;
}
pre.next.next.prev = pre;
pre.next = pre.next.next;
size--;
}
}

/**
* Your MyLinkedList object will be instantiated and called as such:
* MyLinkedList obj = new MyLinkedList();
* int param_1 = obj.get(index);
* obj.addAtHead(val);
* obj.addAtTail(val);
* obj.addAtIndex(index,val);
* obj.deleteAtIndex(index);
*/

第三章 哈希表

1、哈希表理论基础

首先什么是哈希表,哈希表(英文名字为Hash table,国内也有一些算法书籍翻译为散列表,大家看到这两个名称知道都是指hash table就可以了)。

哈希表是根据关键码的值而直接进行访问的数据结构。

这么官方的解释可能有点懵,其实直白来讲其实数组就是一张哈希表。

哈希表中关键码就是数组的索引下标,然后通过下标直接访问数组中的元素,如下图所示:

哈希表1

那么哈希表能解决什么问题呢,一般哈希表都是用来快速判断一个元素是否出现集合里。

例如要查询一个名字是否在这所学校里。

要枚举的话时间复杂度是O(n),但如果使用哈希表的话, 只需要O(1)就可以做到。

我们只需要初始化把这所学校里学生的名字都存在哈希表里,在查询的时候通过索引直接就可以知道这位同学在不在这所学校里了。

将学生姓名映射到哈希表上就涉及到了hash function ,也就是哈希函数。

哈希函数

哈希函数,把学生的姓名直接映射为哈希表上的索引,然后就可以通过查询索引下标快速知道这位同学是否在这所学校里了。

哈希函数如下图所示,通过hashCode把名字转化为数值,一般hashcode是通过特定编码方式,可以将其他数据格式转化为不同的数值,这样就把学生名字映射为哈希表上的索引数字了。

哈希表2

如果hashCode得到的数值大于 哈希表的大小了,也就是大于tableSize了,怎么办呢?

此时为了保证映射出来的索引数值都落在哈希表上,我们会在再次对数值做一个取模的操作,这样我们就保证了学生姓名一定可以映射到哈希表上了。

此时问题又来了,哈希表我们刚刚说过,就是一个数组。

如果学生的数量大于哈希表的大小怎么办,此时就算哈希函数计算的再均匀,也避免不了会有几位学生的名字同时映射到哈希表 同一个索引下标的位置。

接下来哈希碰撞登场

哈希碰撞

如图所示,小李和小王都映射到了索引下标 1 的位置,这一现象叫做哈希碰撞。

哈希表3

一般哈希碰撞有两种解决方法, 拉链法和线性探测法。

拉链法

刚刚小李和小王在索引1的位置发生了冲突,发生冲突的元素都被存储在链表中。 这样我们就可以通过索引找到小李和小王了

哈希表4

(数据规模是dataSize, 哈希表的大小为tableSize)

其实拉链法就是要选择适当的哈希表的大小,这样既不会因为数组空值而浪费大量内存,也不会因为链表太长而在查找上浪费太多时间。

线性探测法

使用线性探测法,一定要保证tableSize大于dataSize。 我们需要依靠哈希表中的空位来解决碰撞问题。

例如冲突的位置,放了小李,那么就向下找一个空位放置小王的信息。所以要求tableSize一定要大于dataSize ,要不然哈希表上就没有空置的位置来存放 冲突的数据了。如图所示:

哈希表5

其实关于哈希碰撞还有非常多的细节,感兴趣的同学可以再好好研究一下,这里我就不再赘述了。

常见的三种哈希结构

当我们想使用哈希法来解决问题的时候,我们一般会选择如下三种数据结构。

  • 数组
  • set (集合)
  • map(映射)

这里数组就没啥可说的了,我们来看一下set。

在 Java 中,Set 和 Map 分别提供以下三种数据结构,其底层实现以及优劣如下表所示:

Set 集合(无序、不重复

集合 底层实现 是否有序 元素是否可以重复 能否更改元素 查询效率 增删效率
HashSet 哈希表(Hash Table) 无序 否 否(不可变 key) O(1) 平均
O(n) 最坏
O(1) 平均
O(n) 最坏
LinkedHashSet 哈希表 + 双向链表 插入有序 否 否 O(1) O(1)
TreeSet 红黑树(Red-Black Tree) 自然有序 / 自定义排序 否 否 O(log n) O(log n)

📌 说明:

  • HashSet 是基于哈希表实现,性能最优,适用于大多数去重场景。
  • LinkedHashSet 在 HashSet 基础上维护插入顺序,适合需要遍历顺序一致的场景。
  • TreeSet 基于红黑树,元素自动排序,但性能略低,适合需要有序集合的场景。

Map 映射(key-value 结构)

映射 底层实现 是否有序 key 是否可重复 能否更改 key 查询效率 增删效率
HashMap 哈希表(数组 + 链表/红黑树) 无序 key 不可重复 否(key 不可变) O(1) 平均
O(n) 最坏
O(1) 平均
O(n) 最坏
LinkedHashMap 哈希表 + 双向链表 插入有序 / 访问有序 key 不可重复 否 O(1) O(1)
TreeMap 红黑树(Red-Black Tree) key 自然有序 / 自定义排序 key 不可重复 否 O(log n) O(log n)

📌 说明:

  • HashMap 是最常用的映射结构,性能高,适用于大多数 key-value 存储场景。
  • LinkedHashMap 可以保持插入顺序或访问顺序(LRU 缓存常用)。
  • TreeMap key 有序,支持范围查询(如 subMap, headMap),适合需要排序的场景。

Java 容器底层原理与使用建议

  • HashMap 和 HashSet 的底层都是基于 哈希表 实现,HashSet 实际上是封装了 HashMap(value 存一个 PRESENT 哑对象)。
  • TreeMap 和 TreeSet 基于 红黑树(自平衡二叉搜索树),保证 key 有序,但操作复杂度为 O(log n)。
  • LinkedHashMap 和 LinkedHashSet 在哈希结构基础上增加双向链表维护顺序,空间略大,但顺序可控。
  • 所有 map/set 中的 key 都不应被修改,否则会破坏哈希分布或树结构,导致无法查找。Java 中通常使用不可变对象(如 String、Integer)作为 key。

总结

总结一下,当我们遇到了要快速判断一个元素是否出现集合里的时候,就要考虑哈希法。

但是哈希法也是牺牲了空间换取了时间,因为我们要使用额外的数组,set或者是map来存放数据,才能实现快速的查找。

如果在做面试题目的时候遇到需要判断一个元素是否出现过的场景也应该第一时间想到哈希法!

2、有效的字母异位词

给定两个字符串 s 和 t ,编写一个函数来判断 t 是否是 s 的 字母异位词(字母个数和类型不变只是位置变了)

示例 1:

1
2
输入: s = "anagram", t = "nagaram"
输出: true

示例 2:

1
2
输入: s = "rat", t = "car"
输出: false

提示:

  • 1 <= s.length, t.length <= 5 * 104
  • s 和 t 仅包含小写字母

思路一(暴力)

两层for循环,同时记录字符是否重复出现。

思路二

数组其实就是一个简单的哈希表,而且这道题目中字符串只有小写字符,那么就可以定义一个数组,来记录字符串s里字符出现的次数。

需要定义一个多大的数组呢,定一个数组叫做record,大小为26 就可以了,初始化为0,因为字符a到字符z的ASCII也是26个连续的数值。

为了方便举例,判断一下字符串s= “aee”, t = “eae”。

image-20250630162338362

这里aee遍历完之后的数组是这样的。

需要把字符映射到数组也就是哈希表的索引下标上,因为字符a到字符z的ASCII是26个连续的数值,所以字符a映射为下标0,相应的字符z映射为下标25。

再遍历 字符串s的时候,只需要将 s[i] - ‘a’ 所在的元素做+1 操作即可,并不需要记住字符a的ASCII,只要求出一个相对数值就可以了。 这样就将字符串s中字符出现的次数,统计出来了。

那看一下如何检查字符串t中是否出现了这些字符,同样在遍历字符串t的时候,对t中出现的字符映射哈希表索引上的数值再做-1的操作。

那么最后检查一下,record数组如果有的元素不为零0,说明字符串s和t一定是谁多了字符或者谁少了字符,return false。

最后如果record数组所有元素都为零0,说明字符串s和t是字母异位词,return true。

时间复杂度为O(n),空间上因为定义是的一个常量大小的辅助数组,所以空间复杂度为O(1)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public boolean isAnagram(String s, String t) {
int[] record = new int[26];

for(int i = 0 ; i < s.length() ; i++){
record[s.charAt(i) - 'a']++;
}

for(int i = 0 ; i < t.length() ; i++){
record[t.charAt(i) - 'a']--;
}

for(int count : record){
if(count != 0){
return false;
}
}
return true;
}
}

相关题目

3、两个数组的交集

给定两个数组 nums1 和 nums2 ,返回 它们的 交集 。输出结果中的每个元素一定是 唯一 的。我们可以 不考虑输出结果的顺序 。

示例 1:

1
2
输入:nums1 = [1,2,2,1], nums2 = [2,2]
输出:[2]

示例 2:

1
2
3
输入:nums1 = [4,9,5], nums2 = [9,4,9,8,4]
输出:[9,4]
解释:[4,9] 也是可通过的

提示:

  • 1 <= nums1.length, nums2.length <= 1000
  • 0 <= nums1[i], nums2[i] <= 1000

思路一(暴力)

思路二(利用哈希中的set)

这道题目,主要要学会使用一种哈希数据结构:unordered_set,这个数据结构可以解决很多类似的问题。

注意题目特意说明:输出结果中的每个元素一定是唯一的,也就是说输出的结果的去重的, 同时可以不考虑输出结果的顺序

这道题用暴力的解法时间复杂度是O(n^2),那来看看使用哈希法进一步优化。

那么用数组来做哈希表也是不错的选择,例如242. 有效的字母异位词(opens new window)

但是要注意,使用数组来做哈希的题目,是因为题目都限制了数值的大小。

而这道题目没有限制数值的大小,就无法使用数组来做哈希表了。

而且如果哈希值比较少、特别分散、跨度非常大,使用数组就造成空间的极大浪费。

此时就要使用另一种结构体了,set

思路如图所示:

image-20250630165211920

拓展

那有同学可能问了,遇到哈希问题我直接都用set不就得了,用什么数组啊。

直接使用set 不仅占用空间比数组大,而且速度要比数组慢,set把数值映射到key上都要做hash计算的。

不要小瞧 这个耗时,在数据量大的情况,差距是很明显的。

后记

本题后面 力扣改了 题目描述 和 后台测试数据,增添了 数值范围:

  • 1 <= nums1.length, nums2.length <= 1000
  • 0 <= nums1[i], nums2[i] <= 1000

所以就可以 使用数组来做哈希表了, 因为数组都是 1000以内的。

版本一:使用HashSet
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
public int[] intersect(int[] nums1, int[] nums2) {
if(nums1 == null || nums2 == null || nums1.length == 0 || nums2.length == 0){
return null;
}
Set<Integer> set1 = new HashSet<>();
Set<Integer> resSet = new HashSet<>();
for(int i : nums1){
set1.add(i);
}

for(int i : nums2){
if(set1.contains(i)){
resSet.add(i);
}
}

int[] arr = new int[resSet.size()];
int j = 0;
for(int i : resSet){
arr[j++] = i;
}
return arr;
}
}
版本二:使用Hash数组
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
public int[] intersection(int[] nums1, int[] nums2) {
int[] hash1 = new int[1002];
int[] hash2 = new int[1002];

for(int i : nums1){
hash1[i]++;
}
for(int i : nums2){
hash2[i]++;
}
List<Integer> resList = new ArrayList<>();
for(int i = 0 ; i < 1002 ; i++){
if(hash1[i] > 0 && hash2[i] > 0){
resList.add(i);
}
}
int index = 0;
int res[] = new int[resList.size()];
for(int i : resList){
res[index++] = i;
}
return res;
}
}

相关题目

350.两个数组的交集 II

4、快乐数

202. 快乐数 - 力扣(LeetCode)

编写一个算法来判断一个数 n 是不是快乐数。

「快乐数」定义为:对于一个正整数,每一次将该数替换为它每个位置上的数字的平方和,然后重复这个过程直到这个数变为 1,也可能是 无限循环 但始终变不到 1。如果 可以变为 1,那么这个数就是快乐数。

如果 n 是快乐数就返回 True ;不是,则返回 False 。

示例:

输入:19
输出:true
解释:
1^2 + 9^2 = 82
8^2 + 2^2 = 68
6^2 + 8^2 = 100
1^2 + 0^2 + 0^2 = 1

思路

这道题目看上去貌似一道数学问题,其实并不是!

题目中说了会 无限循环,那么也就是说求和的过程中,sum会重复出现,这对解题很重要!

所以这道题目使用哈希法,来判断这个sum是否重复出现,如果重复了就是return false, 否则一直找到sum为1为止。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public boolean isHappy(int n) {
Set<Integer> set = new HashSet<>();
while(n != 1 && !set.contains(n)){
set.add(n);
n = getNumber(n);
}
return n == 1;
}

public Integer getNumber(int n){
int sum = 0;
while(n > 0){
int temp = n % 10;
sum += temp * temp;
n /= 10;
}
return sum;
}
}

5、两数之和

1. 两数之和 - 力扣(LeetCode)

给定一个整数数组 nums 和一个目标值 target,请你在该数组中找出和为目标值的那 两个 整数,并返回他们的数组下标。

你可以假设每种输入只会对应一个答案。但是,数组中同一个元素不能使用两遍。

示例:

给定 nums = [2, 7, 11, 15], target = 9

因为 nums[0] + nums[1] = 2 + 7 = 9

所以返回 [0, 1]

思路

首先我再强调一下 什么时候使用哈希法,当我们需要查询一个元素是否出现过,或者一个元素是否在集合里的时候,就要第一时间想到哈希法。

本题呢,我就需要一个集合来存放我们遍历过的元素,然后在遍历数组的时候去询问这个集合,某元素是否遍历过,也就是 是否出现在这个集合。

那么我们就应该想到使用哈希法了。

因为本题,我们不仅要知道元素有没有遍历过,还要知道这个元素对应的下标,需要使用 key value结构来存放,key来存元素,value来存下标,那么使用map正合适。

再来看一下使用数组和set来做哈希法的局限。

  • 数组的大小是受限制的,而且如果元素很少,而哈希值太大会造成内存空间的浪费。
  • set是一个集合,里面放的元素只能是一个key,而两数之和这道题目,不仅要判断y是否存在而且还要记录y的下标位置,因为要返回x 和 y的下标。所以set 也不能用。

此时就要选择另一种数据结构:map ,map是一种key value的存储结构,可以用key保存数值,用value再保存数值所在的下标。

接下来需要明确两点:

  • map用来做什么
  • map中key和value分别表示什么

map目的用来存放我们访问过的元素,因为遍历数组的时候,需要记录我们之前遍历过哪些元素和对应的下标,这样才能找到与当前元素相匹配的(也就是相加等于target)

接下来是map中key和value分别表示什么。

这道题 我们需要 给出一个元素,判断这个元素是否出现过,如果出现过,返回这个元素的下标。

那么判断元素是否出现,这个元素就要作为key,所以数组中的元素作为key,有key对应的就是value,value用来存下标。

所以 map中的存储结构为 {key:数据元素,value:数组元素对应的下标}。

在遍历数组的时候,只需要向map去查询是否有和目前遍历元素匹配的数值,如果有,就找到的匹配对,如果没有,就把目前遍历的元素放进map中,因为map存放的就是我们访问过的元素。

过程如下:

image-20250701090334823

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Solution {
public int[] twoSum(int[] nums, int target) {
int[] res = new int[2];
Map<Integer,Integer> numsMap = new HashMap<>();
for(int i = 0 ; i < nums.length ; i++){

if(numsMap.containsKey(target - nums[i])){
res[0] = i;
res[1] = numsMap.get(target - nums[i]);
break;
}
numsMap.put(nums[i],i);
}
return res;
}
}

6、四数相加二

454. 四数相加 II - 力扣(LeetCode)

给定四个包含整数的数组列表 A , B , C , D ,计算有多少个元组 (i, j, k, l) ,使得 A[i] + B[j] + C[k] + D[l] = 0。

为了使问题简单化,所有的 A, B, C, D 具有相同的长度 N,且 0 ≤ N ≤ 500 。所有整数的范围在 -2^28 到 2^28 - 1 之间,最终结果不会超过 2^31 - 1 。

例如:

输入:

  • A = [ 1, 2]
  • B = [-2,-1]
  • C = [-1, 2]
  • D = [ 0, 2]

输出:

2

解释:

两个元组如下:

  1. (0, 0, 0, 1) -> A[0] + B[0] + C[0] + D[1] = 1 + (-2) + (-1) + 2 = 0
  2. (1, 1, 0, 0) -> A[1] + B[1] + C[0] + D[0] = 2 + (-1) + (-1) + 0 = 0

这道题目是四个独立的数组,只要找到A[i] + B[j] + C[k] + D[l] = 0就可以,不用考虑有重复的四个元素相加等于0的情况,所以相对于题目18. 四数之和,题目15.三数之和,还是简单了不少!

如果本题想难度升级:就是给出一个数组(而不是四个数组),在这里找出四个元素相加等于0,答案中不可以包含重复的四元组,大家可以思考一下,后续的文章我也会讲到的。

本题解题步骤:

  1. 首先定义 一个map,key放a和b两数之和,value 放a和b两数之和出现的次数。
  2. 遍历大A和大B数组,统计两个数组元素之和,和出现的次数,放到map中。
  3. 定义int变量count,用来统计 a+b+c+d = 0 出现的次数。
  4. 再遍历大C和大D数组,找到如果 0-(c+d) 在map中出现过的话,就用count把map中key对应的value也就是出现次数统计出来。
  5. 最后返回统计值 count 就可以了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution {
public int fourSumCount(int[] nums1, int[] nums2, int[] nums3, int[] nums4) {
Map<Integer,Integer> nums12 = new HashMap<>();
int res = 0;
for(int i : nums1){
for(int j : nums2){
if(nums12.containsKey(i + j)){
nums12.put(i + j,nums12.get(i + j) + 1);
}else{
nums12.put(i + j,1);
}

}
}
for(int i : nums3){
for(int j : nums4){
if(nums12.containsKey(-(i + j))){
res += nums12.get(-(i+j));
}
}
}
return res;
}
}

7、赎金信

383. 赎金信 - 力扣(LeetCode)

给定一个赎金信 (ransom) 字符串和一个杂志(magazine)字符串,判断第一个字符串 ransom 能不能由第二个字符串 magazines 里面的字符构成。如果可以构成,返回 true ;否则返回 false。

(题目说明:为了不暴露赎金信字迹,要从杂志上搜索各个需要的字母,组成单词来表达意思。杂志字符串中的每个字符只能在赎金信字符串中使用一次。)

注意:

你可以假设两个字符串均只含有小写字母。

canConstruct(“a”, “b”) -> false
canConstruct(“aa”, “ab”) -> false
canConstruct(“aa”, “aab”) -> true

思路

思路一:暴力循环枚举
思路二:哈希解法

因为题目说只有小写字母,那可以采用空间换取时间的哈希策略,用一个长度为26的数组来记录magazine里字母出现的次数。

然后再用ransomNote去验证这个数组是否包含了ransomNote所需要的所有字母。

依然是数组在哈希法中的应用。

一些同学可能想,用数组干啥,都用map完事了,其实在本题的情况下,使用map的空间消耗要比数组大一些的,因为map要维护红黑树或者哈希表,而且还要做哈希函数,是费时的!数据量大的话就能体现出来差别了。 所以数组更加简单直接有效!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution {
public boolean canConstruct(String ransomNote, String magazine) {
// shortcut
if (ransomNote.length() > magazine.length()) {
return false;
}
// 定义一个哈希映射数组
int[] record = new int[26];

// 遍历
for(char c : magazine.toCharArray()){
record[c - 'a'] += 1;
}

for(char c : ransomNote.toCharArray()){
record[c - 'a'] -= 1;
}

// 如果数组中存在负数,说明ransomNote字符串中存在magazine中没有的字符
for(int i : record){
if(i < 0){
return false;
}
}

return true;
}
}

8、三数之和

15. 三数之和 - 力扣(LeetCode)

给你一个包含 n 个整数的数组 nums,判断 nums 中是否存在三个元素 a,b,c ,使得 a + b + c = 0 ?请你找出所有满足条件且不重复的三元组。

注意: 答案中不可以包含重复的三元组。

示例:

给定数组 nums = [-1, 0, 1, 2, -1, -4],

满足要求的三元组集合为: [ [-1, 0, 1], [-1, -1, 2] ]

思路

思路一:双指针法

先让数组排序,然后左指针指向循环的下一个,右指针指向数组尾,然后等到左指针和右指针相遇一个遍历结束。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43

class Solution {
public List<List<Integer>> threeSum(int[] nums) {
List<List<Integer>> res = new ArrayList<>();
if (nums == null || nums.length < 3) return res;

// 排序是双指针法的基础
Arrays.sort(nums);

for (int i = 0; i < nums.length - 2; i++) {
// 去重:如果当前值大于0,后面不可能有解
if (nums[i] > 0) break;

// 去重:跳过相同的 nums[i]
if (i > 0 && nums[i] == nums[i - 1]) continue;

int left = i + 1;
int right = nums.length - 1;

while (left < right) {
int sum = nums[i] + nums[left] + nums[right];

if (sum == 0) {
res.add(Arrays.asList(nums[i], nums[left], nums[right]));

// 去重:跳过相同的 nums[left]
while (left < right && nums[left] == nums[left + 1]) left++;
// 去重:跳过相同的 nums[right]
while (left < right && nums[right] == nums[right - 1]) right--;

left++;
right--;
} else if (sum < 0) {
left++;
} else {
right--;
}
}
}

return res;
}
}

为什么要去重?
题目要求返回 所有不重复的三元组,例如:如果数组是 [-1, -1, 0, 1],那么 [ -1, 0, 1 ] 出现两次是不允许的。即使它们顺序不同,但元素相同,也视为重复。所以我们在遍历过程中必须避免生成重复的三元组。

去重的三大关键点
外层循环中跳过相同的第一个数(nums[i])

1
if (i > 0 && nums[i] == nums[i - 1]) continue;

解释:当前值 nums[i] 和上一个值 nums[i - 1] 相同,说明如果继续计算下去会得到重复的三元组。
所以我们跳过当前这个值。
示例:数组排序后为:[-1, -1, 0, 1]

第一次 i = 0 时处理了 [-1, 0, 1]
i = 1 时发现 nums[1] == nums[0],直接跳过,避免重复
在找到一个解后,跳过相同的 left 值

1
while (left < right && nums[left] == nums[left + 1]) left++;

解释:此时找到了一个三元组满足条件(和为0),但可能还有多个 left 指向相同的值。
为了避免后续再次选到同样的组合,要跳过这些重复值。
同样地,跳过相同的 right 值

1
while (left < right && nums[right] == nums[right - 1]) right--;

解释:类似上面的逻辑,跳过右边重复的值,防止产生重复的三元组。

思路二:哈希法

思路一样只是实现方式变成了用哈希表

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
class Solution {
public List<List<Integer>> threeSum(int[] nums) {
List<List<Integer>> result = new ArrayList<>();
Arrays.sort(nums);

for (int i = 0; i < nums.length; i++) {
// 如果第一个元素大于零,不可能凑成三元组
if (nums[i] > 0) {
return result;
}
// 三元组元素a去重
if (i > 0 && nums[i] == nums[i - 1]) {
continue;
}

HashSet<Integer> set = new HashSet<>();
for (int j = i + 1; j < nums.length; j++) {
// 三元组元素b去重
if (j > i + 2 && nums[j] == nums[j - 1] && nums[j - 1] == nums[j - 2]) {
continue;
}

int c = -nums[i] - nums[j];
if (set.contains(c)) {
result.add(Arrays.asList(nums[i], nums[j], c));
set.remove(c); // 三元组元素c去重
} else {
set.add(nums[j]);
}
}
}
return result;
}
}

9、四数之和

18. 四数之和 - 力扣(LeetCode)

给你一个由 n 个整数组成的数组 nums ,和一个目标值 target 。请你找出并返回满足下述全部条件且不重复的四元组 [nums[a], nums[b], nums[c], nums[d]] (若两个四元组元素一一对应,则认为两个四元组重复):

  • 0 <= a, b, c, d < n
  • a、b、c 和 d 互不相同
  • nums[a] + nums[b] + nums[c] + nums[d] == target

你可以按 任意顺序 返回答案 。

示例 1:

1
2
输入:nums = [1,0,-1,0,-2,2], target = 0
输出:[[-2,-1,1,2],[-2,0,0,2],[-1,0,0,1]]

示例 2:

1
2
输入:nums = [2,2,2,2,2], target = 8
输出:[[2,2,2,2]]

提示:

  • 1 <= nums.length <= 200
  • -109 <= nums[i] <= 109
  • -109 <= target <= 109

这种问题还是使用双指针法,思路跟之前一样重要的是剪枝操作和加了个循环

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
public class Solution {
public List<List<Integer>> fourSum(int[] nums, int target) {
Arrays.sort(nums); // 排序数组
List<List<Integer>> result = new ArrayList<>(); // 结果集
for (int k = 0; k < nums.length; k++) {
// 剪枝处理
if (nums[k] > target && nums[k] >= 0) {
break; // 此处的break可以等价于return result;
}
// 对nums[k]去重
if (k > 0 && nums[k] == nums[k - 1]) {
continue;
}
for (int i = k + 1; i < nums.length; i++) {
// 第二级剪枝
if (nums[k] + nums[i] > target && nums[k] + nums[i] >= 0) {
break; // 注意是break到上一级for循环,如果直接return result;会有遗漏
}
// 对nums[i]去重
if (i > k + 1 && nums[i] == nums[i - 1]) {
continue;
}
int left = i + 1;
int right = nums.length - 1;
while (right > left) {
long sum = (long) nums[k] + nums[i] + nums[left] + nums[right];
if (sum > target) {
right--;
} else if (sum < target) {
left++;
} else {
result.add(Arrays.asList(nums[k], nums[i], nums[left], nums[right]));
// 对nums[left]和nums[right]去重
while (right > left && nums[right] == nums[right - 1]) right--;
while (right > left && nums[left] == nums[left + 1]) left++;
right--;
left++;
}
}
}
}
return result;
}
}

第四章 字符串

1、反转字符串

344. 反转字符串 - 力扣(LeetCode)

编写一个函数,其作用是将输入的字符串反转过来。输入字符串以字符数组 s 的形式给出。

不要给另外的数组分配额外的空间,你必须原地修改输入数组、使用 O(1) 的额外空间解决这一问题。

示例 1:

1
2
输入:s = ["h","e","l","l","o"]
输出:["o","l","l","e","h"]

示例 2:

1
2
输入:s = ["H","a","n","n","a","h"]
输出:["h","a","n","n","a","H"]

提示:

  • 1 <= s.length <= 105
  • s[i] 都是 ASCII 码表中的可打印字符

思路一:双指针结束了

没啥好讲的双指针交换元素就结束了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Solution {
public void reverseString(char[] s) {
int l = 0;
int r = s.length - 1;
while(l < r){
char temp = s[l];
s[l] = s[r];
s[r] = temp;
l++;
r--;
}
return;
}
}

2、反转字符串2

541. 反转字符串 II - 力扣(LeetCode)

给定一个字符串 s 和一个整数 k,从字符串开头算起,每计数至 2k 个字符,就反转这 2k 字符中的前 k 个字符。

  • 如果剩余字符少于 k 个,则将剩余字符全部反转。
  • 如果剩余字符小于 2k 但大于或等于 k 个,则反转前 k 个字符,其余字符保持原样。

示例 1:

1
2
输入:s = "abcdefg", k = 2
输出:"bacdfeg"

示例 2:

1
2
输入:s = "abcd", k = 2
输出:"bacd"

提示:

  • 1 <= s.length <= 104
  • s 仅由小写英文组成
  • 1 <= k <= 104

思路

这道题目其实也是模拟,实现题目中规定的反转规则就可以了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public String reverseStr(String s, int k) {
char[] ch = s.toCharArray();
for(int i = 0;i < ch.length;i += 2 * k){
int start = i;
// 判断尾数够不够k个来取决end指针的位置,防止越界
int end = Math.min(ch.length - 1,start + k - 1);
while(start < end){

char temp = ch[start];
ch[start] = ch[end];
ch[end] = temp;

start++;
end--;
}
}
return new String(ch);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27

class Solution {
public String reverseStr(String s, int k) {
char[] ch = s.toCharArray();
// 1. 每隔 2k 个字符的前 k 个字符进行反转
for (int i = 0; i< ch.length; i += 2 * k) {
// 2. 剩余字符小于 2k 但大于或等于 k 个,则反转前 k 个字符
if (i + k <= ch.length) {
reverse(ch, i, i + k -1);
continue;
}
// 3. 剩余字符少于 k 个,则将剩余字符全部反转
reverse(ch, i, ch.length - 1);
}
return new String(ch);

}
// 定义翻转函数
public void reverse(char[] ch, int i, int j) {
for (; i < j; i++, j--) {
char temp = ch[i];
ch[i] = ch[j];
ch[j] = temp;
}

}
}

3、替换数字

54. 替换数字(第八期模拟笔试)

题目描述

给定一个字符串 s,它包含小写字母和数字字符,请编写一个函数,将字符串中的字母字符保持不变,而将每个数字字符替换为number。 例如,对于输入字符串 “a1b2c3”,函数应该将其转换为 “anumberbnumbercnumber”。

输入描述

输入一个字符串 s,s 仅包含小写字母和数字字符。

输出描述

打印一个新的字符串,其中每个数字字符都被替换为了number

输入示例

1
a1b2c3

输出示例

1
anumberbnumbercnumber

提示信息

数据范围:
1 <= s.length < 10000。

思路

首先扩充数组到每个数字字符替换成 “number” 之后的大小。

例如 字符串 “a5b” 的长度为3,那么 将 数字字符变成字符串 “number” 之后的字符串为 “anumberb” 长度为 8。

如图:

img

然后从后向前替换数字字符,也就是双指针法,过程如下:i指向新长度的末尾,j指向旧长度的末尾。

img

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
import java.util.*;
import java.io.*;

public class Main{
public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

String line;
while( (line = br.readLine() )!= null){
char[] s = line.toCharArray();
char[] res = replace(s);
for(char c : res){
out.print(c);
}
out.println();
}
out.flush();
out.close();
}
public static char[] replace(char[] s){
int len = s.length;
int numLen = 0;
for(char c : s){
if(c >= '0' && c <= '9'){
numLen++;
}
}
int newLen = len - numLen + numLen * 6;
char[] newChar = new char[newLen];
int i = len - 1;
int j = newLen - 1;
while(i >= 0){
if(s[i] >= '0' && s[i] <= '9'){
newChar[j--] = 'r';
newChar[j--] = 'e';
newChar[j--] = 'b';
newChar[j--] = 'm';
newChar[j--] = 'u';
newChar[j--] = 'n';
i--;
}else{
newChar[j--] = s[i--];
}
}
return newChar;
}
}

扩展

4、翻转字符串里的单词

151. 反转字符串中的单词 - 力扣(LeetCode)

给你一个字符串 s ,请你反转字符串中 单词 的顺序。

单词 是由非空格字符组成的字符串。s 中使用至少一个空格将字符串中的 单词 分隔开。

返回 单词 顺序颠倒且 单词 之间用单个空格连接的结果字符串。

注意:输入字符串 s中可能会存在前导空格、尾随空格或者单词间的多个空格。返回的结果字符串中,单词间应当仅用单个空格分隔,且不包含任何额外的空格。

示例 1:

1
2
输入:s = "the sky is blue"
输出:"blue is sky the"

示例 2:

1
2
3
输入:s = "  hello world  "
输出:"world hello"
解释:反转后的字符串中不能存在前导空格和尾随空格。

示例 3:

1
2
3
输入:s = "a good   example"
输出:"example good a"
解释:如果两个单词间有多余的空格,反转后的字符串需要将单词间的空格减少到仅有一个。

提示:

  • 1 <= s.length <= 104
  • s 包含英文大小写字母、数字和空格 ' '
  • s 中 至少存在一个 单词

思路

所以这里我还是提高一下本题的难度:不要使用辅助空间,空间复杂度要求为O(1)。

想一下,我们将整个字符串都反转过来,那么单词的顺序指定是倒序了,只不过单词本身也倒序了,那么再把单词反转一下,单词不就正过来了。

所以解题思路如下:

  • 移除多余空格
  • 将整个字符串反转
  • 将每个单词反转

举个例子,源字符串为:”the sky is blue “

  • 移除多余空格 : “the sky is blue”
  • 字符串反转:”eulb si yks eht”
  • 单词反转:”blue is sky the”

这样我们就完成了翻转字符串里的单词。

思路一:使用trim
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public String reverseWords(String s) {
// 去除首尾空格,并按一个或多个空格分割字符串
String[] words = s.trim().split("\\s+");

// 双指针翻转数组
int left = 0;
int right = words.length - 1;

while (left < right) {
String temp = words[left];
words[left] = words[right];
words[right] = temp;
left++;
right--;
}

// 使用 StringBuilder 拼接翻转后的单词
return String.join(" ", words);
}
}
思路二:利用思路中的想法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
class Solution {
/**
* 不使用Java内置方法实现
* <p>
* 1.去除首尾以及中间多余空格
* 2.反转整个字符串
* 3.反转各个单词
*/
public String reverseWords(String s) {
// System.out.println("ReverseWords.reverseWords2() called with: s = [" + s + "]");
// 1.去除首尾以及中间多余空格
StringBuilder sb = removeSpace(s);
// 2.反转整个字符串
reverseString(sb, 0, sb.length() - 1);
// 3.反转各个单词
reverseEachWord(sb);
return sb.toString();
}

private StringBuilder removeSpace(String s) {
// System.out.println("ReverseWords.removeSpace() called with: s = [" + s + "]");
int start = 0;
int end = s.length() - 1;
while (s.charAt(start) == ' ') start++;
while (s.charAt(end) == ' ') end--;
StringBuilder sb = new StringBuilder();
while (start <= end) {
char c = s.charAt(start);
if (c != ' ' || sb.charAt(sb.length() - 1) != ' ') {
sb.append(c);
}
start++;
}
// System.out.println("ReverseWords.removeSpace returned: sb = [" + sb + "]");
return sb;
}

/**
* 反转字符串指定区间[start, end]的字符
*/
public void reverseString(StringBuilder sb, int start, int end) {
// System.out.println("ReverseWords.reverseString() called with: sb = [" + sb + "], start = [" + start + "], end = [" + end + "]");
while (start < end) {
char temp = sb.charAt(start);
sb.setCharAt(start, sb.charAt(end));
sb.setCharAt(end, temp);
start++;
end--;
}
// System.out.println("ReverseWords.reverseString returned: sb = [" + sb + "]");
}

private void reverseEachWord(StringBuilder sb) {
int start = 0;
int end = 1;
int n = sb.length();
while (start < n) {
while (end < n && sb.charAt(end) != ' ') {
end++;
}
reverseString(sb, start, end - 1);
start = end + 1;
end = start + 1;
}
}
}

5、右旋转字符串

55. 右旋字符串(第八期模拟笔试)

题目描述

字符串的右旋转操作是把字符串尾部的若干个字符转移到字符串的前面。给定一个字符串 s 和一个正整数 k,请编写一个函数,将字符串中的后面 k 个字符移到字符串的前面,实现字符串的右旋转操作。

例如,对于输入字符串 “abcdefg” 和整数 2,函数应该将其转换为 “fgabcde”。

输入描述

输入共包含两行,第一行为一个正整数 k,代表右旋转的位数。第二行为字符串 s,代表需要旋转的字符串。

输出描述

输出共一行,为进行了右旋转操作后的字符串。

输入示例

1
2
2
abcdefg

输出示例

1
fgabcde

提示信

数据范围:
1 <= k < 10000,
1 <= s.length < 10000;

思路

思路就是 通过 整体倒叙,把两段子串顺序颠倒,两个段子串里的的字符在倒叙一把,负负得正,这样就不影响子串里面字符的顺序了。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import java.util.*;

public class Main{
public static void main(String[] args){
Scanner sc = new Scanner(System.in);
int n = sc.nextInt();
sc.nextLine();
String s = sc.nextLine();
//测试能否读出s System.out.print(s);
//思路就是先整体倒序输出,然后再局部倒序
char[] c = s.toCharArray();
int len = c.length;
reverse(c , 0 , len - 1);
reverse(c , 0 , n - 1);
reverse(c , n , len - 1);
System.out.print(new String(c));
}
public static void reverse(char[] c,int start ,int end){
while(start < end){
char temp = c[start];
c[start] = c[end];
c[end] = temp;
start++;
end--;
}
}
}

6、实现strStr()

28. 找出字符串中第一个匹配项的下标 - 力扣(LeetCode)

给你两个字符串 haystack 和 needle ,请你在 haystack 字符串中找出 needle 字符串的第一个匹配项的下标(下标从 0 开始)。如果 needle 不是 haystack 的一部分,则返回 -1 。

示例 1:

1
2
3
4
输入:haystack = "sadbutsad", needle = "sad"
输出:0
解释:"sad" 在下标 0 和 6 处匹配。
第一个匹配项的下标是 0 ,所以返回 0 。

示例 2:

1
2
3
输入:haystack = "leetcode", needle = "leeto"
输出:-1
解释:"leeto" 没有在 "leetcode" 中出现,所以返回 -1 。

提示:

  • 1 <= haystack.length, needle.length <= 104
  • haystack 和 needle 仅由小写英文字符组成

思路

小白学KMP算法理论部分(自用)_哔哩哔哩_bilibili

代码思路

1、初始化

2、处理不相等的情况

3、处理相等的情况

4、更新next

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
class Solution {
public int strStr(String haystack, String needle) {
char[] h = haystack.toCharArray();
char[] n = needle.toCharArray();
int hLen = h.length;
int nLen = n.length;
int[] next = getNext(n,nLen);//1、先构造next数组
//7、构造好next之后开始 匹配
int i = 0;//i指向h
int j = 0;//j指向n
while(i < hLen && j < nLen){
//8、处理不相等的情况
if(h[i] != n[j]){
//9、不相等的时候j会回退到next的前一位,如果j已经是0位置那么就只能i++
if(j != 0){
j = next[j - 1];
}else{
i++;
}
}else{
//10、处理相等的情况
i++;
j++;
}


}
if(j == nLen){
return i - j;
}
return -1;
}
//2、开始编写getNext方法
public int[] getNext(char[] n , int nLen){
//3、初始化
int[] next = new int[nLen];
int j = 0; // j 代表前缀的末尾
for(int i = 1 ; i < nLen ; i++){
//i 代表后缀的末尾

//4、处理不相等的情况
while(j > 0 && n[i] != n[j]){
j = next[j - 1];//不相等的时候j退回到next的前一个位置
}
//5、处理相等的情况
if(n[i] == n[j]){
j++;//相等的时候j向后移动一位,i也会
}

//6、更新next
next[i] = j;
}
return next;
}
}

7、重复的子字符串

给定一个非空的字符串 s ,检查是否可以通过由它的一个子串重复多次构成。

示例 1:

1
2
3
输入: s = "abab"
输出: true
解释: 可由子串 "ab" 重复两次构成。

示例 2:

1
2
输入: s = "aba"
输出: false

示例 3:

1
2
3
输入: s = "abcabcabcabc"
输出: true
解释: 可由子串 "abc" 重复四次构成。 (或子串 "abcabc" 重复两次构成。)

提示:

  • 1 <= s.length <= 104
  • s 由小写英文字母组成

思路

思路一:利用KMP方法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
class Solution {
public boolean repeatedSubstringPattern(String s) {
char[] c = s.toCharArray();
int cLen = c.length;
int j = 0;
int[] next = new int[cLen];
for(int i = 1 ; i < cLen ; i++){
while(j > 0 && c[i] != c[j]){
j = next[j - 1];
}
if(c[i] == c[j]){
j++;
}
next[i] = j;
}
int max = next[cLen - 1];//这里用cLen是因为表示整个字符串最长的公共前后缀长度
return max > 0 && cLen % (cLen - max) == 0;
}
}

第五章 栈与队列

1、理论基础

我想栈和队列的原理大家应该很熟悉了,队列是先进先出,栈是先进后出。

如图所示:

栈与队列理论1

那么我这里再列出四个关于栈的问题,大家可以思考一下。以下是以C++为例,使用其他编程语言的同学也对应思考一下,自己使用的编程语言里栈和队列是什么样的。

  1. C++中stack 是容器么?
  2. 我们使用的stack是属于哪个版本的STL?
  3. 我们使用的STL中stack是如何实现的?
  4. stack 提供迭代器来遍历stack空间么?

对于java来说这里的栈和队列需要了解一下

2、用栈实现队列

请你仅使用两个栈实现0先入先出队列。队列应当支持一般队列支持的所有操作(push、pop、peek、empty):

实现 MyQueue 类:

  • void push(int x) 将元素 x 推到队列的末尾
  • int pop() 从队列的开头移除并返回元素
  • int peek() 返回队列开头的元素
  • boolean empty() 如果队列为空,返回 true ;否则,返回 false

说明:

  • 你 只能 使用标准的栈操作 —— 也就是只有 push to top, peek/pop from top, size, 和 is empty 操作是合法的。
  • 你所使用的语言也许不支持栈。你可以使用 list 或者 deque(双端队列)来模拟一个栈,只要是标准的栈操作即可。

示例 1:

1
2
3
4
5
6
7
8
9
10
11
12
13
输入:
["MyQueue", "push", "push", "peek", "pop", "empty"]
[[], [1], [2], [], [], []]
输出:
[null, null, null, 1, 1, false]

解释:
MyQueue myQueue = new MyQueue();
myQueue.push(1); // queue is: [1]
myQueue.push(2); // queue is: [1, 2] (leftmost is front of the queue)
myQueue.peek(); // return 1
myQueue.pop(); // return 1, queue is [2]
myQueue.empty(); // return false

提示:

  • 1 <= x <= 9
  • 最多调用 100 次 push、pop、peek 和 empty
  • 假设所有操作都是有效的 (例如,一个空的队列不会调用 pop 或者 peek 操作)

思路

思路一:用两个栈一个负责出入库,一个负责存储

单纯的模拟题,不涉及算法。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
import java.util.Stack;

class MyQueue {
private Stack<Integer> s1; // 主栈用于 push
private Stack<Integer> s2; // 辅助栈用于 pop/peek

public MyQueue() {
s1 = new Stack<>();
s2 = new Stack<>();
}

// 入队:总是压入 s1
public void push(int x) {
s1.push(x);
}

// 出队:从 s2 弹出,如果 s2 为空,则从 s1 转移数据到 s2
public int pop() {
if (s2.isEmpty()) {
transfer();
}
return s2.pop();
}

// 查看队首元素
public int peek() {
if (s2.isEmpty()) {
transfer();
}
return s2.peek();
}

// 判断队列是否为空
public boolean empty() {
return s1.isEmpty() && s2.isEmpty();
}

// 将 s1 数据转移到 s2
private void transfer() {
while (!s1.isEmpty()) {
s2.push(s1.pop());
}
}
}

3、用队列实现栈

225. 用队列实现栈 - 力扣(LeetCode)

请你仅使用两个队列实现一个后入先出(LIFO)的栈,并支持普通栈的全部四种操作(push、top、pop 和 empty)。

实现 MyStack 类:

  • void push(int x) 将元素 x 压入栈顶。
  • int pop() 移除并返回栈顶元素。
  • int top() 返回栈顶元素。
  • boolean empty() 如果栈是空的,返回 true ;否则,返回 false 。

注意:

  • 你只能使用队列的标准操作 —— 也就是 push to back、peek/pop from front、size 和 is empty 这些操作。
  • 你所使用的语言也许不支持队列。 你可以使用 list (列表)或者 deque(双端队列)来模拟一个队列 , 只要是标准的队列操作即可。

示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
输入:
["MyStack", "push", "push", "top", "pop", "empty"]
[[], [1], [2], [], [], []]
输出:
[null, null, null, 2, 2, false]

解释:
MyStack myStack = new MyStack();
myStack.push(1);
myStack.push(2);
myStack.top(); // 返回 2
myStack.pop(); // 返回 2
myStack.empty(); // 返回 False

提示:

  • 1 <= x <= 9
  • 最多调用100 次 push、pop、top 和 empty
  • 每次调用 pop 和 top 都保证栈不为空

进阶:你能否仅用一个队列来实现栈。

思路一:用两个队列实现栈

(这里要强调是单向队列)

有的同学可能疑惑这种题目有什么实际工程意义,其实很多算法题目主要是对知识点的考察和教学意义远大于其工程实践的意义,所以面试题也是这样!

刚刚做过用栈实现队列的可能依然想着用一个输入队列,一个输出队列,就可以模拟栈的功能,仔细想一下还真不行!

队列模拟栈,其实一个队列就够了,那么我们先说一说两个队列来实现栈的思路。

队列是先进先出的规则,把一个队列中的数据导入另一个队列中,数据的顺序并没有变,并没有变成先进后出的顺序。

所以用栈实现队列, 和用队列实现栈的思路还是不一样的,这取决于这两个数据结构的性质。

但是依然还是要用两个队列来模拟栈,只不过没有输入和输出的关系,而是另一个队列完全用来备份的!

如下面动画所示,用两个队列que1和que2实现队列的功能,que2其实完全就是一个备份的作用,把que1最后面的元素以外的元素都备份到que2,然后弹出最后面的元素,再把其他元素从que2导回que1。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
class MyStack {

private Queue<Integer> q1;
private Queue<Integer> q2;
public MyStack() {
q1 = new LinkedList<>();
q2 = new LinkedList<>();
}

public void push(int x) {
q2.offer(x);//先将数据放在q2
//当q1还有数据的时候将数据放到q2中
while(!q1.isEmpty()){
q2.offer(q1.poll());
}
//然后将数据放回到q1,这时候数据的顺序跟栈一样了
Queue<Integer> temp = q2;
q2 = q1;
q1 = temp;
}

public int pop() {
return q1.poll();
}

public int top() {
return q1.peek();
}

public boolean empty() {
return q1.isEmpty();
}
}

/**
* Your MyStack object will be instantiated and called as such:
* MyStack obj = new MyStack();
* obj.push(x);
* int param_2 = obj.pop();
* int param_3 = obj.top();
* boolean param_4 = obj.empty();
*/

思路二:用一个队列实现栈

其实这道题目就是用一个队列就够了。

一个队列在模拟栈弹出元素的时候只要将队列头部的元素(除了最后一个元素外) 重新添加到队列尾部,此时再去弹出元素就是栈的顺序了。

简单来说就是每次加入队列的元素,都先poll一次然后再offer这个元素就可以了,但是需要用size记录要操作多少次。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
class MyStack {
Queue<Integer> q;

public MyStack() {
q = new LinkedList<>();
}

public void push(int x) {
int n = q.size();
q.offer(x); // 插入新元素
for (int i = 0; i < n; i++) { // 把前面所有元素移到新元素后面
q.offer(q.poll());
}

}

public int pop() {
return q.poll();
}

public int top() {
return q.peek();
}

public boolean empty() {
return q.isEmpty();
}
}

/**
* Your MyStack object will be instantiated and called as such:
* MyStack obj = new MyStack();
* obj.push(x);
* int param_2 = obj.pop();
* int param_3 = obj.top();
* boolean param_4 = obj.empty();
*/

4、有效的括号

20. 有效的括号 - 力扣(LeetCode)

给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,判断字符串是否有效。

有效字符串需满足:

  1. 左括号必须用相同类型的右括号闭合。
  2. 左括号必须以正确的顺序闭合。
  3. 每个右括号都有一个对应的相同类型的左括号。

示例 1:

输入:s = “()”

输出:true

示例 2:

输入:s = “()[]{}”

输出:true

示例 3:

输入:s = “(]”

输出:false

示例 4:

输入:s = “([])”

输出:true

提示:

  • 1 <= s.length <= 104
  • s 仅由括号 '()[]{}' 组成

思路

括号匹配是使用栈解决的经典问题。

题意其实就像我们在写代码的过程中,要求括号的顺序是一样的,有左括号,相应的位置必须要有右括号。

如果还记得编译原理的话,编译器在 词法分析的过程中处理括号、花括号等这个符号的逻辑,也是使用了栈这种数据结构。

再举个例子,linux系统中,cd这个进入目录的命令我们应该再熟悉不过了。

1
cd a/b/c/../../

这个命令最后进入a目录,系统是如何知道进入了a目录呢 ,这就是栈的应用(其实可以出一道相应的面试题了)

所以栈在计算机领域中应用是非常广泛的。

有的同学经常会想学的这些数据结构有什么用,也开发不了什么软件,大多数同学说的软件应该都是可视化的软件例如APP、网站之类的,那都是非常上层的应用了,底层很多功能的实现都是基础的数据结构和算法。

所以数据结构与算法的应用往往隐藏在我们看不到的地方!

这里我就不过多展开了,先来看题。

由于栈结构的特殊性,非常适合做对称匹配类的题目。

首先要弄清楚,字符串里的括号不匹配有几种情况。

一些同学,在面试中看到这种题目上来就开始写代码,然后就越写越乱。

建议在写代码之前要分析好有哪几种不匹配的情况,如果不在动手之前分析好,写出的代码也会有很多问题。

先来分析一下 这里有三种不匹配的情况,

  1. 第一种情况,字符串里左方向的括号多余了 ,所以不匹配。 括号匹配1
  2. 第二种情况,括号没有多余,但是 括号的类型没有匹配上。 括号匹配2
  3. 第三种情况,字符串里右方向的括号多余了,所以不匹配。 括号匹配3

我们的代码只要覆盖了这三种不匹配的情况,就不会出问题,可以看出 动手之前分析好题目的重要性。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import java.util.Stack;

class Solution {
public boolean isValid(String s) {
Stack<Character> stack = new Stack<>();

for (char c : s.toCharArray()) {
if (c == '(' || c == '{' || c == '[') {
stack.push(c);
} else {
if (stack.isEmpty()) return false;

char top = stack.pop();
if ((c == ')' && top != '(') ||
(c == '}' && top != '{') ||
(c == ']' && top != '[')) {
return false;
}
}
}

return stack.isEmpty();
}
}

5、删除字符串中的所有相邻的重复项

1047. 删除字符串中的所有相邻重复项 - 力扣(LeetCode)

给出由小写字母组成的字符串 s,重复项删除操作会选择两个相邻且相同的字母,并删除它们。

在 s 上反复执行重复项删除操作,直到无法继续删除。

在完成所有重复项删除操作后返回最终的字符串。答案保证唯一。

示例:

1
2
3
4
输入:"abbaca"
输出:"ca"
解释:
例如,在 "abbaca" 中,我们可以删除 "bb" 由于两字母相邻且相同,这是此时唯一可以执行删除操作的重复项。之后我们得到字符串 "aaca",其中又只有 "aa" 可以执行重复项删除操作,所以最后的字符串为 "ca"。

提示:

  1. 1 <= s.length <= 105
  2. s 仅由小写英文字母组成。

思路

本题要删除相邻相同元素,相对于20. 有效的括号 (opens new window)来说其实也是匹配问题,20. 有效的括号 是匹配左右括号,本题是匹配相邻元素,最后都是做消除的操作。

本题也是用栈来解决的经典题目。

那么栈里应该放的是什么元素呢?

我们在删除相邻重复项的时候,其实就是要知道当前遍历的这个元素,我们在前一位是不是遍历过一样数值的元素,那么如何记录前面遍历过的元素呢?

所以就是用栈来存放,那么栈的目的,就是存放遍历过的元素,当遍历当前的这个元素的时候,去栈里看一下我们是不是遍历过相同数值的相邻元素。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import java.util.Stack;

class Solution {
public String removeDuplicates(String s) {
Stack<Character> stack = new Stack<>();

for (char c : s.toCharArray()) {
if (!stack.isEmpty() && stack.peek() == c) {
stack.pop(); // 成对消除
} else {
stack.push(c); // 不成对,压入栈
}
}

// 把栈中剩余元素转为字符串返回
StringBuilder result = new StringBuilder();
for (char ch : stack) {
result.append(ch);
}
return result.toString();
}
}

6、逆波兰表达式求值

150. 逆波兰表达式求值 - 力扣(LeetCode)

给你一个字符串数组 tokens ,表示一个根据 逆波兰表示法 表示的算术表达式。

请你计算该表达式。返回一个表示表达式值的整数。

注意:

  • 有效的算符为 '+'、'-'、'*' 和 '/' 。
  • 每个操作数(运算对象)都可以是一个整数或者另一个表达式。
  • 两个整数之间的除法总是 向零截断 。
  • 表达式中不含除零运算。
  • 输入是一个根据逆波兰表示法表示的算术表达式。
  • 答案及所有中间计算结果可以用 32 位 整数表示。

示例 1:

1
2
3
输入:tokens = ["2","1","+","3","*"]
输出:9
解释:该算式转化为常见的中缀算术表达式为:((2 + 1) * 3) = 9

示例 2:

1
2
3
输入:tokens = ["4","13","5","/","+"]
输出:6
解释:该算式转化为常见的中缀算术表达式为:(4 + (13 / 5)) = 6

示例 3:

1
2
3
4
5
6
7
8
9
10
输入:tokens = ["10","6","9","3","+","-11","*","/","*","17","+","5","+"]
输出:22
解释:该算式转化为常见的中缀算术表达式为:
((10 * (6 / ((9 + 3) * -11))) + 17) + 5
= ((10 * (6 / (12 * -11))) + 17) + 5
= ((10 * (6 / -132)) + 17) + 5
= ((10 * 0) + 17) + 5
= (0 + 17) + 5
= 17 + 5
= 22

思路

其实只是一个模拟运算的过程,看效果就很快会想到使用栈来模拟。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
class Solution {
public int evalRPN(String[] tokens) {
Stack<Integer> ans = new Stack<>();
for(String token : tokens){
if(isOp(token)){
int right = ans.pop();
int left = ans.pop();
switch(token){
case "+":
ans.push(left + right);
break;
case "-":
ans.push(left - right);
break;
case "*":
ans.push(left * right);
break;
case "/":
ans.push(left / right);
break;
}
}else{
ans.push(Integer.parseInt(token));
}
}
return ans.pop();

}
public boolean isOp(String token){
if(token.equals("+") || token.equals("-") || token.equals("*") || token.equals("/")){
return true;
}else{
return false;
}
}
}

7、滑动窗口最大值

239. 滑动窗口最大值 - 力扣(LeetCode)

给你一个整数数组 nums,有一个大小为 k 的滑动窗口从数组的最左侧移动到数组的最右侧。你只可以看到在滑动窗口内的 k 个数字。滑动窗口每次只向右移动一位。

返回 滑动窗口中的最大值 。

示例 1:

1
2
3
4
5
6
7
8
9
10
11
输入:nums = [1,3,-1,-3,5,3,6,7], k = 3
输出:[3,3,5,5,6,7]
解释:
滑动窗口的位置 最大值
--------------- -----
[1 3 -1] -3 5 3 6 7 3
1 [3 -1 -3] 5 3 6 7 3
1 3 [-1 -3 5] 3 6 7 5
1 3 -1 [-3 5 3] 6 7 5
1 3 -1 -3 [5 3 6] 7 6
1 3 -1 -3 5 [3 6 7] 7

示例 2:

1
2
输入:nums = [1], k = 1
输出:[1]

提示:

  • 1 <= nums.length <= 105
  • -104 <= nums[i] <= 104
  • 1 <= k <= nums.length

思路一:使用单调队列

这是使用单调队列的经典题目。

难点是如何求一个区间里的最大值?

1、暴力方法,遍历一遍的过程中每次从窗口中再找到最大的数值,这样就是O(n x k)的算法。

2、思考现在我们需要一个队列,这个队列,放进去窗口的元素,然后随着窗口移动,队列也一进一出。,每次移动后,队列会告诉我们里面的最大值是什么。

这种队列怎么实现了?

然后再思考一下,队列里的元素一定是要排序的,而且要最大值放在出对口,要不然怎么知道最大值呢?

但如果把窗口里的元素都放进队列里,窗口移动的时候,队列需要弹出元素。

那么问题是,已经排序之后的队列 怎么能把窗口要移出的元素(这个元素不一定是最大值)弹出呢?

其实队列没有必要维护窗口里的所有元素,只需要维护有可能成为窗口里最大值的元素就可以了,同时保证队列里的元素数值是由大到小的。

那么这个维护元素单调递减的队列就叫做单调队列,即单调递减或单调递增的队列。

不要以为实现的单调队列就是 对窗口里面的数进行排序,如果排序的话,那和优先级队列又有什么区别了呢。

单调队列是如何维护队列里的元素?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
class MyQueue{
//初始化
Deque<Integer> deque = new LinkedList<Integer>();

//出队列的时候传入数,然后判断队列是否非空,并且出去的数跟最大的数相等
// 删除指定值(注意:只删除一次)
void poll(int x){
if(!deque.isEmpty() && x == deque.peek()){
deque.poll();
}
}

//进入队列
void add(int x){

//队尾元素比x小就出队尾元素并且加入新的元素
//细节如果相等也加入不用删除
while(!deque.isEmpty() && deque.getLast() < x){
deque.removeLast();
}
deque.add(x);
}

int peek(){
return deque.peek();
}
}

class Solution {
public int[] maxSlidingWindow(int[] nums, int k) {
if(nums.length == 1){//走捷径,如果是1长度的直接返回Nums
return nums;
}
int len = nums.length - k + 1;//这个是结果数组的长度(找规律得出)
int[] res = new int[len];
//初始化自定义数组
MyQueue deque = new MyQueue();
int num = 0 ;//res的下标
//先将nums中前k个数放到deque中
for(int i = 0 ; i < k ; i++){
deque.add(nums[i]);
}
res[num++] = deque.peek();
//这里开始滑动窗口第一下
for(int i = k ; i < nums.length ; i++){
//先删除
deque.poll(nums[i - k]);
//再加入
deque.add(nums[i]);
//然后记录滑动num次后的最大值
res[num++] = deque.peek();
}
return res;

}
}

8、前k个高频元素

347. 前 K 个高频元素 - 力扣(LeetCode)

给你一个整数数组 nums 和一个整数 k ,请你返回其中出现频率前 k 高的元素。你可以按 任意顺序 返回答案。

示例 1:

1
2
输入: nums = [1,1,1,2,2,3], k = 2
输出: [1,2]

示例 2:

1
2
输入: nums = [1], k = 1
输出: [1]

提示:

  • 1 <= nums.length <= 105
  • k 的取值范围是 [1, 数组中不相同的元素的个数]
  • 题目数据保证答案唯一,换句话说,数组中前 k 个高频元素的集合是唯一的

进阶:你所设计算法的时间复杂度 必须 优于 O(n log n) ,其中 n 是数组大小。

思路

这道题目主要涉及到如下三块内容:

  1. 要统计元素出现频率
  2. 对频率排序
  3. 找出前K个高频元素

首先统计元素出现的频率,这一类的问题可以使用map来进行统计。

然后是对频率进行排序,这里我们可以使用一种 容器适配器就是优先级队列。

什么是优先级队列呢?

其实就是一个披着队列外衣的堆,因为优先级队列对外接口只是从队头取元素,从队尾添加元素,再无其他取元素的方式,看起来就是一个队列。

而且优先级队列内部元素是自动依照元素的权值排列。那么它是如何有序排列的呢?

缺省情况下priority_queue利用max-heap(大顶堆)完成对元素的排序,这个大顶堆是以vector为表现形式的complete binary tree(完全二叉树)。

什么是堆呢?

【从堆的定义到优先队列、堆排序】 10分钟看懂必考的数据结构——堆_哔哩哔哩_bilibili

堆是一棵完全二叉树,树中每个结点的值都不小于(或不大于)其左右孩子的值。 如果父亲结点是大于等于左右孩子就是大顶堆,小于等于左右孩子就是小顶堆。

所以大家经常说的大顶堆(堆头是最大元素),小顶堆(堆头是最小元素),如果懒得自己实现的话,就直接用priority_queue(优先级队列)就可以了,底层实现都是一样的,从小到大排就是小顶堆,从大到小排就是大顶堆。

本题我们就要使用优先级队列来对部分频率进行排序。

为什么不用快排呢, 使用快排要将map转换为数组的结构,然后对整个数组进行排序, 而这种场景下,我们其实只需要维护k个有序的序列就可以了,所以使用优先级队列是最优的。(当然前面那个也可以但是没那么快)

此时要思考一下,是使用小顶堆呢,还是大顶堆?

有的同学一想,题目要求前 K 个高频元素,那么果断用大顶堆啊。

那么问题来了,定义一个大小为k的大顶堆,在每次移动更新大顶堆的时候,每次弹出都把最大的元素弹出去了,那么怎么保留下来前K个高频元素呢。

而且使用大顶堆就要把所有元素都进行排序,那能不能只排序k个元素呢?

所以我们要用小顶堆,因为要统计最大前k个元素,只有小顶堆每次将最小的元素弹出,最后小顶堆里积累的才是前k个最大元素。

寻找前k个最大元素流程如图所示:(图中的频率只有三个,所以正好构成一个大小为3的小顶堆,如果频率更多一些,则用这个小顶堆进行扫描)

image-20250714230517369

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import java.util.*;

class Solution {
public int[] topKFrequent(int[] nums, int k) {
// Step 1: 统计每个数字出现的频率
Map<Integer, Integer> map = new HashMap<>();
for (int num : nums) {
map.put(num, map.getOrDefault(num, 0) + 1);
}

// Step 2: 使用小顶堆维护频率最高的 k 个元素
PriorityQueue<int[]> minHeap = new PriorityQueue<>((a, b) -> a[1] - b[1]);

for (Map.Entry<Integer, Integer> entry : map.entrySet()) {
if (minHeap.size() < k) {
minHeap.offer(new int[]{entry.getKey(), entry.getValue()});
} else {
// 如果当前频率大于堆顶元素的频率,替换
if (entry.getValue() > minHeap.peek()[1]) {
minHeap.poll();
minHeap.offer(new int[]{entry.getKey(), entry.getValue()});
}
}
}

// Step 3: 将堆中的元素存入结果数组
int[] res = new int[k];
for (int i = 0; i < k; i++) {
res[i] = minHeap.poll()[0];
}

return res;
}
}

第六章 二叉树

1、理论基础

在我们解题过程中二叉树有两种主要的形式:满二叉树和完全二叉树。

二叉树种类

满二叉树

满二叉树:如果一棵二叉树只有度为0的结点和度为2的结点,并且度为0的结点在同一层上,则这棵二叉树为满二叉树。

度就是所拥有的子节点个数,如果是0就称为叶子结点

如图所示:

image-20250715110830068

这棵二叉树为满二叉树,也可以说深度为k,有2^k-1个节点的二叉树。

完全二叉树

什么是完全二叉树?

完全二叉树的定义如下:在完全二叉树中,除了最底层节点可能没填满外,其余每层节点数都达到最大值,并且最下面一层的节点都集中在该层最左边的若干位置。若最底层为第 h 层(h从1开始),则该层包含 1~ 2^(h-1) 个节点。

大家要自己看完全二叉树的定义,很多同学对完全二叉树其实不是真正的懂了。

我来举一个典型的例子如题:

image-20250715111119250

之前我们刚刚讲过优先级队列其实是一个堆,堆就是一棵完全二叉树,同时保证父子节点的顺序关系。

二叉搜索树

前面介绍的树,都没有数值的,而二叉搜索树是有数值的了,二叉搜索树是一个有序树。

  • 若它的左子树不空,则左子树上所有结点的值均小于它的根结点的值;
  • 若它的右子树不空,则右子树上所有结点的值均大于它的根结点的值;
  • 它的左、右子树也分别为二叉排序树

下面这两棵树都是搜索树

左小右大

image-20250715112452146

平衡二叉搜索树

平衡二叉搜索树:又被称为AVL(Adelson-Velsky and Landis)树,且具有以下性质:它是一棵空树或它的左右两个子树的高度差的绝对值不超过1,并且左右两个子树都是一棵平衡二叉树。

image-20250715112554664

C++ 类型 Java 类型 底层数据结构 是否支持重复键 是否有序
map TreeMap 红黑树 否 是
set TreeSet 红黑树(基于 TreeMap) 否 是
multimap TreeMap 红黑树 是 是
multiset 自定义或 Guava 红黑树 是 是

所以大家使用自己熟悉的编程语言写算法,一定要知道常用的容器底层都是如何实现的,最基本的就是map、set等等,否则自己写的代码,自己对其性能分析都分析不清楚!

二叉树的存储方式

二叉树可以链式存储,也可以顺序存储。

那么链式存储方式就用指针, 顺序存储的方式就是用数组。

顾名思义就是顺序存储的元素在内存是连续分布的,而链式存储则是通过指针把分布在各个地址的节点串联一起。

链式存储如图:

img

链式存储是大家很熟悉的一种方式,那么我们来看看如何顺序存储呢?

其实就是用数组来存储二叉树,顺序存储的方式如图:

image-20250715120235218

用数组来存储二叉树如何遍历的呢?

如果父节点的数组下标是 i,那么它的左孩子就是 i * 2 + 1,右孩子就是 i * 2 + 2。

但是用链式表示的二叉树,更有利于我们理解,所以一般我们都是用链式存储二叉树。

所以大家要了解,用数组依然可以表示二叉树。

二叉树的遍历方式

关于二叉树的遍历方式,要知道二叉树遍历的基本方式都有哪些。

一些同学用做了很多二叉树的题目了,可能知道前中后序遍历,可能知道层序遍历,但是却没有框架。

我这里把二叉树的几种遍历方式列出来,大家就可以一一串起来了。

二叉树主要有两种遍历方式:

  1. 深度优先遍历:先往深走,遇到叶子节点再往回走。
  2. 广度优先遍历:一层一层的去遍历。

这两种遍历是图论中最基本的两种遍历方式,后面在介绍图论的时候 还会介绍到。

那么从深度优先遍历和广度优先遍历进一步拓展,才有如下遍历方式:

  • 深度优先遍历
    • 前序遍历(递归法,迭代法)
    • 中序遍历(递归法,迭代法)
    • 后序遍历(递归法,迭代法)
  • 广度优先遍历
    • 层次遍历(迭代法)

在深度优先遍历中:有三个顺序,前中后序遍历, 有同学总分不清这三个顺序,经常搞混,我这里教大家一个技巧。

这里前中后,其实指的就是中间节点的遍历顺序,只要大家记住 前中后序指的就是中间节点的位置就可以了。

看如下中间节点的顺序,就可以发现,中间节点的顺序就是所谓的遍历方式

  • 前序遍历:中左右
  • 中序遍历:左中右
  • 后序遍历:左右中

大家可以对着如下图,看看自己理解的前后中序有没有问题。

img

最后再说一说二叉树中深度优先和广度优先遍历实现方式,我们做二叉树相关题目,经常会使用递归的方式来实现深度优先遍历,也就是实现前中后序遍历,使用递归是比较方便的。

之前我们讲栈与队列的时候,就说过栈其实就是递归的一种实现结构,也就说前中后序遍历的逻辑其实都是可以借助栈使用递归的方式来实现的。

而广度优先遍历的实现一般使用队列来实现,这也是队列先进先出的特点所决定的,因为需要先进先出的结构,才能一层一层的来遍历二叉树。

这里其实我们又了解了栈与队列的一个应用场景了。

具体的实现我们后面都会讲的,这里大家先要清楚这些理论基础。

二叉树的定义

刚刚我们说过了二叉树有两种存储方式顺序存储,和链式存储,顺序存储就是用数组来存,这个定义没啥可说的,我们来看看链式存储的二叉树节点的定义方式。

1
2
3
4
5
6
7
8
9
10
11
12
13
public class TreeNode {
int val;
TreeNode left;
TreeNode right;

TreeNode() {}
TreeNode(int val) { this.val = val; }
TreeNode(int val, TreeNode left, TreeNode right) {
this.val = val;
this.left = left;
this.right = right;
}
}

大家会发现二叉树的定义 和链表是差不多的,相对于链表 ,二叉树的节点里多了一个指针, 有两个指针,指向左右孩子。

这里要提醒大家要注意二叉树节点定义的书写方式。

在现场面试的时候 面试官可能要求手写代码,所以数据结构的定义以及简单逻辑的代码一定要锻炼白纸写出来。

因为我们在刷leetcode的时候,节点的定义默认都定义好了,真到面试的时候,需要自己写节点定义的时候,有时候会一脸懵逼!

2、二叉树的递归遍历

思路

这次我们要好好谈一谈递归,为什么很多同学看递归算法都是“一看就会,一写就废”。

主要是对递归不成体系,没有方法论,每次写递归算法 ,都是靠玄学来写代码,代码能不能编过都靠运气。

本篇将介绍前后中序的递归写法,一些同学可能会感觉很简单,其实不然,我们要通过简单题目把方法论确定下来,有了方法论,后面才能应付复杂的递归。

这里帮助大家确定下来递归算法的三个要素。每次写递归,都按照这三要素来写,可以保证大家写出正确的递归算法!

  1. 确定递归函数的参数和返回值: 确定哪些参数是递归的过程中需要处理的,那么就在递归函数里加上这个参数, 并且还要明确每次递归的返回值是什么进而确定递归函数的返回类型。
  2. 确定终止条件: 写完了递归算法, 运行的时候,经常会遇到栈溢出的错误,就是没写终止条件或者终止条件写的不对,操作系统也是用一个栈的结构来保存每一层递归的信息,如果递归没有终止,操作系统的内存栈必然就会溢出。
  3. 确定单层递归的逻辑: 确定每一层递归需要处理的信息。在这里也就会重复调用自己来实现递归的过程。

好了,我们确认了递归的三要素,接下来就来练练手:

以下以前序遍历为例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 前序遍历·递归·LC144_二叉树的前序遍历
class Solution {
public List<Integer> preorderTraversal(TreeNode root) {
List<Integer> result = new ArrayList<Integer>();
preorder(root, result);
return result;
}
//1、确定递归函数的传参数和返回值
//因为要打印出谦虚遍历节点的数值,所以需要传入result来放节点的数值,除了这一点也不需要什么返回值,所以是void
public void preorder(TreeNode root, List<Integer> result) {
//2、确定终止条件
//在递归过程中,如果当前遍历的节点是空,那么本层的递归就结束了直接return
if (root == null) {
return;
}
//3、确定单层递归的逻辑,前序遍历是按照中左右的顺序来处理的,这样的二叉树就基本写完了。
result.add(root.val);
preorder(root.left, result);
preorder(root.right, result);
}
}

3、二叉树的迭代遍历

思路

为什么可以用迭代法(非递归的方式)来实现二叉树的前后中序遍历呢?

匹配问题都是栈的强项,

递归的实现就是:每一次递归调用都会把函数的局部变量、参数值和返回地址等压入调用栈中,然后递归返回的时候,从栈顶弹出上一次递归的各项参数,所以这就是递归为什么可以返回上一层位置的原因。

此时大家应该知道我们用栈也可以是实现二叉树的前后中序遍历了。

前序遍历(迭代法)

我们先看一下前序遍历。

前序遍历是中左右,每次先处理的是中间节点,那么先将根节点放入栈中,然后将右孩子加入栈,再加入左孩子。

为什么要先加入 右孩子,再加入左孩子呢? 因为这样出栈的时候才是中左右的顺序

不难写出下面的代码

思路就是遍历到叶子结点再出,第一个节点先出

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
// 前序遍历顺序:中-左-右,入栈顺序:中-右-左
class Solution {
public List<Integer> preorderTraversal(TreeNode root) {
List<Integer> result = new ArrayList<>();
if (root == null){
return result;
}
Stack<TreeNode> stack = new Stack<>();
stack.push(root);
while (!stack.isEmpty()){
TreeNode node = stack.pop();
result.add(node.val);
if (node.right != null){
stack.push(node.right);
}
if (node.left != null){
stack.push(node.left);
}
}
return result;
}
}

此时会发现貌似使用迭代法写出前序遍历并不难,确实不难。

此时是不是想改一点前序遍历代码顺序就把中序遍历搞出来了?

其实还真不行!

但接下来,再用迭代法写中序遍历的时候,会发现套路又不一样了,目前的前序遍历的逻辑无法直接应用到中序遍历上。

中序遍历(迭代法)

为了解释清楚,我说明一下 刚刚在迭代的过程中,其实我们有两个操作:

  1. 处理:将元素放进result数组中
  2. 访问:遍历节点

分析一下为什么刚刚写的前序遍历的代码,不能和中序遍历通用呢,因为前序遍历的顺序是中左右,先访问的元素是中间节点,要处理的元素也是中间节点,所以刚刚才能写出相对简洁的代码,因为要访问的元素和要处理的元素顺序是一致的,都是中间节点。

那么再看看中序遍历,中序遍历是左中右,先访问的是二叉树顶部的节点,然后一层一层向下访问,直到到达树左面的最底部,再开始处理节点(也就是在把节点的数值放进result数组中),这就造成了处理顺序和访问顺序是不一致的。

那么在使用迭代法写中序遍历,就需要借用指针的遍历来帮助访问节点,栈则用来处理节点上的元素。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
// 中序遍历顺序: 左-中-右 入栈顺序: 左-右
class Solution {
public List<Integer> inorderTraversal(TreeNode root) {
List<Integer> result = new ArrayList<>();
if (root == null){
return result;
}
Stack<TreeNode> stack = new Stack<>();
TreeNode cur = root;
while (cur != null || !stack.isEmpty()){
if (cur != null){
stack.push(cur);
cur = cur.left;
}else{
cur = stack.pop();
result.add(cur.val);
cur = cur.right;
}
}
return result;
}
}
后序遍历(迭代法)

再来看后序遍历,先序遍历是中左右,后序遍历是左右中,那么我们只需要调整一下先序遍历的代码顺序,就变成中右左的遍历顺序,然后在反转result数组,输出的结果顺序就是左右中了,如下图:

前序到后序

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// 后序遍历顺序 左-右-中 入栈顺序:中-左-右 出栈顺序:中-右-左, 最后翻转结果
class Solution {
public List<Integer> postorderTraversal(TreeNode root) {
List<Integer> result = new ArrayList<>();
if (root == null){
return result;
}
Stack<TreeNode> stack = new Stack<>();
stack.push(root);
while (!stack.isEmpty()){
TreeNode node = stack.pop();
result.add(node.val);
if (node.left != null){
stack.push(node.left);
}
if (node.right != null){
stack.push(node.right);
}
}
Collections.reverse(result);
return result;
}
}

所以后序遍历只需要前序遍历的代码稍作修改就可以了,代码如下:

总结

此时我们用迭代法写出了二叉树的前后中序遍历,大家可以看出前序和中序是完全两种代码风格,并不像递归写法那样代码稍做调整,就可以实现前后中序。

这是因为前序遍历中访问节点(遍历节点)和处理节点(将元素放进result数组中)可以同步处理,但是中序就无法做到同步!

上面这句话,可能一些同学不太理解,建议自己亲手用迭代法,先写出来前序,再试试能不能写出中序,就能理解了。

那么问题又来了,难道二叉树前后中序遍历的迭代法实现,就不能风格统一么(即前序遍历改变代码顺序就可以实现中序 和 后序)?

当然可以,这种写法,还不是很好理解,我们将在下一篇文章里重点讲解。

4、二叉树的统一迭代法

思路

我们发现迭代法实现的先中后序,其实风格也不是那么统一,除了先序和后序,有关联,中序完全就是另一个风格了

实践过的同学,也会发现使用迭代法实现先中后序遍历,很难写出统一的代码,不像是递归法,实现了其中的一种遍历方式,其他两种只要稍稍改一下节点顺序就可以了。

其实针对三种遍历方式,使用迭代法是可以写出统一风格的代码!

重头戏来了,接下来介绍一下统一写法。

我们以中序遍历为例,

如何标记呢?

  • 访问(Visited):当一个节点第一次被压入栈时,它还没有被“访问”(即它的左子树还没有被处理)。
  • 处理(Processed):当一个节点被弹出栈时,如果它不是 null,说明它是第一次被访问;如果它是 null,说明它的左子树已经处理完毕,接下来需要处理它自己(将它的值加入结果列表)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {
public List<Integer> inorderTraversal(TreeNode root) {
List<Integer> result = new LinkedList<>();
Stack<TreeNode> st = new Stack<>();
if (root != null) st.push(root);
while (!st.empty()) {
TreeNode node = st.peek();
if (node != null) {
st.pop(); // 将该节点弹出,避免重复操作,下面再将右中左节点添加到栈中(中序遍历-左中右,入栈顺序右中左)
if (node.right!=null) st.push(node.right); // 添加右节点(空节点不入栈)
st.push(node); // 添加中节点
st.push(null); // 中节点访问过,处理过,加入空节点做为标记。
if (node.left!=null) st.push(node.left); // 添加左节点(空节点不入栈)
} else { // 只有遇到空节点的时候,才将下一个节点放进结果集
st.pop(); // 将空节点弹出
node = st.peek(); // 重新取出栈中元素
st.pop();
result.add(node.val); // 加入到结果集
}
}
return result;
}
}

5、二叉树的层序遍历

102. 二叉树的层序遍历 - 力扣(LeetCode)

给你一个二叉树,请你返回其按 层序遍历 得到的节点值。 (即逐层地,从左到右访问所有节点)。

102.二叉树的层序遍历

思路

层序遍历一个二叉树。就是从左到右一层一层的去遍历二叉树。这种遍历的方式和我们之前讲过的都不太一样。

需要借用一个辅助数据结构即队列来实现,队列先进先出,符合一层一层遍历的逻辑,而用栈先进后出适合模拟深度优先遍历也就是递归的逻辑。

而这种层序遍历方式就是图论中的广度优先遍历,只不过我们应用在二叉树上。

使用队列实现二叉树广度优先遍历

方法一是递归的方式,deep记录的是层级

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public List<List<Integer>> res = new ArrayList<>();//返回结果

public List<List<Integer>> levelOrder(TreeNode root) {
fun1(root,0);
return res;

}

//把每一层的结果放到res里面,res里面是一个数组,数组里面又放的是数组
public void fun1(TreeNode node , int deep){
//结束递归的条件
if(node == null) return;
deep++;
//递归的界限,把item加入到结果里面
if(res.size() < deep){
List<Integer> item = new ArrayList<>();
res.add(item);
}
//获取当前层级的数组,然后把元素放入到数组中
res.get(deep - 1).add(node.val);
fun1(node.left,deep);
fun1(node.right,deep);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
// 102.二叉树的层序遍历
class Solution {
public List<List<Integer>> resList = new ArrayList<List<Integer>>();

public List<List<Integer>> levelOrder(TreeNode root) {
checkFun02(root);

return resList;
}
//BFS--迭代方式--借助队列
public void checkFun02(TreeNode node) {
if (node == null) return;
Queue<TreeNode> que = new LinkedList<TreeNode>();
que.offer(node);

while (!que.isEmpty()) {
List<Integer> itemList = new ArrayList<Integer>();
int len = que.size();

while (len > 0) {
TreeNode tmpNode = que.poll();
itemList.add(tmpNode.val);

if (tmpNode.left != null) que.offer(tmpNode.left);
if (tmpNode.right != null) que.offer(tmpNode.right);
len--;
}

resList.add(itemList);
}

}
}

我们以这棵树为例:

1
2
3
4
5
  3
/ \
9 20
/ \
15 7

初始化阶段

1
2
Queue<TreeNode> que = new LinkedList<>();
que.offer(root); // root = 3

此时队列内容:[3]
que.size() = 1 → len = 1


第一次外层循环(处理第 1 层)

1
2
3
4
5
6
7
8
9
while (!que.isEmpty()) {
List<Integer> itemList = new ArrayList<>();
int len = que.size(); // len = 1
while (len > 0) {
...
len--;
}
resList.add(itemList);
}

内层循环(处理第 1 层)

  • len = 1
  • 弹出节点 3,加入 itemList = [3]
  • 把 3.left = 9, 3.right = 20 加入队列

队列现在:[9, 20]

  • len-- → len = 0,退出内层循环
  • resList.add([3])

第二次外层循环(处理第 2 层)

  • 队列:[9, 20]
  • len = que.size() = 2

内层循环(处理第 2 层)

  • len = 2
  • 弹出 9 → itemList = [9]
  • 9 没有子节点,不加入队列
  • len-- = 1
  • 弹出 20 → itemList = [9, 20]
  • 20.left = 15, 20.right = 7 加入队列
  • len-- = 0,退出内层循环

队列现在:[15, 7]

  • resList.add([9, 20])

第三次外层循环(处理第 3 层)

  • 队列:[15, 7]
  • len = 2

内层循环(处理第 3 层)

  • 弹出 15,加入 itemList = [15]
  • 15 没有子节点
  • len-- = 1
  • 弹出 7,加入 itemList = [15, 7]
  • 7 没有子节点
  • len-- = 0,退出内层循环

队列现在为空

  • resList.add([15, 7])

6、二叉树的层次遍历2

107. 二叉树的层序遍历 II - 力扣(LeetCode)

给定一个二叉树,返回其节点值自底向上的层次遍历。 (即按从叶子节点所在层到根节点所在的层,逐层从左向右遍历)

107.二叉树的层次遍历II

思路

相当于把普通二叉树的res的数组反转一下就好了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {

public List<List<Integer>> res = new ArrayList<>();

public List<List<Integer>> levelOrderBottom(TreeNode root) {
fun(root);
List<List<Integer>> res2 = new ArrayList<>();
for(int i = res.size() ; i > 0 ; i--){
res2.add(res.get(i - 1));
}
return res2;
}
public void fun(TreeNode node){
if(node==null) return;
Queue<TreeNode> que = new LinkedList<>();

que.offer(node);
while(!que.isEmpty()){
List<Integer> item = new ArrayList<>();
int len = que.size();
while(len > 0){
TreeNode tmpNode = que.poll();
item.add(tmpNode.val);
if(tmpNode.left != null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}


len--;
}
res.add(item);
}


}
}

7、二叉树的右视图

199. 二叉树的右视图 - 力扣(LeetCode)

思路

给定一棵二叉树,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值。

199.二叉树的右视图

层序遍历的时候,判断是否遍历到单元层的最后面的元素,如果是,就放进res数组中,随后返回res就可以了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {

public List<Integer> res = new ArrayList<>();

public List<Integer> rightSideView(TreeNode root) {
fun(root);
return res;
}
public void fun(TreeNode node){
if(node == null) return ;
Queue<TreeNode> que = new LinkedList<>();

que.offer(node);
while(!que.isEmpty()){
int len = que.size();//记录每一层的节点数,也就是过了这个节点数就是下一层了

while(len > 0){
TreeNode tmpNode = que.poll();
if(tmpNode.left!= null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}
if(len == 1){
//这个是最右边的元素因为我们是从左往右加数的
res.add(tmpNode.val);
}
len--;
}
}
}
}

8、二叉树的层平均值

637. 二叉树的层平均值 - 力扣(LeetCode)

给定一个非空二叉树, 返回一个由每层节点平均值组成的数组。

637.二叉树的层平均值

思路

就是在放入res的时候求平均值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public List<Double> res = new ArrayList<>();

public List<Double> averageOfLevels(TreeNode root) {
fun(root);
return res;
}

public void fun(TreeNode node) {
if (node == null)
return;

Queue<TreeNode> que = new LinkedList<>();
que.offer(node);

while (!que.isEmpty()) {
int len = que.size();
int levelCount = len; // 保存原始 size
double sum = 0.0;

while (len > 0) {
TreeNode tmpNode = que.poll();
sum += tmpNode.val;

if (tmpNode.left != null)
que.offer(tmpNode.left);
if (tmpNode.right != null)
que.offer(tmpNode.right);

len--;
}

res.add(sum / levelCount); // 使用原始 count
}
}
}

9、N叉树的层序遍历

429. N 叉树的层序遍历 - 力扣(LeetCode)

给定一个 N 叉树,返回其节点值的层序遍历。 (即从左到右,逐层遍历)。

例如,给定一个 3叉树 :

429. N叉树的层序遍历

返回其层序遍历:

[ [1], [3,2,4], [5,6] ]

思路

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class Solution {
public List<List<Integer>> res = new ArrayList<>();

public List<List<Integer>> levelOrder(Node root) {
if (root == null) return res;
Queue<Node> que = new LinkedList<>();
que.offer(root);

while (!que.isEmpty()) {
int levelSize = que.size();
List<Integer> levelList = new ArrayList<>();

for (int i = 0; i < levelSize; i++) {
Node node = que.poll();
levelList.add(node.val);

// 遍历当前节点的所有子节点,并加入队列
if (node.children != null) {
for (Node child : node.children) {
que.offer(child);
}
}
}

res.add(levelList);
}

return res;
}
}

10、在每个树行中找最大值

515. 在每个树行中找最大值 - 力扣(LeetCode)

您需要在二叉树的每一行中找到最大的值。

515.在每个树行中找最大值

思路

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public List<Integer> res = new ArrayList<>();

public List<Integer> largestValues(TreeNode root) {
fun(root);
return res;
}
public void fun(TreeNode node){
if(node == null) return ;
Queue<TreeNode> que = new LinkedList<>();

que.offer(node);
while(!que.isEmpty()){
int len = que.size();
int max = -Integer.MIN_VALUE;
while(len > 0){
TreeNode tmpNode = que.poll();
if(tmpNode.left != null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}
if(tmpNode.val > max){
max = tmpNode.val;

}
len--;
}
res.add(max);
}
}
}

11、填充每个节点的下一个右侧节点指针

116. 填充每个节点的下一个右侧节点指针 - 力扣(LeetCode)

给定一个完美二叉树,其所有叶子节点都在同一层,每个父节点都有两个子节点。二叉树定义如下:

1
2
3
4
5
6
struct Node {
int val;
Node *left;
Node *right;
Node *next;
}

填充它的每个 next 指针,让这个指针指向其下一个右侧节点。如果找不到下一个右侧节点,则将 next 指针设置为 NULL。

初始状态下,所有 next 指针都被设置为 NULL。

示例 1:

img

1
2
3
输入:root = [1,2,3,4,5,6,7]
输出:[1,#,2,3,#,4,5,6,7,#]
解释:给定二叉树如图 A 所示,你的函数应该填充它的每个 next 指针,以指向其下一个右侧节点,如图 B 所示。序列化的输出按层序遍历排列,同一层节点由 next 指针连接,'#' 标志着每一层的结束。

示例 2:

1
2
输入:root = []
输出:[]

提示:

  • 树中节点的数量在 [0, 212 - 1] 范围内
  • -1000 <= node.val <= 1000
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public Node connect(Node root) {
if (root == null) return null;

Queue<Node> queue = new LinkedList<>();
queue.offer(root);

while (!queue.isEmpty()) {
int levelSize = queue.size();

for (int i = 0; i < levelSize; i++) {
Node node = queue.poll();

// 如果不是当前层最后一个节点,就连接下一个节点
if (i < levelSize - 1) {
node.next = queue.peek(); // peek() 返回队列头部元素,不弹出
} else {
node.next = null;
}

if (node.left != null) queue.offer(node.left);
if (node.right != null) queue.offer(node.right);
}
}

return root;
}
}

12、填充每个节点的下一个右侧节点指针2

117. 填充每个节点的下一个右侧节点指针 II - 力扣(LeetCode)

给定一个二叉树:

1
2
3
4
5
6
struct Node {
int val;
Node *left;
Node *right;
Node *next;
}

填充它的每个 next 指针,让这个指针指向其下一个右侧节点。如果找不到下一个右侧节点,则将 next 指针设置为 NULL 。

初始状态下,所有 next 指针都被设置为 NULL 。

示例 1:

img

1
2
3
输入:root = [1,2,3,4,5,null,7]
输出:[1,#,2,3,#,4,5,7,#]
解释:给定二叉树如图 A 所示,你的函数应该填充它的每个 next 指针,以指向其下一个右侧节点,如图 B 所示。序列化输出按层序遍历顺序(由 next 指针连接),'#' 表示每层的末尾。

示例 2:

1
2
输入:root = []
输出:[]

提示:

  • 树中的节点数在范围 [0, 6000] 内
  • -100 <= Node.val <= 100
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public Node connect(Node root) {
if (root == null) return null;

Queue<Node> queue = new LinkedList<>();
queue.offer(root);

while (!queue.isEmpty()) {
int levelSize = queue.size();

for (int i = 0; i < levelSize; i++) {
Node node = queue.poll();

// 如果不是当前层最后一个节点,就连接下一个节点
if (i < levelSize - 1) {
node.next = queue.peek(); // peek() 返回队列头部元素,不弹出
} else {
node.next = null;
}

if (node.left != null) queue.offer(node.left);
if (node.right != null) queue.offer(node.right);
}
}

return root;
}
}

13、二叉树的最大深度

104. 二叉树的最大深度 - 力扣(LeetCode)

层序遍历

层数就是最大深度返回层数就行

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {


public int maxDepth(TreeNode root) {
int res = fun(root);
return res;
}

public int fun(TreeNode node){
if(node == null) return 0;
Queue<TreeNode> que = new LinkedList<>();
que.offer(node);
int lenLevel = 0;
while(!que.isEmpty()){

int len = que.size();
lenLevel++;
while(len > 0){
TreeNode tmpNode = que.poll();
if(tmpNode.left != null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}
len--;
}
}
return lenLevel;
}
}

递归法

二叉树中“高度”与“深度” 的问题,很多初学者在学习二叉树时都会对这两个概念产生混淆。


一、定义对比

概念 定义 说明
深度(Depth) 从根节点到当前节点的路径长度(边数或节点数) 从上往下看,根节点深度为0或1(取决于定义)
高度(Height) 从当前节点到其最远叶子节点的路径长度(边数或节点数) 从下往上看,叶子节点高度为0或1

二、举个例子说明

我们来看一棵简单的二叉树:

1
2
3
4
5
    A
/
B
/ \
C D

假设:节点数从1开始计数,边数从0开始计数

节点 深度(Depth) 高度(Height)
A(根) 0(根节点到自己的距离) 2(最长路径 A → B → C 或 D)
B 1(根到B) 1(最长路径 B → C 或 D)
C 2(根到C) 0(C是叶子)
D 2(根到D) 0(D是叶子)

本题可以使用前序(中左右),也可以使用后序遍历(左右中),使用前序求的就是深度,使用后序求的是高度。

  • 二叉树节点的深度:指从根节点到该节点的最长简单路径边的条数或者节点数(取决于深度从0开始还是从1开始)
  • 二叉树节点的高度:指从该节点到叶子节点的最长简单路径边的条数或者节点数(取决于高度从0开始还是从1开始)

而根节点的高度就是二叉树的最大深度,所以本题中我们通过后序求的根节点高度来求的二叉树最大深度。

这一点其实是很多同学没有想清楚的,很多题解同样没有讲清楚。

我先用后序遍历(左右中)来计算树的高度。

1、确定递归函数的参数和返回值:参数就是传入数的根节点,返回就是返回这棵树的深度,所以返回的是int

1
int getdepth(TreeNode node)

2、确定终止条件:如果为空节点的话,就返回0,表示高度为0

1
if(node == null) return 0

3、确定单层递归的逻辑:先求左子树的深度,再求右子树的深度,最后取左右深度最大的数值再+1(加1是因为算上当前中间节点)就是目前节点为根节点的树的深度。

1
2
3
4
int leftdepth = getdepth(node.left);//左
int rightdepth = getdepth(node.right);//右
int depth = 1 + Mmax(leftdepth, rightdepth);//中
return depth;

最后的代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int maxDepth(TreeNode root) {
int depth = getdepth(root);
return depth;
}

public int getdepth(TreeNode node) {
if (node == null)
return 0;
int leftdepth = getdepth(node.left);//左
int rightdepth = getdepth(node.right);//右
int depth = 1 + Math.max(leftdepth, rightdepth);//中
return depth;
}
}

14、二叉树的最小深度

111. 二叉树的最小深度 - 力扣(LeetCode)

给定一个二叉树,找出其最小深度。

最小深度是从根节点到最近叶子节点的最短路径上的节点数量。

说明:叶子节点是指没有子节点的节点。

示例 1:

img

1
2
输入:root = [3,9,20,null,null,15,7]
输出:2

示例 2:

1
2
输入:root = [2,null,3,null,4,null,5,null,6]
输出:5

提示:

  • 树中节点数的范围在 [0, 105] 内
  • -1000 <= Node.val <= 1000

层序遍历

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int minDepth(TreeNode root) {
//思路还是层序遍历,如果左右都没有就返回层数
int lenLevel = 0;
Queue<TreeNode> que = new LinkedList<>();
que.offer(root);
if(root == null){
return lenLevel;
}
while(!que.isEmpty()){
int len = que.size();
lenLevel++;
while(len > 0){
TreeNode tmpNode = que.poll();
if(tmpNode.left == null && tmpNode.right == null){
return lenLevel;
}
if(tmpNode.left != null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}
len--;
}
}
return lenLevel;

}
}

递归法

这里是求最小深度

前序遍历求的是深度,后序遍历求的事高度。

那么使用后续遍历,其实求的事根节点到叶子节点的最小距离,求的事高度的过程,不过这个最小距离也同样是最小深度。

递归三部曲

1、确定递归函数的参数和返回值

参数为要传入的二叉树根节点,返回的是int的深度

1
int getDepth(TreeNode node)

2、确定终止条件

终止条件也是遇到空节点返回0,表示当前节点的高度为0

1
if(node == null) return 0;

3、确定单层递归的逻辑

这里很重要

image-20250724232409997

因为如果左子树为空的话算作0的话,没有左孩子的分支会被算作最短深度。

如果左子树为空,右子树不为空,那么最小深度是1+右子树的深度

如果右子树为空,左子树不为空,最小深度是1+左子树的深度。

最后如果左右子树都不为空或者都为空,返回左右子树深度最小值+1.

我们用的是后序遍历

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
int leftDepth = getDepth(node.left);//左
int rightDepth = getDepth(node.right);//右
//中
//当一个左子树为空,右子树不为空
if(node.left == null && node.right != null){
return 1 + rightDepth;
}
//当一个右子树为空,左子树不为空
if(node.left != null && node.right == null){
return 1 + leftDepth;
}
//如果左右都不为空或者都为空
int result = 1 + Math.min(leftDepth,rightDepth);
return result;

最后的代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int minDepth(TreeNode root) {
int res = getDepth(root);
return res;
}

public int getDepth(TreeNode node) {
if (node == null)
return 0;
int leftDepth = getDepth(node.left);
int rightDepth = getDepth(node.right);
//当一个左子树为空,右子树不为空
if (node.left == null && node.right != null) {
return 1 + rightDepth;
}
//当一个右子树为空,左子树不为空
if (node.left != null && node.right == null) {
return 1 + leftDepth;
}
//如果左右都不为空或者都为空
int result = 1 + Math.min(leftDepth, rightDepth);
return result;

}
}

15、反转二叉树

226. 翻转二叉树 - 力扣(LeetCode)

给你一棵二叉树的根节点 root ,翻转这棵二叉树,并返回其根节点。

示例 1:

img

1
2
输入:root = [4,2,7,1,3,6,9]
输出:[4,7,2,9,6,3,1]

示例 2:

img

1
2
输入:root = [2,1,3]
输出:[2,3,1]

示例 3:

1
2
输入:root = []
输出:[]

提示:

  • 树中节点数目范围在 [0, 100] 内
  • -100 <= Node.val <= 100

思路

自己看一下想要反转二叉树,其实就是把每一个节点的左右孩子交换一下就行了。

那么关键在于遍历顺序,前中后序应该选择哪一种遍历顺序?

这道题使用前序比那里和后续遍历都是可以的,唯独中序遍历不方便,因为中序遍历会把某些节点的左右孩子反转两次。画个图就懂了求求你一定要画

层序遍历也是可以的,只要把每一个节点的左右孩子反转一次的遍历方式就可以了。

递归法

我们以前序遍历为例子,看一下翻转过程。

递归的三部曲:

1、确定递归函数的参数和返回值

参数就是要传入节点的指针,不需要其他参数,通常此时定下来主要参数,如果在写递归的逻辑中发现还需要其他参数的时候,随时补充。

返回值的话其实也不需要,但是题目中给出的要返回root节点的指针,可以直接使用题目定义好的函数,所以函数的返回类型可以为TreeNode.

2、确定终止条件

当前节点为空的时候就返回

3、确定单层递归的逻辑

因为是前序遍历,所以先进性交换左右孩子节点,然后翻转左子树,翻转右子树。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public TreeNode invertTree(TreeNode root) {
if(root == null) return null;
//前序遍历中左右
swapchild(root);
invertTree(root.left);
invertTree(root.right);
return root;
}
public void swapchild(TreeNode root){
TreeNode tmpNode = root.left;
root.left = root.right;
root.right = tmpNode;
}
}
迭代法(深度优先)

为什么这个中序就是可以的呢,因为这是用栈来遍历,而不是靠指针来遍历,避免了递归法中翻转了两次的情况,大家可以画图理解一下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode invertTree(TreeNode root) {
Stack<TreeNode> st = new Stack<>();
if(root != null) st.push(root);
while(!st.empty()){
TreeNode node = st.peek();
if(node != null){
st.pop();
if(node.right != null) st.push(node.right);
st.push(node);
st.push(null);
if(node.left != null) st.push(node.left);

}else{
st.pop();
node = st.peek();
st.pop();
swap(node);
}
}
return root;
}
public void swap(TreeNode node){
TreeNode tmpNode = node.left;
node.left = node.right;
node.right = tmpNode;
}
}
层序遍历
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode invertTree(TreeNode root) {
Queue<TreeNode> que = new LinkedList<>();
que.offer(root);
if(root == null) return root;
while(!que.isEmpty()){
int len = que.size();
while(len > 0){
TreeNode tmpNode = que.poll();
swap(tmpNode);
if(tmpNode.left != null){
que.offer(tmpNode.left);
}
if(tmpNode.right != null){
que.offer(tmpNode.right);
}
len--;
}
}
return root;
}
public void swap(TreeNode node){
TreeNode tmpNode = node.left;
node.left = node.right;
node.right = tmpNode;
}
}

16、对称二叉树

101. 对称二叉树 - 力扣(LeetCode)

给定一个二叉树,检查它是否是镜像对称的。

101. 对称二叉树

思路

首先想清楚,判断对称二叉树要比较的是哪两个节点,要比较的可不是左右节点!

对于二叉树是否对称,要比较的是根节点的左子树与右子树是不是相互翻转的,理解这一点就知道了其实我们要比较的是两个树(这两个树是根节点的左右子树),所以在递归遍历的过程中,也是要同时遍历两棵树。

那么遍历的顺序应该是什么样的呢?

101. 对称二叉树1

本题遍历只能是“后序遍历”,因为我们要通过递归函数的返回值来判断两个子树的内侧节点和外侧节点是否相等。

正是因为要遍历两棵树而且要比较内侧和外侧节点,所以准确的来说是一个树的遍历顺序是左右中,一个树的遍历顺序是右左中。

但都可以理解算是后序遍历,尽管已经不是严格上在一个树上进行遍历的后序遍历了。

其实后序也可以理解为是一种回溯,当然这是题外话,讲回溯的时候会重点讲的。

说到这大家可能感觉我有点啰嗦,哪有这么多道理,上来就干就完事了。别急,我说的这些在下面的代码讲解中都有身影。

那么我们先来看看递归法的代码应该怎么写。

递归法

递归三部曲

1、确定递归函数的参数和返回值

因为我们要比较的是根节点的两个子树是否是相互翻转的,进而判断这个树是不是对称树,所以要比较的是两个树,参数自然也是左子树节点和右子树节点。

返回值自然是bool类型。

1
bool compare(TreeNode left,TreeNode right)

2、确定终止条件

要比较两个节点数值相不相同,首先要把两个节点为空的情况弄清楚!否则后面比较数值的时候就会操作空指针了。

节点为空的情况有:(注意我们比较的其实不是左孩子和右孩子,所以如下我称之为左节点右节点)

  • 左节点为空,右节点不为空,不对称,return false
  • 左不为空,右为空,不对称 return false
  • 左右都为空,对称,返回true

此时已经排除掉了节点为空的情况,那么剩下的就是左右节点不为空:

  • 左右都不为空,比较节点数值,不相同就return false

此时左右节点不为空,且数值也不相同的情况我们也处理了。

1
2
3
4
if(left == null && right != null) return false;
else if(left != null && right == null) return false;
else if(left == null && right == null) return true;
else if(left.val != right.val) reutnr false;

注意上面最后一种情况,我没有使用else,而是else if, 因为我们把以上情况都排除之后,剩下的就是 左右节点都不为空,且数值相同的情况。

3、确定单层递归的逻辑

此时才进入单层递归的逻辑,单层递归的逻辑就是处理 左右节点都不为空,且数值相同的情况。

  • 比较二叉树外侧是否对称:传入的是左节点的左孩子,右节点的右孩子。
  • 比较内侧是否对称,传入左节点的右孩子,右节点的左孩子。
  • 如果左右都对称就返回true ,有一侧不对称就返回false 。
1
2
3
4
boolean outside = compare(left.left, right.right);   // 左子树:左、 右子树:右
boolean inside = compare(left.right, right.left); // 左子树:右、 右子树:左
boolean isSame = outside && inside; // 左子树:中、 右子树:中(逻辑处理)
return isSame;

我给出的代码并不简洁,但是把每一步判断的逻辑都清楚的描绘出来了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public boolean isSymmetric(TreeNode root) {
if (root == null)
return true;
return compare(root.left, root.right);
}

public boolean compare(TreeNode left, TreeNode right) {
if (left == null && right != null) {
return false;
} else if (left != null && right == null) {
return false;
} else if (left == null && right == null) {
return true;
} else if (left.val != right.val) {
return false;
}
boolean outside = compare(left.left, right.right); // 左子树:左、 右子树:右
boolean inside = compare(left.right, right.left); // 左子树:右、 右子树:左
boolean isSame = outside && inside; // 左子树:中、 右子树:中(逻辑处理)
return isSame;
}
}

如果上来就看网上各种简洁的代码,看起来真的很简单,但是很多逻辑都掩盖掉了,而题解可能也没有把掩盖掉的逻辑说清楚。

盲目的照着抄,结果就是:发现这是一道“简单题”,稀里糊涂的就过了,但是真正的每一步判断逻辑未必想到清楚。

迭代法

这道题目我们也可以使用迭代法,但要注意,这里的迭代法可不是前中后序的迭代写法,因为本题的本质是判断两个树是否是相互翻转的,其实已经不是所谓二叉树遍历的前中后序的关系了。

这里我们可以使用队列来比较两个树(根节点的左右子树)是否相互翻转,(注意这不是层序遍历)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public boolean isSymmetric(TreeNode root) {
Queue<TreeNode> deque = new LinkedList<>();
deque.offer(root.left);
deque.offer(root.right);
while (!deque.isEmpty()) {
TreeNode leftNode = deque.poll();
TreeNode rightNode = deque.poll();
if (leftNode == null && rightNode == null) {
continue;
}
// if (leftNode == null && rightNode != null) {
// return false;
// }
// if (leftNode != null && rightNode == null) {
// return false;
// }
// if (leftNode.val != rightNode.val) {
// return false;
// }
// 以上三个判断条件合并
if (leftNode == null || rightNode == null || leftNode.val != rightNode.val) {
return false;
}
// 这里顺序与使用Deque不同
deque.offer(leftNode.left);
deque.offer(rightNode.right);
deque.offer(leftNode.right);
deque.offer(rightNode.left);
}
return true;
}
}

17、完全二叉树的节点个数

222. 完全二叉树的节点个数 - 力扣(LeetCode)

给你一棵 完全二叉树 的根节点 root ,求出该树的节点个数。

完全二叉树 的定义如下:在完全二叉树中,除了最底层节点可能没填满外,其余每层节点数都达到最大值,并且最下面一层的节点都集中在该层最左边的若干位置。若最底层为第 h 层(从第 0 层开始),则该层包含 1~ 2h 个节点。

示例 1:

img

1
2
输入:root = [1,2,3,4,5,6]
输出:6

示例 2:

1
2
输入:root = []
输出:0

示例 3:

1
2
输入:root = [1]
输出:1

提示:

  • 树中节点的数目范围是[0, 5 * 104]
  • 0 <= Node.val <= 5 * 104
  • 题目数据保证输入的树是 完全二叉树

思路

递归

1、确定函数的参数和返回值,返回个数,传入节点

1
int getNodeNum(TreeNode node);

2、确定终止条件,如果是空节点的话,返回0

1
if(node == null) return 0;

3、确定单层递归逻辑,这边用先求左子树的节点数量,再求右子树的节点数量,最后总数为左子树+右子树+1

1
2
3
4
int leftNum = getNodeNum(node.left);
int rightNum = getNodeNum(node.right);
int res = leftNum + rightNum + 1;
return res;

最终的代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int countNodes(TreeNode root) {
int res = getNodeNum(root);
return res;
}

public int getNodeNum(TreeNode node) {
if (node == null)
return 0;
int leftNum = getNodeNum(node.left);
int rightNum = getNodeNum(node.right);
int res = leftNum + rightNum + 1;
return res;
}
}
迭代法也是层序遍历
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int countNodes(TreeNode root) {
Queue<TreeNode> que = new LinkedList<>();
que.offer(root);
int res = 0;
if(root == null) return 0;
while (!que.isEmpty()) {
int len = que.size();
res += len;
while (len > 0) {
TreeNode tmpNode = que.poll();
if (tmpNode.left != null) {
que.offer(tmpNode.left);
}
if (tmpNode.right != null) {
que.offer(tmpNode.right);
}
len--;
}
}
return res;
}
}
针对完全二叉树的解法

在完全二叉树中,除了最底层节点可能没填满外,其余每层节点数都达到最大层,并且最下面一层的节点都集中在该层最左边的若干位置。若最底层为第h层,则该层包含1 - 2的(h-1)次方个节点

所以完全二叉树只有两种情况

情况一:满二叉树

情况二:最后一层的叶子节点没有满

情况一可以直接用2的深度次方-1

情况二,分别递归左孩子和右孩子,递归到某一深度一定会有左孩子或右孩子为满二叉树,然后依旧可以用情况1来计算

这里关键在于如何判断一个左子树或者右子树是不是满二叉树

在完全二叉树中,如果递归向左遍历的深度等于递归向右遍历,那就说明是满二叉树,如果递归向左遍历的深度不等于递归向右遍历的深度,就不是满二叉树。

那么如果是满二叉树就利用公式计算节点数量,如果不是就继续递归其左子树和右子树+1(加上自己的节点)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
/**
* 针对完全二叉树的解法
*
* 满二叉树的结点数为:2^depth - 1
*/
public int countNodes(TreeNode root) {
if (root == null) return 0;
TreeNode left = root.left;
TreeNode right = root.right;
int leftDepth = 0, rightDepth = 0; // 这里初始为0是有目的的,为了下面求指数方便
while (left != null) { // 求左子树深度
left = left.left;
leftDepth++;
}
while (right != null) { // 求右子树深度
right = right.right;
rightDepth++;
}
if (leftDepth == rightDepth) {
return (2 << leftDepth) - 1; // 注意(2<<1) 相当于2^2,所以leftDepth初始为0
}
return countNodes(root.left) + countNodes(root.right) + 1;
}
}

18、平衡二叉树

110. 平衡二叉树 - 力扣(LeetCode)

平衡二叉树就是树的所有左右子节点高度差不为1

示例 1:

img

1
2
输入:root = [3,9,20,null,null,15,7]
输出:true

示例 2:

img

1
2
输入:root = [1,2,2,3,3,null,null,4,4]
输出:false

示例 3:

1
2
输入:root = []
输出:true

提示:

  • 树中的节点数在范围 [0, 5000] 内
  • -104 <= Node.val <= 104

但leetcode中强调的深度和高度很明显是按照节点来计算的,如图:

110.平衡二叉树2

关于根节点的深度究竟是1 还是 0,不同的地方有不一样的标准,leetcode的题目中都是以节点为一度,即根节点深度是1。但维基百科上定义用边为一度,即根节点的深度是0,我们暂时以leetcode为准(毕竟要在这上面刷题)。

因为求深度可以从上到下去查 所以需要前序遍历(中左右),而高度只能从下到上去查,所以只能后序遍历(左右中)

思路

递归

这里要求比较高度,必然是用后序遍历

递归的三部曲

1、确定递归函数的参数值和返回值

参数:当前的节点。返回值:以当前传入节点为根节点的树的高度

1
int getHeight(TreeNode node);

如果当前传入节点为根节点的二叉树已经不是二叉平衡树了,还返回高度的话就没有意义了。

所以如果已经不是二叉平衡树了,可以返回-1来标记已经不符合平衡树的规则了。

2、明确终止条件

递归的过程中依然是遇到了空节点了为终止,返回0,表示当前节点为根节点的树高度为0

1
2
3
if(node == null){
return 0;
}

3、明确单层递归的逻辑

如何判断当前传入节点为根节点的二叉树是否是平衡二叉树呢?当然是其左子树高度和其右子树高度的差值。

分别求出其左右子树的高度,然后如果差值小于等于1,则返回当前二叉树的高度,否则返回-1,表示已经不是平衡二叉树了。

1
2
3
4
5
6
7
8
9
10
11
12
13
int leftHeight = getHeight(node.left);//左
if(leftHeight == -1) return -1;
int rightHeight = getHeight(node.right);//右
if(leftHeight == -1) return -1;
int res;
//中
if(Math.abs(leftHeight - rightHeight) > 1){
res = -1;
}else{
res = 1 + Math.max(leftHeight , rightHeight);
}

return res;

最终的代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class Solution {
/**
* 递归法
*/
public boolean isBalanced(TreeNode root) {
return getHeight(root) != -1;
}

private int getHeight(TreeNode root) {
if (root == null) {
return 0;
}
int leftHeight = getHeight(root.left);
if (leftHeight == -1) {
return -1;
}
int rightHeight = getHeight(root.right);
if (rightHeight == -1) {
return -1;
}
// 左右子树高度差大于1,return -1表示已经不是平衡树了
if (Math.abs(leftHeight - rightHeight) > 1) {
return -1;
}
return Math.max(leftHeight, rightHeight) + 1;
}
}
迭代

我们可以用层序遍历来求深度,但是不能直接使用层序遍历来求高度。

这题的迭代方式,可以先定义一个函数,专门用来求高度。

这个函数可以通过栈模拟的后序遍历找到每一个节点的高度(其实是通过求传入节点为根节点的最大深度求高度)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
int getDepth(TreeNode cur){
Stack<TreeNode> stack = new Stack<>();
if(cur != null){
stack.push(cur);
}
int depth = 0;
int res = 0;
while(!stack.empty()){
TreeNode node = stack.peek();
if(node != null){
stack.pop();
stack.push(node);//中
stack.push(null);//
depth++;
if(node.right) stack.push(node.right);
if(node.left) stack.push(node.left);
}else{
stack.pop();
node = stack.peek();
stack.pop();
depth--;
}
res = res > depth ? res : depth;
}
return res;
}

然后再用栈来模拟后序遍历,遍历每一个节点的时候,再去判断左右孩子的高度是否符合

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
boolean isBalanced(TreeNode root){
Stack<TreeNode> st = new Stack<>();
if (root == NULL) return true;
st.push(root);
while (!st.empty()) {
TreeNode node = st.peek(); // 中
st.pop();
if (abs(getDepth(node.left) - getDepth(node.right)) > 1) { // 判断左右孩子高度是否符合
return false;
}
if (node.right) st.push(node.right); // 右(空节点不入栈)
if (node.left) st.push(node.left); // 左(空节点不入栈)
}
return true;
}

当然此题用迭代法,其实效率很低,因为没有很好的模拟回溯的过程,所以迭代法有很多重复的计算。

虽然理论上所有的递归都可以用迭代来实现,但是有的场景难度可能比较大。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
class Solution {
/**
* 优化迭代法,针对暴力迭代法的getHeight方法做优化,利用TreeNode.val来保存当前结点的高度,这样就不会有重复遍历
* 获取高度算法时间复杂度可以降到O(1),总的时间复杂度降为O(n)。
* 时间复杂度:O(n)
*/
public boolean isBalanced(TreeNode root) {
if (root == null) {
return true;
}
Stack<TreeNode> stack = new Stack<>();
TreeNode pre = null;
while (root != null || !stack.isEmpty()) {
while (root != null) {
stack.push(root);
root = root.left;
}
TreeNode inNode = stack.peek();
// 右结点为null或已经遍历过
if (inNode.right == null || inNode.right == pre) {
// 输出
if (Math.abs(getHeight(inNode.left) - getHeight(inNode.right)) > 1) {
return false;
}
stack.pop();
pre = inNode;
root = null;// 当前结点下,没有要遍历的结点了
} else {
root = inNode.right;// 右结点还没遍历,遍历右结点
}
}
return true;
}

/**
* 求结点的高度
*/
public int getHeight(TreeNode root) {
if (root == null) {
return 0;
}
int leftHeight = root.left != null ? root.left.val : 0;
int rightHeight = root.right != null ? root.right.val : 0;
int height = Math.max(leftHeight, rightHeight) + 1;
root.val = height;// 用TreeNode.val来保存当前结点的高度
return height;
}
}

例如:都知道回溯法其实就是递归,但是很少人用迭代的方式去实现回溯算法!

因为对于回溯算法已经是非常复杂的递归了,如果再用迭代的话,就是自己给自己找麻烦,效率也并不一定高。

19、二叉树的所有路径

257. 二叉树的所有路径 - 力扣(LeetCode)257. 二叉树的所有路径 - 力扣(LeetCode)

给你一个二叉树的根节点 root ,按 任意顺序 ,返回所有从根节点到叶子节点的路径。

叶子节点 是指没有子节点的节点。

示例 1:

img

1
2
输入:root = [1,2,3,null,5]
输出:["1->2->5","1->3"]

示例 2:

1
2
输入:root = [1]
输出:["1"]

提示:

  • 树中节点的数目在范围 [1, 100] 内
  • -100 <= Node.val <= 100

思路

这道题目要求从根节点到叶子的路径,所以需要前序遍历,这样才方便让父节点指向孩子节点,找到对应的路径。

在这道题目中将第一次涉及到回溯,因为我们要把路径记录下来,需要回溯来回退一个路径再进入另一个路径。

前序遍历以及回溯的过程如图:

257.二叉树的所有路径

我们先使用递归的方式,来做前序遍历。因为前序遍历很方便,如果不是前序遍历还需要考虑之前的固定模版或者说修改一下递归的逻辑很麻烦,回溯也很麻烦,所以还是用前序最好。

要知道递归和回溯就是一家的,本题也需要回溯。

递归

1、递归函数参数以及返回值

要传入根节点,记录每一条路径的path,和存放结果集的result,这里递归不需要返回值

1
void traversal(TreeNode cur,List<Integer> path,List<String> res);

2、确定递归终止条件

本题的终止条件,是要找到叶子节点,就开始结束的处理逻辑条件了(把路径放到res里面)

那什么时候算是找到了叶子节点?是当cur不为空,并且左右孩子都为空的时候,就找到了叶子节点。

所以终止条件是

1
2
3
if(cur.left == null && cur.right == null){
终止处理逻辑
}

为什么没有判断cur是否为空呢,因为下面的逻辑可以控制节点不入循环。

再来看一下终止处理逻辑。

这里使用List 结构path来记录路径,所以要把List结构的path转为string格式,再把这个string放进result里面。

那为什么用List结构来记录路径呢?因为下面处理单层递归逻辑的时候,要做回溯,使用List方便来做回溯。

那么终止处理逻辑如下

1
2
3
4
5
6
7
8
9
10
if (root.left == null && root.right == null) {
// 输出
StringBuilder sb = new StringBuilder();// StringBuilder用来拼接字符串,速度更快
for (int i = 0; i < paths.size() - 1; i++) {
sb.append(paths.get(i)).append("->");
}
sb.append(paths.get(paths.size() - 1));// 记录最后一个节点
res.add(sb.toString());// 收集一个路径
return;
}

那么整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
//方式一
class Solution {
/**
* 递归法
*/
public List<String> binaryTreePaths(TreeNode root) {
List<String> res = new ArrayList<>();// 存最终的结果
if (root == null) {
return res;
}
List<Integer> paths = new ArrayList<>();// 作为结果中的路径
traversal(root, paths, res);
return res;
}

private void traversal(TreeNode root, List<Integer> paths, List<String> res) {
paths.add(root.val);// 前序遍历,中
// 遇到叶子结点
if (root.left == null && root.right == null) {
// 输出
StringBuilder sb = new StringBuilder();// StringBuilder用来拼接字符串,速度更快
for (int i = 0; i < paths.size() - 1; i++) {
sb.append(paths.get(i)).append("->");
}
sb.append(paths.get(paths.size() - 1));// 记录最后一个节点
res.add(sb.toString());// 收集一个路径
return;
}
// 递归和回溯是同时进行,所以要放在同一个花括号里
if (root.left != null) { // 左
traversal(root.left, paths, res);
paths.remove(paths.size() - 1);// 回溯
}
if (root.right != null) { // 右
traversal(root.right, paths, res);
paths.remove(paths.size() - 1);// 回溯
}
}
}

20、左叶子之和

404. 左叶子之和 - 力扣(LeetCode)

计算给定二叉树的所有左叶子之和。

示例:

404.左叶子之和1

思路

首先要注意是判断左叶子,不是二叉树左侧的节点。

左叶子:节点A的左孩子不为空,并且做孩子的左右孩子都为空,说明是叶子节点,那么A节点的左孩子为左叶子节点

大家思考一下如下图中二叉树,左叶子之和究竟是多少?

404.左叶子之和 其实是0,因为这棵树根本没有左叶子!

但看这个图的左叶子之和是多少?

图二

相信通过这两个图,大家对最左叶子的定义有明确理解了。

那么判断当前节点是不是左叶子是无法判断的,必须要通过节点的父节点来判断其左孩子是不是左叶子。

如果该节点的左节点不为空,该节点的左节点的左节点为空,该节点的左节点的右节点为空,则找到了一个左叶子,判断代码如下:

1
2
3
if(node.left != null && node.left.left == null && node.left.right == null){
左叶子节点的处理逻辑
}
递归法

递归的遍历顺序为后序遍历(左右中),是因为要通过递归函数的返回值来累加求取左叶子数值之和。

我的理解就是因为是左叶子,左先会比较方便。

递归三部曲:

1、确定递归函数的参数和返回值

判断一个树的左叶子节点之和,那么一定要传入树的根节点,递归函数的返回值为数值之和,所以int

使用题目中给出的函数就可以了

2、确定终止条件

如果遍历到空节点,那么左叶子值肯定是0

1
if(root = null) return 0;

注意,只有当前遍历的节点是父节点,才能判断其子节点是不是左叶子。所以如果当前遍历的节点是叶子节点,那么其左叶子也必定是0

所以终止条件为

1
2
if(root == null) return 0;
if(root.left == null && root.right == null) return 0;

3、确定单层递归的逻辑

当遇到左叶子节点的时候,记录数值,然后通过递归求取左子树左叶子之和,和右子树左叶子之和,相加鞭尸整个树的左叶子之和。

1
2
3
4
5
6
7
8
9
int leftValue = sumOfLeftLeaves(root.left);//左
if (root.left != null && root.left.left == null && root.left.right == null) {
leftValue = root.left.val;
}
int rightValue = sumOfLeftLeaves(root.right);//右

int sum = leftValue + rightValue;//中

return sum;

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int sumOfLeftLeaves(TreeNode root) {
if (root == null)
return 0;
if (root.left == null && root.right == null)
return 0;
int leftValue = sumOfLeftLeaves(root.left);//左
if (root.left != null && root.left.left == null && root.left.right == null) {
leftValue = root.left.val;
}
int rightValue = sumOfLeftLeaves(root.right);//右

int sum = leftValue + rightValue;//中

return sum;
}
}
迭代法

本题迭代法使用前中后序都是可以的,只要把做叶子节点统计出来,就可以了,可以写一个前序遍历的迭代方法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int sumOfLeftLeaves(TreeNode root) {
int res = 0;
if(root == null) return res;
Stack<TreeNode> st = new Stack<>();
st.push(root);
while(!st.isEmpty()){
TreeNode tmpNode = st.peek();
st.pop();
//开始处理前序遍历,中左右
if(tmpNode.left != null && tmpNode.left.left == null && tmpNode.left.right == null){
res += tmpNode.left.val;
}
if(tmpNode.left != null){
st.push(tmpNode.left);
}
if(tmpNode.right != null){
st.push(tmpNode.right);
}
}
return res;
}
}
层序遍历也可以
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// 层序遍历迭代法
class Solution {
public int sumOfLeftLeaves(TreeNode root) {
int sum = 0;
if (root == null) return 0;
Queue<TreeNode> queue = new LinkedList<>();
queue.offer(root);
while (!queue.isEmpty()) {
int size = queue.size();
while (size -- > 0) {
TreeNode node = queue.poll();
if (node.left != null) { // 左节点不为空
queue.offer(node.left);
if (node.left.left == null && node.left.right == null){ // 左叶子节点
sum += node.left.val;
}
}
if (node.right != null) queue.offer(node.right);
}
}
return sum;
}
}

21、找树左下角的值

513. 找树左下角的值 - 力扣(LeetCode)

给定一个二叉树的 根节点 root,请找出该二叉树的 最底层 最左边 节点的值。

假设二叉树中至少有一个节点。

示例 1:

img

1
2
输入: root = [2,1,3]
输出: 1

示例 2:

img

1
2
输入: [1,2,3,4,null,5,6,null,null,7]
输出: 7

提示:

  • 二叉树的节点个数的范围是 [1,104]
  • -231 <= Node.val <= 231 - 1

思路

这里用层序遍历是非常简单了,反而用递归还比较难一点

层序遍历(迭代法)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import java.util.LinkedList;
import java.util.Queue;

class Solution {
public int findBottomLeftValue(TreeNode root) {
if (root == null) return 0;

Queue<TreeNode> queue = new LinkedList<>();
queue.offer(root);
int leftmostValue = root.val;

while (!queue.isEmpty()) {
int levelSize = queue.size();
leftmostValue = queue.peek().val; // 记录当前层的第一个节点值

for (int i = 0; i < levelSize; i++) {
TreeNode node = queue.poll();

if (node.left != null) {
queue.offer(node.left);
}
if (node.right != null) {
queue.offer(node.right);
}
}
}

return leftmostValue;
}
}
递归

一看这道题目用递归的话就一直向左遍历,最后一个就是答案?

并不是,一直遍历到最左到最后一个,但是并不是最后一行。

所以首先要到最后一行,然后是最左边的值。

如果是使用递归的方法,如何判断是最后一行?其实就是深度最大的叶子节点一定是最后一行。

所以要找到深度最大的叶子节点

因为求深度可以从上到下去查 所以需要前序遍历(中左右),而高度只能从下到上去查,所以只能后序遍历(左右中)

那么怎么找到最 左边?可以使用前序遍历(当然中序,后序,都可以,因为本题没有中间节点的处理逻辑,只要左优先就行),保证优先左边搜索,然后记录深度最大的叶子节点,此时就是树的最后一行最左边的值。

递归三部曲:

1、确定递归函数的参数和返回值

参数必须有要遍历的树的根节点,还有就是一个int类型的变量用来记录最长深度。这里就不需要返回值了,所以递归函数的返回类型为void。

本体还需要两个全局变量,maxDepth来记录最大深度,res记录最大深度最左节点的数值

1
2
3
int maxDepth = -1;
int res ;
void traversal(TreeNode root ,int depth);

2、确定终止条件

当遇到叶子节点的时候,就需要统计一下最大的深度了,所以幻遇到叶子节点来更新最大深度

1
2
3
4
5
6
7
if(root.left == null && root.right == null){
if(depth > maxDepth){
maxDepth = depth;//更新最大深度
res = root.val;
}
return;
}

3、确定单层递归的逻辑

在找最大深度的时候,递归的过程中依然要使用回溯

1
2
3
4
5
6
7
8
9
10
11
12
13
14
//中
if(root.left != null){
//左
depth++;
traversal(root.left,depth);
depth--;//回溯,深度-1
}
if(root.right != null){
//右
depth++;
traversal(root.right,depth);
depth--;
}
return;

完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
// 递归法
class Solution {
private int Deep = -1;
private int value = 0;
public int findBottomLeftValue(TreeNode root) {
value = root.val;
findLeftValue(root,0);
return value;
}

private void findLeftValue (TreeNode root,int deep) {
if (root == null) return;
if (root.left == null && root.right == null) {
if (deep > Deep) {
value = root.val;
Deep = deep;
}
}
if (root.left != null) findLeftValue(root.left,deep + 1);
if (root.right != null) findLeftValue(root.right,deep + 1);
}
}

22、路径总和

112. 路径总和 - 力扣(LeetCode)

给你二叉树的根节点 root 和一个表示目标和的整数 targetSum 。判断该树中是否存在 根节点到叶子节点 的路径,这条路径上所有节点值相加等于目标和 targetSum 。如果存在,返回 true ;否则,返回 false 。

叶子节点 是指没有子节点的节点。

示例 1:

img

1
2
3
输入:root = [5,4,8,11,null,13,4,7,2,null,null,null,1], targetSum = 22
输出:true
解释:等于目标和的根节点到叶节点路径如上图所示。

示例 2:

img

1
2
3
4
5
6
输入:root = [1,2,3], targetSum = 5
输出:false
解释:树中存在两条根节点到叶子节点的路径:
(1 --> 2): 和为 3
(1 --> 3): 和为 4
不存在 sum = 5 的根节点到叶子节点的路径。

示例 3:

1
2
3
输入:root = [], targetSum = 0
输出:false
解释:由于树是空的,所以不存在根节点到叶子节点的路径。

提示:

  • 树中节点的数目在范围 [0, 5000] 内
  • -1000 <= Node.val <= 1000
  • -1000 <= targetSum <= 1000

思路

递归

可以使用深度优先比那里的方式(本题前中后序都可以)

三部曲

1、确定递归函数的参数和返回类型

参数:需要二叉树的根节点,还需要一个计数器,这个计数器用来计算二叉树的一条边之和是否正好是目标和,计数器为int型。

再看看返回值,递归函数什么时候需要返回值?什么时候不需要返回值?

  • 如果需要搜索整个二叉树且不用处理递归返回值,递归函数就不要返回值。(路径总和2)
  • 如果需要搜索整颗二叉树且需要处理递归返回值,递归函数就需要返回值、
  • 如果要搜索其中一条符合条件的路径,那么递归一定需要返回值,因为遇到符合条件的路径了就要及时返回。(路径总和)

而本题我们要找一条符合条件的路径,所以递归函数需要返回值,及时返回,那么返回类型是什么?

如图所示:

112.路径总和

图中可以看出,遍历的路线,并不要遍历整棵树,所以递归函数需要返回值,可以用bool类型表示。

1
boolean traversal(TreeNode cur, int count)//注意函数的返回类型

2、确定终止条件

首先计数器如何统计这一条路径的和呢?

不要去累加然后判断是否等于目标和,那么代码比较麻烦,可以用递减,让计数器count初始为目标和,然后每次减去遍历路径节点上的数值。

如果最后count==0,同时到了叶子节点的话,说明找到了目标和。

如果遍历到了叶子节点,count不为0,就是没有找到。

递归终止条件代码如下

1
2
if(cur.left == null && cur.right == null && count == 0) return true;
if(cur.left == null && cur.right == null) return false;

3、确定单层递归的逻辑

因为终止条件是判断叶子节点,所以递归的过程中久不要让空节点进入递归了。

递归函数是有返回值的,如果递归函数返回true,说明找到了合适的路径,应该立刻返回。

1
2
3
4
5
6
7
8
9
if(cur.left != null){
if(traversal(cur.left,count - cur.left.val))
return true;
}
if(cur.right != null){
if(traversal(cur.right,count - cur.right.val))
return true;
}
return false;

以上代码中是包含着回溯的,没有回溯,如何后撤重新找到另一条路径呢

回溯隐藏在traversal(cur.left,count - cur.left.val),因为count-cur.left.val直接作为参数传进去,函数结束,count的数值没有改变。

为了把回溯体现出来,可以改为

1
2
3
4
5
6
7
8
9
10
11
12
13
if(cur.left != null){
count -= cur.left.val;
if(traversal(cur.left,count))
return true;
count += cur.left.val;
}
if(cur.right != null){
count -= cur.right.val;
if(traversal(cur.right,count))
return true;
count += cur.right.val;
}
return false;

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public boolean hasPathSum(TreeNode root, int targetSum) {
int count = targetSum;

if(root == null){
return false;
}
count -= root.val;
return traversal(root,count);
}
public boolean traversal(TreeNode cur,int count){
//1、确定终止条件
if(cur.left == null && cur.right == null && count == 0){
return true;
}
if(cur.left == null && cur.right == null){
return false;
}
//2、处理单层递归逻辑
if(cur.left != null){
count -= cur.left.val;
if(traversal(cur.left,count)){
return true;
}
count += cur.left.val;
}
if(cur.right != null){
count -= cur.right.val;
if(traversal(cur.right,count)){
return true;
}
count += cur.right.val;
}
return false;
}
}
迭代

如果使用栈模拟递归,如何回溯?

此时栈里面一个元素不仅要记录节点指针,还要记录从头节点到该节点的路径数值总和。

我们可以用两个栈,一个栈控制访问节点,一个栈控制sum

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public boolean hasPathSum(TreeNode root, int targetSum) {
if(root == null) return false;
Stack<TreeNode> st1 = new Stack<>();
Stack<Integer> st2 = new Stack<>();
st1.push(root);
st2.push(root.val);
while(!st1.isEmpty()){
int len = st1.size();

while(len > 0){
TreeNode tmpNode = st1.pop();
int sum = st2.pop();
if(tmpNode.left == null && tmpNode.right == null && sum == targetSum){
return true;
}
if(tmpNode.left != null){
st1.push(tmpNode.left);
st2.push(sum + tmpNode.left.val);
}
if(tmpNode.right != null){
st1.push(tmpNode.right);
st2.push(sum + tmpNode.right.val);

}
len--;
}
}
return false;
}
}

23、路径总和2

113. 路径总和 II - 力扣(LeetCode)

给你二叉树的根节点 root 和一个整数目标和 targetSum ,找出所有 从根节点到叶子节点 路径总和等于给定目标和的路径。

叶子节点 是指没有子节点的节点。

示例 1:
img

1
2
输入:root = [5,4,8,11,null,13,4,7,2,null,null,5,1], targetSum = 22
输出:[[5,4,11,2],[5,8,4,5]]

示例 2:

img

1
2
输入:root = [1,2,3], targetSum = 5
输出:[]

示例 3:

1
2
输入:root = [1,2], targetSum = 0
输出:[]

提示:

  • 树中节点总数在范围 [0, 5000] 内
  • -1000 <= Node.val <= 1000
  • -1000 <= targetSum <= 1000

思路

要遍历整个树,找到所有路径,所以递归函数不要返回值!

如图:

113.路径总和ii

递归三部曲

1、确定递归函数的返回值和参数

返回值是void,参数需要1个根节点、一个目标和,一个存储结果的数组,一个存储路径的path数组 这里用前序方便点,当然也可以使用统一的中序和后序

1
public void preOrderDfs(TreeNode root, int targetSum,List<List<Integer>> res,List<Integer> path);

2、确定终止条件

1
2
3
4
5
6
if(root.left == null && root.right == null){
if(targetSum - root.val == 0){
res.add(new ArrayList<>(path));
}
return;
}

3、确定单层递归逻辑

1
2
3
4
5
6
7
8
9
if(root.left != null){
preOrderDfs(root.left, targetSum - root.val,res,path);
path.remove(path.size() - 1);//回溯,去除最后一个
}
if (root.right != null) {
preOrderDfs(root.right, targetSum - root.val, res, path);
path.remove(path.size() - 1); // 回溯
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public List<List<Integer>> pathSum(TreeNode root, int targetSum) {

List<List<Integer>> res = new ArrayList<>();
List<Integer> path = new ArrayList<>();
if(root == null) return res;
preOrderDfs(root,targetSum,res,path);
return res;
}
public void preOrderDfs(TreeNode root,int targetSum,List<List<Integer>> res,List<Integer> path){
path.add(root.val);
//1、确定终止条件
if(root.left == null && root.right == null){
if(targetSum == root.val){
res.add(new ArrayList<>(path));
}
return;
}
//2、确定单层递归逻辑
if(root.left != null){
preOrderDfs(root.left,targetSum - root.val,res,path);
path.remove(path.size() - 1);//回溯
}
if(root.right != null){
preOrderDfs(root.right,targetSum - root.val,res,path);
path.remove(path.size() - 1);//回溯
}
}
}

24、从中序与后序遍历序列构造二叉树

106. 从中序与后序遍历序列构造二叉树 - 力扣(LeetCode)

给定两个整数数组 inorder 和 postorder ,其中 inorder 是二叉树的中序遍历, postorder 是同一棵树的后序遍历,请你构造并返回这颗 二叉树 。

示例 1:
img

1
2
输入:inorder = [9,3,15,20,7], postorder = [9,15,7,20,3]
输出:[3,9,20,null,null,15,7]

示例 2:

1
2
输入:inorder = [-1], postorder = [-1]
输出:[-1]

提示:

  • 1 <= inorder.length <= 3000
  • postorder.length == inorder.length
  • -3000 <= inorder[i], postorder[i] <= 3000
  • inorder 和 postorder 都由 不同 的值组成
  • postorder 中每一个值都在 inorder 中
  • inorder 保证是树的中序遍历
  • postorder 保证是树的后序遍历

思路

首先要回忆一下怎么根据两个顺序构造一个唯一的二叉树。

先自己画一画找找感觉

以后序数组的最后一个元素为切割点,先切中序数组,根据中序数组,反过来再切后序数组。一层一层切下去,每次后序数组最后一个元素就是节点元素。

如果让我们肉眼看两个序列,画一棵二叉树的话,应该分分钟都可以画出来。

流程如图:

106.从中序与后序遍历序列构造二叉树

那么代码应该怎么写呢?

说到一层一层切割,就应该想到了递归。

来看一下一共分几步:

  • 第一步:如果数组大小为零的话,说明是空节点了。
  • 第二步:如果不为空,那么取后序数组最后一个元素作为节点元素。
  • 第三步:找到后序数组最后一个元素在中序数组的位置,作为切割点
  • 第四步:切割中序数组,切成中序左数组和中序右数组 (顺序别搞反了,一定是先切中序数组)
  • 第五步:切割后序数组,切成后序左数组和后序右数组
  • 第六步:递归处理左区间和右区间

不难写出下面代码(先把框架写出来)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
TreeNode traversal(List<Integer> inorder,List<Integer> postorder){
//第一步
if(postorder.size() == null) return null;

//第二步:后序遍历数组最后一个元素,就是当前的中间节点
int rootValue = postorder[postorder.size() - 1];
TreeNode root = new TreeNode(rootValue);

//叶子节点
if(postorder.size() == 1) return root;

//第三步:找到切割点
int delimiterIndex;
for(delimiterIndex = 0; delimiterIndex < inorder.size();delimiterIndex++){
if(inorder[delimiterIndex] == rootValue)
break;
}

//第四部:切割中序数组,得到 中序左数组和中序右数组
//第五步:切割后序数组,得到 后序左数组和后续右数组

//第六步
root.left = traversal(中序左数组,后序左数组);
root.right = traversal(中序右数组,后序右数组);

return root;
}

难点在于,如何切割,以及边界值找不好很容易乱套

此时应该注意确定切割的标准,是左闭右开,还是左开右闭,还是左闭右闭,这个就是不变量,要在递归中保持这个不变量。

在切割的过程中会产生四个区间,把握不好不变量的话,一会左闭右开,一会左闭右闭,必然乱套!

首先要切割中序数组,为什么先切割中序数组呢?

切割点在后续数组的最后一个元素,就是这个元素来切割中序数组的,所以必要先切割中序师数组。

中序数组相对比较好切,找到切割点(后序数组的最后一个元素)在中序数组的位置,然后切割,下面的代码我坚持左闭右开的原则

1
2
3
4
5
6
7
8
9
10
//找到中序遍历的切割点
int delimiterIndex;
for(delimiterIndex = 0 ; delimiterIndex < inorder.size();delimiterIndex++){
if(inorder[delimiterIndex] == rootValue)
break;
}
//左闭右开区间:[0,delimiterIndex)
List<Integer> leftInorder = new ArrayList<>(inorder.subList(中序数组的开始,中序数组的开始+delimiterIndex));
//[delimiterIndex + 1, end)
List<Integer> rightInorder = new ArrayList<>(inorder.subList(中序数组的开始+delimiterIndex+1,inorder.size() ) );

接下来要切割后序数组了。

首先后序数组的最后一个元素制定不能要了,这是切割点 也是 当前二叉树中间节点的元素,已经用了。

后序数组的切割点怎么找?

后序数组没有明确的元素来进行左右切割,不想中序数组有明确的切割点,切割点左右分开就可以了。

此时有一个很重要的点,就是中序数组大小一定是和后续数组的大小相同的

中序数组我们都切成了左中序数组和右中序数组了,那么后续数组就可以按照左中序数组的大小来切割,切成左后序数组和右后序数组。

1
2
3
4
5
6
7
//postorder舍弃末尾元素,因为这个元素是中间节点,已经用过了
postorder.remove(postorder.size() - 1);

//左闭右开,注意这里使用了左中序数组大小作为切割点:[0,leftInorder.size() )
List<Integer> leftPostorder(后序数组的开始,postorder.subList(后序数组的开始 + leftInorder.size() ));
//[leftInorder.size(), postorder.size);
List<Integer> rightPostorder(后序数组的开始 + leftorder.size(), postorder.size());

此时已经切好了,可以递归了

1
2
root.left = traversal(leftInorder,leftPostorder);
root.right = traversal(rightInorder,rightPostorder);

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
class Solution {
public TreeNode buildTree(int[] inorder, int[] postorder) {
if(postorder.length == 0 || inorder.length == 0)
return null;
return buildHelper(inorder, 0, inorder.length, postorder, 0, postorder.length);

}
private TreeNode buildHelper(int[] inorder, int inorderStart, int inorderEnd, int[] postorder, int postorderStart, int postorderEnd){
if(postorderStart == postorderEnd)
return null;
int rootVal = postorder[postorderEnd - 1];
TreeNode root = new TreeNode(rootVal);
int middleIndex;
for (middleIndex = inorderStart; middleIndex < inorderEnd; middleIndex++){
if(inorder[middleIndex] == rootVal)
break;
}

int leftInorderStart = inorderStart;
int leftInorderEnd = middleIndex;
int rightInorderStart = middleIndex + 1;
int rightInorderEnd = inorderEnd;


int leftPostorderStart = postorderStart;
int leftPostorderEnd = postorderStart + (middleIndex - inorderStart);
int rightPostorderStart = leftPostorderEnd;
int rightPostorderEnd = postorderEnd - 1;
root.left = buildHelper(inorder, leftInorderStart, leftInorderEnd, postorder, leftPostorderStart, leftPostorderEnd);
root.right = buildHelper(inorder, rightInorderStart, rightInorderEnd, postorder, rightPostorderStart, rightPostorderEnd);

return root;
}
}

25、从前序与中序遍历序列构造二叉树

105. 从前序与中序遍历序列构造二叉树 - 力扣(LeetCode)

根据一棵树的前序遍历与中序遍历构造二叉树。

注意: 你可以假设树中没有重复的元素。

例如,给出

前序遍历 preorder = [3,9,20,15,7] 中序遍历 inorder = [9,3,15,20,7] 返回如下的二叉树:

105. 从前序与中序遍历序列构造二叉树

思路

首先先想一下怎么样做,画画图回忆一下,首先找到前序遍历的第一个元素,然后在中序遍历找到对应的元素,然后切割中序遍历数组,这样就变成了左中序数组,右中序数组,那么这时候记住

前序遍历数组大小始终会和中序遍历的大小一致,那么时候就利用左中序数组和右中序数组来分隔前序数组变成左前序数组和右前序数组,然后一层一层的递归

这时候递归三部曲

1、确定函数的参数和返回值

返回值返回根节点,前序数组,前序数组开始点,前序数组结束点,中序数组,中序数组开始点,中序数组结束点。

1
public TreeNode buildHelper(List<Integer> preorder,int preStart,int preEnd,List<Integer> inorder,int inStart,int inEnd);

2、确定结束条件

当数组为0也就是遍历结束了

1
if(preStart == preEnd) return null;

3、确定单层遍历条件

  • 找到前序数组的第一个数也就是preStart当做根节点
  • 找到之后遍历中序数组,然后找到然后更新左中序数组的开始和结束,右中序数组的开始和结束
  • 然后再更新前序的做前序的开始和结束,右前序数组的开始和结束就分隔好前序数组了
  • 最后递归

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode buildTree(int[] preorder, int[] inorder) {
if (preorder == null || inorder == null || preorder.length != inorder.length) {
return null;
}

// 构建中序遍历的值到索引的映射,加快查找速度
Map<Integer, Integer> map = new HashMap<>();
for (int i = 0; i < inorder.length; i++) {
map.put(inorder[i], i);
}

return buildHelper(preorder, 0, preorder.length - 1,
inorder, 0, inorder.length - 1, map);
}

private TreeNode buildHelper(int[] preorder, int preStart, int preEnd,
int[] inorder, int inStart, int inEnd, Map<Integer, Integer> map) {
if (preStart > preEnd || inStart > inEnd) {
return null;
}

int rootVal = preorder[preStart];
TreeNode root = new TreeNode(rootVal);

int inRoot = map.get(rootVal); // 在中序数组中找到根节点的位置
int leftSubtreeSize = inRoot - inStart;

// 递归构建左右子树
root.left = buildHelper(preorder, preStart + 1, preStart + leftSubtreeSize,
inorder, inStart, inRoot - 1, map);
root.right = buildHelper(preorder, preStart + leftSubtreeSize + 1, preEnd,
inorder, inRoot + 1, inEnd, map);

return root;
}
}

26、最大二叉树

654. 最大二叉树 - 力扣(LeetCode)

给定一个不重复的整数数组 nums 。 最大二叉树 可以用下面的算法从 nums 递归地构建:

  1. 创建一个根节点,其值为 nums 中的最大值。
  2. 递归地在最大值 左边 的 子数组前缀上 构建左子树。
  3. 递归地在最大值 右边 的 子数组后缀上 构建右子树。

返回 nums 构建的 最大二叉树\ 。

示例 1:

img

1
2
3
4
5
6
7
8
9
10
11
12
输入:nums = [3,2,1,6,0,5]
输出:[6,3,5,null,2,0,null,null,1]
解释:递归调用如下所示:
- [3,2,1,6,0,5] 中的最大值是 6 ,左边部分是 [3,2,1] ,右边部分是 [0,5] 。
- [3,2,1] 中的最大值是 3 ,左边部分是 [] ,右边部分是 [2,1] 。
- 空数组,无子节点。
- [2,1] 中的最大值是 2 ,左边部分是 [] ,右边部分是 [1] 。
- 空数组,无子节点。
- 只有一个元素,所以子节点是一个值为 1 的节点。
- [0,5] 中的最大值是 5 ,左边部分是 [0] ,右边部分是 [] 。
- 只有一个元素,所以子节点是一个值为 0 的节点。
- 空数组,无子节点。

示例 2:

img

1
2
输入:nums = [3,2,1]
输出:[3,null,2,null,1]

提示:

  • 1 <= nums.length <= 1000
  • 0 <= nums[i] <= 1000
  • nums 中的所有整数 互不相同

思路

其实这个思路跟前面两题的思路很像,只不过是具体的逻辑细微不同

接下来想递归的三部曲

1、递归的参数和返回值

参数:

返回值肯定是根节点

1
public TreeNode (int[] nums,int numsStart,int numsEnd);

2、终止条件

因为我们是要分隔数组的所以到最后肯定有一左一右,肯定有数组长度为1,当只剩最后一个的时候,把节点值一赋值,就结束了

1
2
3
4
if(numsStart == numsEnd){
TreeNode node = new TreeNode(nums[numsStart]);
return node;
}

3、确定单层递归的逻辑

  • 先找到数组中的最大值和他的下标,用最大的下标当做根节点,,下标用来分隔数组
1
2
3
4
5
6
7
8
9
int max = 0;
int maxIndex = numsStart;
for(int i = numsStart ; i < numsEnd ; i++){
if(nums[i] > max){
max = nums[i];
maxIndex = i;
}
}
TreeNode node = new TreeNode(max);
  • 分隔数组
1
2
3
4
int leftStart = numsStart;
int leftEnd = maxIndex;
int rightStart = maxIndex + 1;
int rightEnd = numsEnd;

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode constructMaximumBinaryTree(int[] nums) {
return buildHelper(nums, 0, nums.length);
}

public TreeNode buildHelper(int[] nums, int numsStart, int numsEnd) {
if (numsStart == numsEnd) {

return null;
}

int max = 0;
int maxIndex = numsStart;
for (int i = numsStart; i < numsEnd; i++) {
if (nums[i] > max) {
max = nums[i];
maxIndex = i;
}
}
TreeNode node = new TreeNode(max);

int leftStart = numsStart;
int leftEnd = maxIndex;

int rightStart = maxIndex + 1;
int rightEnd = numsEnd;

node.left = buildHelper(nums,leftStart,leftEnd);
node.right = buildHelper(nums,rightStart,rightEnd);

return node;
}
}

27、合并二叉树

617. 合并二叉树 - 力扣(LeetCode)

给你两棵二叉树: root1 和 root2 。

想象一下,当你将其中一棵覆盖到另一棵之上时,两棵树上的一些节点将会重叠(而另一些不会)。你需要将这两棵树合并成一棵新二叉树。合并的规则是:如果两个节点重叠,那么将这两个节点的值相加作为合并后节点的新值;否则,不为 null 的节点将直接作为新二叉树的节点。

返回合并后的二叉树。

注意: 合并过程必须从两个树的根节点开始。

示例 1:

img

1
2
输入:root1 = [1,3,2,5], root2 = [2,1,3,null,4,null,7]
输出:[3,4,5,5,4,null,7]

示例 2:

1
2
输入:root1 = [1], root2 = [1,2]
输出:[2,2]

提示:

  • 两棵树中的节点数目在范围 [0, 2000] 内
  • -104 <= Node.val <= 104

思路

其实和遍历一个树的逻辑是一样的,只不过传入两个树的节点,同时操作

递归

二叉树使用递归,哪种遍历都是可以的

那么我们用前序递归方便点

递归三部曲

1、确定递归函数的参数和返回值

首先要合入两个二叉树,那么参数至少要传入二叉树的根节点,返回值就是合并之后二叉树的根节点

1
TreeNode mergerTree(TreeNode t1, TreeNode t2);

2、确定终止条件

因为是传入了两个树,那么就有两个树遍历的节点t1和t2,如果t1==null了,两个树合并就是t2了(如果t2是null也无所谓,合并之后就是null)

反过来如果t2==null,那么两个数合并就是t1

1
2
if(t1 == null) return t2;
if(t2 == null) return t1;

3、确定单层递归的逻辑

单层递归的逻辑就比较好写了,这里我们重复利用一下这个t1这个树,t1就是合并之后树的根节点

那么单层递归中,就是把两个树的元素加到一起

1
t1.val += t2.val;

接下来t1的左子树是:合并t1左子树t2左子树之后的左子树。

t1的右子树:是 合并t1右子树t2右子树之后的右子树

最终t1就是合并之后的根节点

1
2
3
t1.left = mergeTree(t1.left,t2.left);
t1.right = mergeTree(t1.right,t2.right);
return t1;

此时前序遍历,完整代码就出来了

1
2
3
4
5
6
7
8
9
10
11
12
class Solution {
// 递归
public TreeNode mergeTrees(TreeNode root1, TreeNode root2) {
if (root1 == null) return root2;
if (root2 == null) return root1;

root1.val += root2.val;
root1.left = mergeTrees(root1.left,root2.left);
root1.right = mergeTrees(root1.right,root2.right);
return root1;
}
}

迭代法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
class Solution {
// 使用栈迭代
public TreeNode mergeTrees(TreeNode root1, TreeNode root2) {
if (root1 == null) {
return root2;
}
if (root2 == null) {
return root1;
}
Stack<TreeNode> stack = new Stack<>();
stack.push(root2);
stack.push(root1);
while (!stack.isEmpty()) {
TreeNode node1 = stack.pop();
TreeNode node2 = stack.pop();
node1.val += node2.val;
if (node2.right != null && node1.right != null) {
stack.push(node2.right);
stack.push(node1.right);
} else {
if (node1.right == null) {
node1.right = node2.right;
}
}
if (node2.left != null && node1.left != null) {
stack.push(node2.left);
stack.push(node1.left);
} else {
if (node1.left == null) {
node1.left = node2.left;
}
}
}
return root1;
}
}

迭代法层序遍历

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Solution {
// 使用队列迭代
public TreeNode mergeTrees(TreeNode root1, TreeNode root2) {
if (root1 == null) return root2;
if (root2 ==null) return root1;
Queue<TreeNode> queue = new LinkedList<>();
queue.offer(root1);
queue.offer(root2);
while (!queue.isEmpty()) {
TreeNode node1 = queue.poll();
TreeNode node2 = queue.poll();
// 此时两个节点一定不为空,val相加
node1.val = node1.val + node2.val;
// 如果两棵树左节点都不为空,加入队列
if (node1.left != null && node2.left != null) {
queue.offer(node1.left);
queue.offer(node2.left);
}
// 如果两棵树右节点都不为空,加入队列
if (node1.right != null && node2.right != null) {
queue.offer(node1.right);
queue.offer(node2.right);
}
// 若node1的左节点为空,直接赋值
if (node1.left == null && node2.left != null) {
node1.left = node2.left;
}
// 若node1的右节点为空,直接赋值
if (node1.right == null && node2.right != null) {
node1.right = node2.right;
}
}
return root1;
}
}

28、二叉搜索树中的搜索

700. 二叉搜索树中的搜索 - 力扣(LeetCode)

给定二叉搜索树(BST)的根节点 root 和一个整数值 val。

你需要在 BST 中找到节点值等于 val 的节点。 返回以该节点为根的子树。 如果节点不存在,则返回 null 。

示例 1:

img

1
2
输入:root = [4,2,7,1,3], val = 2
输出:[2,1,3]

示例 2:

img

1
2
输入:root = [4,2,7,1,3], val = 5
输出:[]

提示:

  • 树中节点数在 [1, 5000] 范围内
  • 1 <= Node.val <= 107
  • root 是二叉搜索树
  • 1 <= val <= 107

思路

就遍历二叉搜索树,用值来比较如果比节点大在右边,否则在左边,如果相等返回节点

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode searchBST(TreeNode root, int val) {
if(root == null) return null;
if(root.val == val){
return root;
}
if(val > root.val){
return searchBST(root.right,val);
}else{
return searchBST(root.left,val);
}

}
}

或者用迭代,这里不用栈了,因为可以一路找下去,利用二叉搜索树的性质

1
2
3
4
5
6
7
8
9
10
class Solution {
// 迭代,利用二叉搜索树特点,优化,可以不需要栈
public TreeNode searchBST(TreeNode root, int val) {
while (root != null)
if (val < root.val) root = root.left;
else if (val > root.val) root = root.right;
else return root;
return null;
}
}

29、二叉搜索树的最小绝对差

530. 二叉搜索树的最小绝对差 - 力扣(LeetCode)

给你一个二叉搜索树的根节点 root ,返回 树中任意两不同节点值之间的最小差值 。

差值是一个正数,其数值等于两值之差的绝对值。

示例 1:

img

1
2
输入:root = [4,2,6,1,3]
输出:1

示例 2:

img

1
2
输入:root = [1,0,48,null,null,12,49]
输出:1

提示:

  • 树中节点的数目范围是 [2, 104]
  • 0 <= Node.val <= 105

思路

递归法

二叉搜索树采用中序遍历,其实就是一个有序数组。

在一个有序数组上求两个树最小差值,这不就是一道送分题了

最直观的就是把二叉搜索树转换成有序数组,然后遍历一遍数组,就统计出来最小值了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42

/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
List<Integer> nums = new ArrayList<>();

public int getMinimumDifference(TreeNode root) {
getNums(root); // 中序遍历填充 nums

int minDiff = Integer.MAX_VALUE;
// 遍历有序列表,计算相邻元素的差值
for (int i = 1; i < nums.size(); i++) {
int diff = nums.get(i) - nums.get(i - 1); // 因为升序,所以不用 Math.abs
minDiff = Math.min(minDiff, diff);
}

return minDiff;
}

public void getNums(TreeNode node) {
if (node == null) {
return;
}

getNums(node.left); // 左
nums.add(node.val); // 中
getNums(node.right); // 右
}
}

但是其实在二叉搜索树中序遍历的过程中,我们就可以直接计算了

需要用一个pre节点记录一下cur节点的前一个节点。

如图:

530.二叉搜索树的最小绝对差

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
TreeNode pre; // 记录上一个遍历的结点
int result = Integer.MAX_VALUE;

public int getMinimumDifference(TreeNode root) {
if (root == null)
return 0;
traversal(root);
return result;
}

public void traversal(TreeNode root) {
if (root == null)
return;
// 左
traversal(root.left);
// 中
if (pre != null) {
result = Math.min(result, root.val - pre.val);
}
pre = root;
// 右
traversal(root.right);
}
}
迭代法

统一迭代法来中序遍历

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
class Solution {
public int getMinimumDifference(TreeNode root) {
Stack<TreeNode> stack = new Stack<>();
TreeNode pre = null;
int result = Integer.MAX_VALUE;

if (root != null)
stack.push(root);

// 中序遍历(左中右),由于栈先入后出,反序(右中左)
while (!stack.isEmpty()) {
TreeNode curr = stack.peek();
if (curr != null) {
stack.pop();
// 右
if (curr.right != null)
stack.add(curr.right);
// 中(先用null标记)
stack.add(curr);
stack.add(null);
// 左
if (curr.left != null)
stack.add(curr.left);
} else { // 中(遇到null再处理)
stack.pop();
TreeNode temp = stack.pop();
if (pre != null)
result = Math.min(result, temp.val - pre.val);
pre = temp;
}
}
return result;
}
}

30、二叉搜索树中的众数

501. 二叉搜索树中的众数 - 力扣(LeetCode)

给你一个含重复值的二叉搜索树(BST)的根节点 root ,找出并返回 BST 中的所有 众数(即,出现频率最高的元素)。

如果树中有不止一个众数,可以按 任意顺序 返回。

假定 BST 满足如下定义:

  • 结点左子树中所含节点的值 小于等于 当前节点的值
  • 结点右子树中所含节点的值 大于等于 当前节点的值
  • 左子树和右子树都是二叉搜索树

示例 1:

img

1
2
输入:root = [1,null,2,2]
输出:[2]

示例 2:

1
2
输入:root = [0]
输出:[0]

提示:

  • 树中节点的数目在范围 [1, 104] 内
  • -105 <= Node.val <= 105

思路

这道题目呢,递归法我从两个维度来讲。

首先如果不是二叉搜索树的话,应该怎么解题,是二叉搜索树,又应该如何解题,两种方式做一个比较,可以加深大家对二叉树的理解。

递归法暴力法

如果不是二叉搜索树,最直观的方法就是把这个树都便利了,用map统计频率然后把频率排序,最后取最高频率的集合

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
private Map<Integer,Integer> countMap = new HashMap<>();
public int[] findMode(TreeNode root) {
//暴力破解
if(root == null){
return new int[0];
}

//第一步遍历整个树,统计每个数字出现的次数
countNum(root);

//第二步 找到最大出现次数
int maxCount = Collections.max(countMap.values());

//第三步:把所有出现次数等于最大次数的数字加入结果
List<Integer> res = new ArrayList<>();
for(int value : countMap.keySet()){
if(countMap.get(value) == maxCount){
res.add(value);
}
}

//把List转成int[] 数组返回
return res.stream().mapToInt(Integer::intValue).toArray();
}

public void countNum(TreeNode node){
if(node == null){
return;
}

//把当前节点的值出现次数+1
countMap.put(node.val,countMap.getOrDefault(node.val, 0) + 1);

//继续遍历左右
countNum(node.left);
countNum(node.right);

}
}

是二叉搜索树,那么他的中序遍历就是有序的,那么这时候把他变成有序数组,然后遍历有序数组,取出频率最高的。

遍历一次数组然后把他们放到map里面

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
import java.util.*;

/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int[] findMode(TreeNode root) {
if (root == null) {
return new int[0];
}

// 第一步:中序遍历得到所有节点值
List<Integer> list = new ArrayList<>();
inorder(root, list);

// 第二步:统计每个值的出现次数
Map<Integer, Integer> countMap = new HashMap<>();
for (int val : list) {
countMap.put(val, countMap.getOrDefault(val, 0) + 1);
}

// 第三步:找出最大频率
int maxCount = Collections.max(countMap.values());

// 第四步:收集所有出现次数等于最大频率的值
List<Integer> result = new ArrayList<>();
for (int val : countMap.keySet()) {
if (countMap.get(val) == maxCount) {
result.add(val);
}
}

// 第五步:转成 int[] 返回
return result.stream().mapToInt(Integer::intValue).toArray();
}

// 中序遍历:把结果添加到传入的 list 中(避免返回 null)
private void inorder(TreeNode node, List<Integer> list) {
if (node == null) {
return;
}
inorder(node.left, list); // 左
list.add(node.val); // 中
inorder(node.right, list); // 右
}
}
天才递归法

那么怎么在树上直接操作呢?

在搜索树的最小绝对差的时候我们用了pre指针和cur指针的技巧,这里也能用,弄一个指针指向前一个节点,这样每次cur才能和pre作比较,而且初始化的时候pre==null,这样当pre为null的时候,我们就知道这是比较的第一个元素。

1
2
3
4
5
6
7
8
if(pre == null){//第一个节点
count = 1;//频率为1
}else if(pre.val == cur.val){//与前一个节点数值相同
count++;
}else{//与前一个节点数值不同
count = 1;
}
pre = cur;//更新上一个节点

此时又有问题了,因为要求最大频率的元素集合 注意是集合,不是一个元素,可以有多个众数,如果是数组上的话。

应该是遍历一遍数组,找到最大频率,然后再重新遍历一遍数组把出现频率为maxCount的元素放进集合。(因为众数有多个)

这种方式就遍历了两遍数组

那么我们遍历两遍二叉树,把众数集合算出来也是可以的。

但这里其实只需要遍历一次就可以找到所有的众数。

那么如何只遍历一遍呢?

如果 频率count等于maxCount(最大频率),当然要把这个元素加入到结果集中

1
2
3
if(count == maxCount){
res.add(cur.val);
}

此时又有问题了,res怎么能轻易就把元素放进去了呢?万一,这个maxCount此时还不是真正最大频率呢?

所以下面要做如下操作

频率count大于maxCount的时候,不仅要更新maxCount,而且要清空结果集,因为结果集之前的元素都失效了

下面是天才的代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
class Solution {
//全局共享变量
ArrayList<Integer> resList;//结果List
int maxCount;//最大频率
int count;//频率对应的数
TreeNode pre;//前一个节点

public int[] findMode(TreeNode root) {
//初始化变量
resList = new ArrayList<>();
maxCount = 0;
count = 0;
pre = null;

//执行中序遍历并完成resList
findMode1(root);

//把List变成int[]
int[] res = new int[resList.size()];
for (int i = 0; i < resList.size(); i++) {
res[i] = resList.get(i);
}
return res;
}

public void findMode1(TreeNode root) {
if (root == null) {
return;
}
//左
findMode1(root.left);

//中
int rootValue = root.val;
// 计数
if (pre == null || rootValue != pre.val) {
count = 1;
} else {
count++;
}
// 更新结果以及maxCount
if (count > maxCount) {
resList.clear();
resList.add(rootValue);
maxCount = count;
} else if (count == maxCount) {
resList.add(rootValue);
}
pre = root;

//右
findMode1(root.right);
}
}

31、二叉树的最近公共祖先

236. 二叉树的最近公共祖先 - 力扣(LeetCode)

给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。

百度百科中最近公共祖先的定义为:“对于有根树 T 的两个节点 p、q,最近公共祖先表示为一个节点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”

示例 1:

img

1
2
3
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1
输出:3
解释:节点 5 和节点 1 的最近公共祖先是节点 3 。

示例 2:

img

1
2
3
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4
输出:5
解释:节点 5 和节点 4 的最近公共祖先是节点 5 。因为根据定义最近公共祖先节点可以为节点本身。

示例 3:

1
2
输入:root = [1,2], p = 1, q = 2
输出:1

提示:

  • 树中节点数目在范围 [2, 105] 内。
  • -109 <= Node.val <= 109
  • 所有 Node.val 互不相同 。
  • p != q
  • p 和 q 均存在于给定的二叉树中。

思路

遇到这个题目首先想的事要是能自底向上查找就好了,这样就可以找到公共祖先了,那么二叉树如何可以自底向上查找呢?

回溯,二叉树回溯的过程就是自底向上。

后序遍历(左右中)就是天然的回溯过程,可以根据左右子树的返回值,来处理中节点的逻辑。因为从上往下看能看到自己多深,所以是前序遍历,从下往上看才能看到自己多高,所以是后序遍历,所以自底向上是后序遍历

接下来就看如何判断一个节点是节点q和节点p的公共祖先呢?

最容易想到的一个情况:如果找到一个节点,发现左子树出现节点p,右子树出现节点q,或者左子树出现节点q,右子树出现p,那么该节点就是节点p和q的最近公共祖先。

这里是出现哦!!!有刚好在左叶子节点,有的在左子树,都符合的,由于是自底向上的,所以可以保证是最近的公共祖先。

这个是情况一:

img

判断逻辑是如果递归遍历遇到q,就将q返回,遇到p就将p返回,那么如果左右子树的返回值都不为空,说明此时的中节点,一定是q和p的最近祖先。

但是很多人忽略的一个情况就是节点本身p(q),他自己拥有一个子孙节点情况二:

img

其实情况一和情况二代码实现过程都是一样的,也可以说,实现情况一的逻辑,顺便包含了情况二。

因为遇到q或者p返回,这样也包含了q或者p本身就是公共祖先的情况。

递归三部曲

1、确定递归函数返回值以及参数

需要递归函数返回值,来告诉我们是否找到节点q或者p,那么返回值为boolean类型就好了。

但我们还是要返回最近公共节点,可以利用上题目中的返回值是TreeNode,那么如果遇到了p或者q,就吧把p和q返回,返回值不为空,就说明找到了p或者q。

1
TreeNode lowestCommonAncestor(TreeNode root,TreeNode p ,TreeNode q)

2、确定终止条件

遇到空的话,返回空

那么如果root == p 或者root == q,说明找到p q,就将其返回,这个返回值,后米娜在中节点的处理过程中会用到

1
if(root == q || root == p || root == null) return root

3、确定单层递归逻辑

值得注意的是本体函数有返回值,是因为回溯的过程需要递归函数的返回值做判断,但本体我们依然要遍历树的所有节点。

小结一下:递归函数没有返回值肯定是遍历整棵树,有返回值可能是找一条边找到了就立刻返回,也有可能是遍历整棵树,找到了然后还需要后续处理。

所以如果递归函数有返回值,如何区分要搜索一条边还是搜索整个树?

搜索一条边的写法

1
2
if(递归函数(root.left)) return;
if(递归函数(root.right)) return;

搜索整个树的写法

1
2
3
left = 递归函数(root.left);
right = 递归函数(root.right);
left与right的逻辑处理

在递归函数有返回值的情况下,

如果要搜索一条边,递归函数返回值不为空的时候,立即返回。

如果搜索整个树,直接用一个变量left、right接住这个返回值,这个left、right后续还要逻辑处理的需要,也就是后续遍历中处理中间节点的逻辑(也就是回溯)

那么为什么要遍历整棵树呢?直观上来看,找到最近公共祖先,直接一路返回就可以了。

如图:

236.二叉树的最近公共祖先

就像图中一样直接返回7。

但事实上还要遍历根节点右子树(即使此时已经找到了目标节点了),也就是图中的节点4、15、20。

因为在如下代码的后序遍历中,如果想利用left和right做逻辑处理, 不能立刻返回,而是要等left与right逻辑处理完之后才能返回。

所以我们的代码如下

1
2
TreeNode left = lowestCommonAncestor(root.left,p,q);
TreeNode right = lowestCommonAncestor(root.right,p,q);

如果left和right都不为空,说明此时root就是最近公共节点。这个比较好理解

如果left为空,right不为空,就返回right,说明目标节点在右子树通过right返回,反之依然

这里有的同学就理解不了了,为什么left为空,right不为空,目标节点通过right返回呢?

如图:

236.二叉树的最近公共祖先1

图中节点10的左子树返回null,右子树返回目标值7,那么此时节点10的处理逻辑就是把右子树的返回值(最近公共祖先7)返回上去!

这里也很重要,可能刷过这道题目的同学,都不清楚结果究竟是如何从底层一层一层传到头结点的。

那么如果left和right都为空,则返回left或者right都是可以的,也就是返回空。

代码如下:

1
2
3
4
5
if(left == null && right != null) return right;
else if(left != null &&right == null) return left;
else{//左右都为空
return null;
}

那么寻找最小公共祖先,完整流程图如下:

236.二叉树的最近公共祖先2

从图中,大家可以看到,我们是如何回溯遍历整棵二叉树,将结果返回给头结点的!

整体代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
if (root == null || root == p || root == q) { // 递归结束条件
return root;
}

// 后序遍历
TreeNode left = lowestCommonAncestor(root.left, p, q);
TreeNode right = lowestCommonAncestor(root.right, p, q);

if(left == null && right == null) { // 若未找到节点 p 或 q
return null;
}else if(left == null && right != null) { // 若找到一个节点
return right;
}else if(left != null && right == null) { // 若找到一个节点
return left;
}else { // 若找到两个节点
return root;
}
}
}

32、二叉搜索树的最近公共祖先

235. 二叉搜索树的最近公共祖先 - 力扣(LeetCode)

给定一个二叉搜索树, 找到该树中两个指定节点的最近公共祖先。

百度百科中最近公共祖先的定义为:“对于有根树 T 的两个结点 p、q,最近公共祖先表示为一个结点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”

例如,给定如下二叉搜索树: root = [6,2,8,0,4,7,9,null,null,3,5]
img

示例 1:

1
2
3
输入: root = [6,2,8,0,4,7,9,null,null,3,5], p = 2, q = 8
输出: 6
解释: 节点 2 和节点 8 的最近公共祖先是 6。

示例 2:

1
2
3
输入: root = [6,2,8,0,4,7,9,null,null,3,5], p = 2, q = 4
输出: 2
解释: 节点 2 和节点 4 的最近公共祖先是 2, 因为根据定义最近公共祖先节点可以为节点本身。

思路

那么本题是二叉搜索树,二叉搜索树是有序的,那得好好利用一下这个特点。

在有序树里,如果判断一个节点的左子树里有p,右子树里有q呢?

因为是有序树,所以 如果 中间节点是 q 和 p 的公共祖先,那么 中节点的数组 一定是在 [p, q]区间的。即 中节点 > p && 中节点 < q 或者 中节点 > q && 中节点 < p。

那么只要从上到下去遍历,遇到 cur节点是数值在[p, q]区间中则一定可以说明该节点cur就是p 和 q的公共祖先。 那问题来了,一定是最近公共祖先吗?

如图,我们从根节点搜索,第一次遇到 cur节点是数值在[q, p]区间中,即 节点5,此时可以说明 q 和 p 一定分别存在于 节点 5的左子树,和右子树中。

235.二叉搜索树的最近公共祖先

此时节点5是不是最近公共祖先? 如果 从节点5继续向左遍历,那么将错过成为p的祖先, 如果从节点5继续向右遍历则错过成为q的祖先。

所以当我们从上向下去递归遍历,第一次遇到 cur节点是数值在[q, p]区间中,那么cur就是 q和p的最近公共祖先。

理解这一点,本题就很好解了。

而递归遍历顺序,本题就不涉及到 前中后序了(这里没有中节点的处理逻辑,遍历顺序无所谓了)。

如图所示:p为节点6,q为节点9

235.二叉搜索树的最近公共祖先2

可以看出直接按照指定的方向,就可以找到节点8,为最近公共祖先,而且不需要遍历整棵树,找到结果直接返回!

所以在写递归的时候再思考一下,这是找到结果直接返回,那么这个肯定是需要返回值的。

递归三部曲

1、确定参数和返回值

1
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q)

2、确定终止条件

1
if(root == null) return null

3、确定单层逻辑

1
2
3
4
5
6
7
8
9
if(root.val > p.val && root.val < q.val || root.val > q.val && root.val < p.val){
return root;//这里就是找到了
}
if(root.val > p.val && root.val > q.val){
return lowestCommonAncestor(root.right,p,q);
}
if(root.val < p.val && root.val < q.val){
return lowestCommonAncestor(root.left,p,q);
}

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Solution {
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
if (root == null)
return null;

if (root.val > p.val && root.val > q.val) {
return lowestCommonAncestor(root.left, p, q);
}
else if (root.val < p.val && root.val < q.val) {
return lowestCommonAncestor(root.right, p, q);
}else{
return root;
}

}
}

迭代法如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Solution {
public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
while (true) {
if (root.val > p.val && root.val > q.val) {
root = root.left;
} else if (root.val < p.val && root.val < q.val) {
root = root.right;
} else {
break;
}
}
return root;
}
}

33、二叉搜索树中的插入操作

701. 二叉搜索树中的插入操作 - 力扣(LeetCode)

给定二叉搜索树(BST)的根节点 root 和要插入树中的值 value ,将值插入二叉搜索树。 返回插入后二叉搜索树的根节点。 输入数据 保证 ,新值和原始二叉搜索树中的任意节点值都不同。

注意,可能存在多种有效的插入方式,只要树在插入后仍保持为二叉搜索树即可。 你可以返回 任意有效的结果 。

示例 1:
img

1
2
3
输入:root = [4,2,7,1,3], val = 5
输出:[4,2,7,1,3,5]
解释:另一个满足题目要求可以通过的树是:

示例 2:

1
2
输入:root = [40,20,60,10,30,50,70], val = 25
输出:[40,20,60,10,30,50,70,null,null,25]

示例 3:

1
2
输入:root = [4,2,7,1,3,null,null,null,null,null,null], val = 5
输出:[4,2,7,1,3,5]

提示:

  • 树中的节点数将在 [0, 104]的范围内。
  • -108 <= Node.val <= 108
  • 所有值 Node.val 是 独一无二 的。
  • -108 <= val <= 108
  • 保证 val 在原始BST中不存在。

这道题目其实是一道简单题目,但是题目中的提示:有多种有效的插入方式,还可以重构二叉搜索树,一下子吓退了不少人,瞬间感觉题目复杂了很多。

其实可以不考虑题目中提示所说的改变树的结构的插入方式。

如下演示视频中可以看出:只要按照二叉搜索树的规则去遍历,遇到空节点就插入节点就可以了。

例如插入元素10 ,需要找到末尾节点插入便可,一样的道理来插入元素15,插入元素0,插入元素6,需要调整二叉树的结构么? 并不需要。

只要遍历二叉搜索树,找到空节点 插入元素就可以了,那么这道题其实就简单了。

接下来就是遍历二叉搜索树的过程了。

递归三部曲

1、确定参数和返回值

利用题目的函数即可

1
public TreeNode insertIntoBST(TreeNode root, int val) 

2、确定结束条件

1
2
3
4
if(root == null){
TreeNode node = new TreeNode(val);
return node;
}

3、确定单层递归的逻辑

此时要明确,需要遍历整棵树么?

别忘了这是搜索树,遍历整棵搜索树简直是对搜索树的侮辱。

搜索树是有方向了,可以根据插入元素的数值,决定递归方向。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode insertIntoBST(TreeNode root, int val) {
if(root == null){
root = new TreeNode(val);
return root;
}

if(val > root.val){
root.right = insertIntoBST(root.right,val);

}
if(val < root.val){
root.left = insertIntoBST(root.left,val);
}
return root;
}
}

到这里,大家应该能感受到,如何通过递归函数返回值完成了新加入节点的父子关系赋值操作了,下一层将加入节点返回,本层用root->left或者root->right将其接住。

迭代法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public TreeNode insertIntoBST(TreeNode root, int val) {
if (root == null) return new TreeNode(val);
TreeNode newRoot = root;
TreeNode pre = root;
while (root != null) {
pre = root;
if (root.val > val) {
root = root.left;
} else if (root.val < val) {
root = root.right;
}
}
if (pre.val > val) {
pre.left = new TreeNode(val);
} else {
pre.right = new TreeNode(val);
}

return newRoot;
}
}

34、删除二叉搜索树中的节点

450. 删除二叉搜索树中的节点 - 力扣(LeetCode)

给定一个二叉搜索树的根节点 root 和一个值 key,删除二叉搜索树中的 key 对应的节点,并保证二叉搜索树的性质不变。返回二叉搜索树(有可能被更新)的根节点的引用。

一般来说,删除节点可分为两个步骤:

  1. 首先找到需要删除的节点;
  2. 如果找到了,删除它。

示例 1:

img

1
2
3
4
5
输入:root = [5,3,6,2,4,null,7], key = 3
输出:[5,4,6,2,null,null,7]
解释:给定需要删除的节点值是 3,所以我们首先找到 3 这个节点,然后删除它。
一个正确的答案是 [5,4,6,2,null,null,7], 如下图所示。
另一个正确答案是 [5,2,6,null,4,null,7]。

示例 2:

1
2
3
输入: root = [5,3,6,2,4,null,7], key = 0
输出: [5,3,6,2,4,null,7]
解释: 二叉树不包含值为 0 的节点

示例 3:

1
2
输入: root = [], key = 0
输出: []

提示:

  • 节点数的范围 [0, 104].
  • -105 <= Node.val <= 105
  • 节点值唯一
  • root 是合法的二叉搜索树
  • -105 <= key <= 105

进阶: 要求算法时间复杂度为 O(h),h 为树的高度。

思路

搜索树的节点删除要比节点增加复杂的多,有很多情况需要考虑,做好心理准备。

递归

递归三部曲

1、确定递归函数参数及其返回值

说到递归函数的返回值,在插入操作中通过递归返回值来加入新节点,这里也可以通过递归返回值删除节点。

1
TreeNode deleteNode(TreeNode root,int key);

2、确定终止条件

遇到空返回,其实这也说明没找到删除的节点,遍历到空节点直接返回了

1
if(root == null) return root;

3、确定单层递归的逻辑

这里就是把二叉搜索树中删除节点遇到的情况都搞清楚。

有以下五种情况:

  • 第一种:没有找到删除的节点,遍历到空节点直接返回了。
  • 找到了删除的节点如何操作
    • 第二种情况:左右孩子都为空(叶子节点),直接删除节点,返回null为根节点。
    • 第三种情况:删除节点的左孩子为空,右孩子不为空,删除节点,右孩子补位,返回右孩子为根节点。
    • 第四种情况:删除节点的右孩子为空,左孩子不为空,删除节点,左孩子补位,返回左孩子为根节点
    • 第五种情况:左右孩子节点都不为空,则将删除节点的左子树头结点放到删除节点的右子树的最左面节点的左孩子上,返回删除节点右孩子为新的根节点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
if(root.val == key){
//第二种情况:左右孩子都为空(到了叶子节点),直接删除节点,返回null为根节点
if(root.left == null && root.right == null) return null;
//第三种情况:其左孩子为空,右孩子不为空,删除节点,右孩子补位,返回右孩子为根节点
if(root.left == null) return root.right;
//第四种情况,右孩子为空,左孩子不为空,删除节点,左孩子补位,删除节点,左孩子补位,返回左孩子为根节点
else if(root.right == null) return root.left;
//第五种情况:左右孩子都不为空,则将删除节点的左子树放到删除节点的右子树的最左节点的左孩子位置
//并返回删除节点右孩子为新的节点
else{
TreeNode cur = root.right;//找右子树最左面的节点
while(cur.left != null){
cur = cur.left;
}
cur.left = root.left;//把要删除的节点(root)左子树放在cur的左孩子的位置
root = root.right;//返回旧root的右孩子作为新root
return root;
}

}

这样就做完了

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public TreeNode deleteNode(TreeNode root, int key) {
if (root == null) {
return null;
}

if (root.val == key) {
//第二种情况:左右孩子都为空(到了叶子节点),直接删除节点,返回null为根节点
if (root.left == null && root.right == null)
return null;
//第三种情况:其左孩子为空,右孩子不为空,删除节点,右孩子补位,返回右孩子为根节点
if (root.left == null)
return root.right;
//第四种情况,右孩子为空,左孩子不为空,删除节点,左孩子补位,删除节点,左孩子补位,返回左孩子为根节点
else if (root.right == null)
return root.left;
//第五种情况:左右孩子都不为空,则将删除节点的左子树放到删除节点的右子树的最左节点的左孩子位置
//并返回删除节点右孩子为新的节点
else {
TreeNode cur = root.right;//找右子树最左面的节点
while (cur.left != null) {
cur = cur.left;
}
cur.left = root.left;//把要删除的节点(root)左子树放在cur的左孩子的位置
root = root.right;//返回旧root的右孩子作为新root
return root;
}

}
if (root.val > key) {
root.left = deleteNode(root.left, key);
} else {
root.right = deleteNode(root.right, key);
}
return root;
}
}
普通二叉树的删除方式

这里没有使用搜索树的特性,遍历整棵树,用交换值的操作来删除目标节点。

代码中目标节点(要删除的节点)被操作了两次。

  • 第一次是和目标节点的右子树最左面节点交换
  • 第二次直接被null覆盖了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution{
public TreeNode deleteNode(TreeNode root, int key){
root = delete(root,key);
return root;
}
public TreeNode delete(TreeNode root, int key){
if(root == null) return null;

if(root.val > key){
root.left = delete(root.left,key);
}else if (root.val < key){
root.right = delete(root.right,key);
}else{
if(root.left == null) return root.right;
if(root.right == null) return root.left;
TreeNode tmp = root.right;
while(tmp.left != null){
tmp = tmp.left;
}
root.val = tmp.val; // 把后继的值复制给当前节点
root.right = delete(root.right, tmp.val); // 再去右子树删除那个后继节点
}
return root;
}
}
递归法

删除节点的迭代法还是复杂一些的,但其本质我在递归法里都介绍了,最关键就是删除节点的操作(动画模拟的过程)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
class Solution {
public TreeNode deleteNode(TreeNode root, int key) {
if (root == null){
return null;
}
//寻找对应的对应的前面的节点,以及他的前一个节点
TreeNode cur = root;
TreeNode pre = null;
while (cur != null){
if (cur.val < key){
pre = cur;
cur = cur.right;
} else if (cur.val > key) {
pre = cur;
cur = cur.left;
}else {
break;
}
}
if (pre == null){
return deleteOneNode(cur);
}
if (pre.left !=null && pre.left.val == key){
pre.left = deleteOneNode(cur);
}
if (pre.right !=null && pre.right.val == key){
pre.right = deleteOneNode(cur);
}
return root;
}

public TreeNode deleteOneNode(TreeNode node){
if (node == null){
return null;
}
if (node.right == null){
return node.left;
}
TreeNode cur = node.right;
while (cur.left !=null){
cur = cur.left;
}
cur.left = node.left;
return node.right;
}
}

35、修剪二叉树

669. 修剪二叉搜索树 - 力扣(LeetCode)

给你二叉搜索树的根节点 root ,同时给定最小边界low 和最大边界 high。通过修剪二叉搜索树,使得所有节点的值在[low, high]中。修剪树 不应该 改变保留在树中的元素的相对结构 (即,如果没有被移除,原有的父代子代关系都应当保留)。 可以证明,存在 唯一的答案 。

所以结果应当返回修剪好的二叉搜索树的新的根节点。注意,根节点可能会根据给定的边界发生改变。

示例 1:

img

1
2
输入:root = [1,0,2], low = 1, high = 2
输出:[1,null,2]

示例 2:

img

1
2
输入:root = [3,0,4,null,2,null,null,1], low = 1, high = 3
输出:[3,2,null,1]

提示:

  • 树中节点数在范围 [1, 104] 内
  • 0 <= Node.val <= 104
  • 树中每个节点的值都是 唯一 的
  • 题目数据保证输入是一棵有效的二叉搜索树
  • 0 <= low <= high <= 104

思路

这道题不简单!!!

递归法

直接想法就是:递归处理,然后遇到

1
root.val < low || root.val > hight

的时候直接return null,一波修改,干净利落。

但是这样就会有一个严重的问题,即使当前节点不在范围内,它的子树仍然可能有合法节点!而你直接返回null,相当于 整棵子树都被丢弃了 这是错误的。

所以上面这个想法是不可行的

但是也不需要重构那么复杂。

在例子中我们发现节点0并不符合区间要求,那么将节点0和右孩子 节点2直接赋给节点3的左孩子就可以了(就是把节点0从二叉树中移出)如图:

669.修剪二叉搜索树1

理解了最关键部分,我们再递归三部曲

1、确定递归函数的参数和返回值

这里我们为什么需要返回值呢?

因为要遍历整棵树,做修改,那么遍历整棵树有返回值,没有返回值都可以。

但是有返回值,更方便,可以通过递归函数的返回值来移除节点。

1
TreeNode trimBST(TreeNode root,int lov,int high)

2、确定终止条件

修剪的操作并不是在终止条件进行的,所以就是遇到空节点返回就可以了。

1
if(root == null) return null;

3、确定单层递归的逻辑

如果root(当前节点)的元素小于low的数值,那么应该递归右子树,并返回右子树符合条件的头节点。

1
2
3
4
if(root.val < low){
TreeNode right = trimBST(root.right,low,high);
return right;
}

如果root(当前节点)的元素大于high的,那么应该递归左子树,并返回左子树符合条件的头结点。

1
2
3
4
if(root.val > high){
TreeNode left = trimBST(root.left,low,high);
return left;
}

接下来要将下一层处理完左子树的结果赋给root.left,处理完右子树的结果赋给root.right。最后返回root节点

1
2
3
root.left = trimBST(root.left,low,high);//root.left接入符合条件的左孩子
root.right = trimBST(root.right,low,high);//root.right接入符合条件的右孩子
return root;

此时大家是不是还没发现这多余的节点究竟是如何从二叉树中移除的呢?

在回顾一下上面的代码,针对下图中二叉树的情况:
669.修剪二叉搜索树1

如下代码相当于把节点0的右孩子(节点2)返回给上一层

1
2
3
4
if(root.val < low){
TreeNode right = trimBST(root.right,low,high);
return right;
}

然后如下代码相当于用节点3的左孩子 把下一层返回的 节点0的右孩子(节点2) 接住。

1
root.left = trimBST(root.left,low,high);

此时节点3的左孩子就变成了节点2,将节点0从二叉树中移除了。

只看代码,其实不太好理解节点是如何移除的,这一块大家可以自己再模拟模拟!

递归法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public TreeNode trimBST(TreeNode root, int low, int high) {
if (root == null) {
return null;
}
if (root.val < low) {
return trimBST(root.right, low, high);
}
if (root.val > high) {
return trimBST(root.left, low, high);
}
// root在[low,high]范围内
root.left = trimBST(root.left, low, high);
root.right = trimBST(root.right, low, high);
return root;
}
}
迭代法

因为二叉搜索树的有序性,不需要使用栈模拟递归的过程

在剪枝的时候,可以分为三步:

  • 将root移动到[L, R] 范围内,注意是左闭右闭区间
  • 剪枝左子树
  • 剪枝右子树
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Solution {
//iteration
public TreeNode trimBST(TreeNode root, int low, int high) {
if(root == null)
return null;
//把root移到范围内
while(root != null && (root.val < low || root.val > high)){
if(root.val < low)
root = root.right;
else
root = root.left;
}
//这里操作curr,为了方便最后返回root,不移动root
TreeNode curr = root;

//处理左子树中小于low的
while(curr != null){
while(curr.left != null && curr.left.val < low){
curr.left = curr.left.right;
}
curr = curr.left;
}
//回到根节点;
curr = root;

//处理右子树中大于high的
while(curr != null){
while(curr.right != null && curr.right.val > high){
curr.right = curr.right.left;
}
curr = curr.right;
}
return root;
}
}

36、将有序数组转换为二叉搜索树

108. 将有序数组转换为二叉搜索树 - 力扣(LeetCode)

给你一个整数数组 nums ,其中元素已经按 升序 排列,请你将其转换为一棵 平衡 二叉搜索树。

示例 1:

img

1
2
3
输入:nums = [-10,-3,0,5,9]
输出:[0,-3,9,-10,null,5]
解释:[0,-10,5,null,-3,null,9] 也将被视为正确答案:

示例 2:

img

1
2
3
输入:nums = [1,3]
输出:[3,1]
解释:[1,null,3] 和 [3,1] 都是高度平衡二叉搜索树。

提示:

  • 1 <= nums.length <= 104
  • -104 <= nums[i] <= 104
  • nums 按 严格递增 顺序排列

有序数组转 BST,不是“从中间往两边串链”,而是“每次取中点,递归建左右子树”。

题目中说要转换为一棵高度平衡二叉搜索树。为什么强调要平衡呢?

因为只要给我们一个有序数组,如果不强调平衡,都可以以线性结构来构造二叉搜索树。

例如 有序数组[-10,-3,0,5,9] 就可以构造成这样的二叉搜索树,如图。

img

上图中,是符合二叉搜索树的特性吧,如果要这么做的话,是不是本题意义就不大了,所以才强调是平衡二叉搜索树。

其实数组构造二叉树,构成平衡树是自然而然的事情,因为大家默认都是从数组中间位置取值作为节点元素,一般不会随机取。所以想构成不平衡的二叉树是自找麻烦。

在之前构造二叉树中讲过,如果根据数组构造一棵二叉树本质就是寻找分割点,分割点作为当前节点然后递归做区间和右区间。

由于是二叉搜索树,所以分割点就是数组中间位置的节点。

那么问题来了,如果数组长度为偶数,中间节点有两个,取哪一个?

取哪一个都可以,只不过构成了不同的平衡二叉树。

递归三部曲

1、确定递归函数的返回值以及参数

删除二叉树节点,增加二叉树节点,都是用递归函数的返回值来完成,这样是比较方便的。

再来看参数,首先是传入数组,然后就是左下标left和右下标right,我们在构造二叉树的时候尽量不要重新定义左右区间数组,而是用下标来操作原数组。

1
TreeNode fun(int[] nums,int left,int right)

注意这里我们定义的是左闭右闭区间,在不断的分隔过程中,我们也要坚持左闭右闭区间,这涉及到我们讲过的循环不变量

2、确定递归终止条件

这里定义左闭右闭区间,所以当区间left > right的时候,就是空节点了。

1
if(left > right) return null;

3、确定单层递归逻辑

首先取中间元素的位置,不难写出

1
int mid = (left + right ) / 2

这样容易数组越界

所以我们

1
int mid = left + ((right - left) / 2);

这么写。

取了这个中间位置所以构造中间位置的元素构造节点

1
TreeNoe rott = new TreeNode(nums[mid]);

接着划分区间,root的左孩子接住下一层做区间的构造节点,右孩子接住下一层有区间构造的节点

1
2
3
4
5
int mid = left + ((right - left) / 2);
TreeNode root = new TreeNode(nums[mid]);
root.left = fun(nums,left,mid - 1);
root.right = fun(nums,mid + 1,right);
return root;

37、把二叉搜索树转换为累加树

538. 把二叉搜索树转换为累加树 - 力扣(LeetCode)

给出二叉 搜索 树的根节点,该树的节点值各不相同,请你将其转换为累加树(Greater Sum Tree),使每个节点 node 的新值等于原树中大于或等于 node.val 的值之和。

提醒一下,二叉搜索树满足下列约束条件:

  • 节点的左子树仅包含键 小于 节点键的节点。
  • 节点的右子树仅包含键 大于 节点键的节点。
  • 左右子树也必须是二叉搜索树。

注意:本题和 1038: https://leetcode-cn.com/problems/binary-search-tree-to-greater-sum-tree/ 相同

示例 1:

img

1
2
输入:[4,1,6,0,2,5,7,null,null,null,3,null,null,null,8]
输出:[30,36,21,36,35,26,15,null,null,null,33,null,null,null,8]

示例 2:

1
2
输入:root = [0,null,1]
输出:[1,null,1]

示例 3:

1
2
输入:root = [1,0,2]
输出:[3,3,2]

示例 4:

1
2
输入:root = [3,2,4,1]
输出:[7,9,4,10]

提示:

  • 树中的节点数介于 0 和 104 之间。
  • 每个节点的值介于 -104 和 104 之间。
  • 树中的所有值 互不相同 。
  • 给定的树为二叉搜索树。

思路

一看到累加树,相信很多人都会疑惑,如何累加?遇到一个节点,然后再遍历其他节点累加?这么一想很麻烦

然后发现这是一颗二叉搜索树,想到了有序数组,求从后到前的累加数组,这样是不是觉得简单了

因为数组都知道怎么遍历,从后向前,挨个累加就完事了,这换成了二叉搜索树,看起来就别扭了一些是不是。

那么知道如何遍历这个二叉树,也就迎刃而解了,从树中可以看出累加的顺序是右中左,所以我们需要反中序遍历这个二叉树,然后顺序累加就可以了。

递归

遍历顺序右中左来一个反中序遍历。

本体依然需要一个pre指针记录当前遍历节点cur的前一个节点,这样才方便做累加!!!!!!!!!!!!!!

递归三部曲

1、递归函数参数以及返回值

不需要递归函数的返回值做什么操作了,要遍历整棵树

代码如下

1
2
int pre = 0;//记录前一个节点的数值
void fun(TreeNode cur);

2、确定终止条件

遇到空就停止

1
2
3
if(cur == null){
return null;
}

3、确定单层递归的逻辑

注意要右中左来遍历二叉树,中间节点的处理逻辑就是让cur的数值加上前一个节点的数值

1
2
3
4
fun(cur.right);
cur.val += pre;
pre = cur.val;
fun(cur.left);

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int pre = 0;
public TreeNode convertBST(TreeNode root) {
if(root == null){
return null;
}
fun(root);
return root;
}
public void fun(TreeNode root){
if(root == null){
return;
}
fun(root.right);
root.val += pre;
pre = root.val;
fun(root.left);
}
}

第七章 回溯算法

1、理论基础

什么是回溯法

回溯法也可以叫回溯搜索法,这是一种搜索的方式

在二叉树系列中,我们不止一次的用到了回溯

回溯是递归的副产品,只要有递归就会有回溯。

所以下面的讲解中,回溯函数也就是递归函数,指的都是一个函数。

回溯法的效率

回溯法的性能如何呢,虽然回溯法很难,很不好理解,但是回溯法并不是什么高效的算法

因为回溯的本质就是穷举,穷举所有可能,然后选出我们想要的答案,如果想让回溯法高效一些,可以加一些剪枝的操作,但也改变不了回溯法就是穷举的本质。

那么既然回溯法不高效为什么还要用呢?

因为没得选,一些问题能暴力搜索出来就不错了,撑死再剪枝一下,还没有更高效的解法。

那很么问题这么牛逼只能暴力搜索。

回溯法解决的问题

回溯法一般可以解决如下几种问题:

  • 组合问题:N个数里面按一定规则找出k个数的集合
  • 切割问题:一个字符串按一定规则有几种切割方式
  • 子集问题:一个N个数的集合里面有多少种符合条件的子集
  • 排列问题:N个数按一定规则全排列,有几种排列方式
  • 棋盘问题:N皇后,解数独等等.

相信大家看着会发现每个问题都不简单,还有人分不清什么是组合什么是排列

组合式不强调元素顺序的,排列是强调元素顺序。

例如:{1, 2} 和 {2, 1} 在组合上,就是一个集合,因为不强调顺序,而要是排列的话,{1, 2} 和 {2, 1} 就是两个集合了。

记住组合无序,排列有序,就可以了。

如何理解回溯法

回溯法解决的问题都可以抽象为树形结构,所有回溯法的问题都可以抽象为树形结构!!!!!

因为回溯法解决的都是在集合中递归查找子集,集合的大小就构成了树的宽度,递归的深度就构成了树的深度

递归就要有终止条件,所以必然是一棵高度有限的树(N叉数)

回溯法模板

之前递归中说了递归三部曲,现在讲回溯三部曲

1、回溯算法中函数的返回值一般为void

再看一下参数,因为回溯算法需要的参数不像二叉树递归的时候那么一次性确定下来,所以一般是先写逻辑,然后需要什么参数就填什么参数。

但是后面为了方便理解,就把参数确定了下来

1
void backtracking(参数)

2、回溯终止条件

既然是树形结构,那么在递归的时候,就知道遍历树形结构一定要有终止条件。

所以回溯也要有终止条件

什么时候达到终止条件,树种可以看出,一般来说搜到了叶子结点了,也就找到了满足条件的一条答案,把这个答案存放起来,并结束本层递归。

所以回溯函数的终止条件

1
2
3
4
if(终止条件){
存放结果;
return;
}

3、回溯搜索的遍历过程

在上面我们提到了,回溯法一般是在结合中递归搜索,集合的大小构成了树的宽度,递归的深度构成了树的深度。

如图:

回溯算法理论基础

注意图中,特意距离集合大小和孩子的数量是相等的!!!!!

所以回溯函数遍历过程伪代码如下

1
2
3
4
5
for(选择:本层集合中元素(树种节点孩子的数量就是集合的大小)){
处理节点;
backtracking(路径,选择列表);//递归
回溯,撤销处理结果
}

for循环就是遍历集合区间,可以理解一个节点有多少个孩子,这个for循环就执行多少次。

backtracking这里自己调用自己,实现递归。

大家可以从图中的for循环可以理解是横向遍历,backtracking(递归)是纵向遍历,这样就把这个树全遍历完了,一般来说,搜索叶子节点就是找的其中一个结果了。

分析完过程,回溯法模板框架如下

1
2
3
4
5
6
7
8
9
10
11
12
void backtracking(参数){
if(终止条件){
存放结果;
return;
}

for(选择:本层集合中元素(树种节点孩子的数量就是集合的大小)){
处理节点;
backtracking(路径,选择列表);//递归
回溯,撤销处理结果
}
}

2、组合

77. 组合 - 力扣(LeetCode)

给定两个整数 n 和 k,返回范围 [1, n] 中所有可能的 k 个数的组合。

你可以按 任何顺序 返回答案。

示例 1:

1
2
3
4
5
6
7
8
9
10
输入:n = 4, k = 2
输出:
[
[2,4],
[3,4],
[2,3],
[1,2],
[1,3],
[1,4],
]

示例 2:

1
2
输入:n = 1, k = 1
输出:[[1]]

提示:

  • 1 <= n <= 20
  • 1 <= k <= n

思路

回溯法的经典题目。

直接的解法当然是使用for循环,例如实例中k为2,很容易想到用两个for循环,这样就可以输出和案例中一样的结果,如果输入n=100,k=3那么就是三层for循环。

那么这时候发现虽然是想暴力搜索,但是用for循环嵌套连暴力都写不出来

回溯搜索法就来了,虽然回溯法也是暴力,但是至少能写出来。

那么回溯法怎么暴力搜索呢?

上面我们说了要解决 n为100,k为50的情况,暴力写法需要嵌套50层for循环,那么回溯法就用递归来解决嵌套层数的问题。

递归来做层叠嵌套(可以理解是开k层for循环),每一次的递归中嵌套一个for循环,那么递归就可以用于解决多层嵌套循环的问题了。

此时递归的层数知道了,例如N为100,k为50的情况下就是递归50层。

如果用脑洞模拟回溯搜索的过程,会非常难,所以需要抽象图形结构来进一步理解。

用树形结构来理解回溯就容易多了。

那么我把组合问题抽象为如下树形结构:

77.组合

可以看出这棵树,一开始集合是1,2,3,4,从左向右取数,取过的数,不再重复取。

第一次取1,集合变为2,3,4,因为k为2,我们只需要再取一个数就可以了,分别取2,3,4,得到集合,以此类推。

每次从集合中选取元素,可选择的返回随着选择的进行而收缩,调整可选择的范围。

图中可以发现n相当于树的宽度,k相当于树的深度.

图中每次搜索到了叶子节点,我们就找到了一个结果。

相当于只需要把达到叶子节点的结果收集起来,就可以求得n个数中k个数的组合集合。

回溯三部曲

1、递归函数的返回值以及参数

在这里要定义两个全局变量,一个用来存放符合条件单一结果,一个用来存放符合条件结果的集合。

1
2
List<List<Integer>> res;//用来存放符合条件结果的集合
List<Integer> path;//用来存放符合条件的结果

其实不定义这两个全局变量也是可以的,把这两个变量放进递归函数的参数里,但函数里参数太多影响可读性,所以定义为全局变量了。

函数里一定有两个参数,既然是集合n里面取k个数,那么n和k是两个int类型的参数。

然后还需要一个参数,为int变量startIndex,这个参数用来记录本层递归中,集合从哪里开始遍历,集合就是1到N。

为什么要有这个startIndex呢?

startIndex的作用是防止出现重复的组合。

从下图中红线部分可以看出,在集合[1,2,3,4]取1之后,下一层递归,就要在[2,3,4]中取数了,那么下一层递归如何知道从[2,3,4]中取数呢,靠的就是startIndex。

77.组合2

所以需要startIndex来记录下一层递归,搜索的起始位置。

1
2
3
List<List<Integer>> res;
List<Integer> path;
void backtracking(int n ,int k ,int startIndex);

2、确定回溯函数的终止条件

什么时候达到所谓的叶子节点呢?

path这个数组的大小如果达到k,说明我们找到了一个子集大小为k的组合了,在图中path存的就是一根节点到叶子节点的路径。

如图红色部分:

77.组合3

此时用result二维数组,把path保存起来,并终止本层递归。

所以终止的代码如下

1
2
3
4
if(path.size() == k){
res.add(new ArrayList<>(path);
return;
}

3、单层搜索的过程

回溯法的搜索过程就是一个属性结果的遍历过程,在 下图中,可以看出for循环用来横向遍历,递归的过程就是纵向遍历
77.组合1

如此我们才遍历完图中的这棵树。

for循环每次从startIndex开始遍历,然后用path保存取到的节点i。

代码如下:

1
2
3
4
5
for(int i = startIndex ; i <= n ; i++){
path.add(i);//处理节点
backtracking(n,k,i+1);//递归,控制树的纵向遍历,注意下一层搜索要从i+1开始
path.removeLast();
}

最终的整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution{
List<List<Integer>> res = new ArrayList<>();
List<Integer> path = new ArrayList<>();

public List<List<Integer>> combine(int n ,int k){
backtracking(n,k,1);
return res;
}

public void backtracking(int n , int k,int startIndex){
if(path.size() == k){
res.add(new ArrayList<>(path));
return;
}

for(int i = startIndex ; i <= n ; i++){
path.add(i);
backtracking(n,k,i+1);
path.removeLast();
}
}
}
剪枝优化

回溯法虽然是暴力搜索,但也有时候可以有点剪枝优化一下的。

在遍历过程中有如下代码

1
2
3
4
5
for(int i = startIndex ; i <= n ; i++){
path.add(i);
backtracking(n,k,i+1);
path.removeLast();
}

这个遍历的返回是可以剪枝优化的,怎么优化呢?

来举一个例子,n=4,k=4的话,那么第一层for循环的时候,从元素2开始的遍历都没有意义了,在第二层for循环,从元素3开始没有意义了,这么说有点抽象。

如图所示:

77.组合4

图中每一个节点(图中为矩形),就代表本层的一个for循环,那么每一层的for循环从第二个数开始遍历的话,都没有意义,都是无效遍历。

所以,可以剪枝的地方就在递归中每一层的for循环所选择的起始位置。

如果for循环选择的起始位置之后的元素个数 已经不足 我们需要的元素个数了,那么就没有必要搜索了。

注意代码中for循环里面选择其实的位置

1
for(int i = startIndex ; i <= n ; i++)

这里可以优化一下

1、已经选择的元素个数path.size();

2、开需要的元素的个数为 k - path.size();

3、在集合n中至多要从该起始位置 n - (k - path.size()) +1的位置开始遍历,为什么有个+1呢,因为包括起始位置,我们需要是一个左闭的集合。

这里其实可以 自己举例子尝试边界。

那么优化之后的循环是

1
for (int i = startIndex; i <= n - (k - path.size()) + 1; i++) // i为本次搜索的起始位置

那么整体优化后的代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
class Solution {
List<List<Integer>> result = new ArrayList<>();
LinkedList<Integer> path = new LinkedList<>();
public List<List<Integer>> combine(int n, int k) {
combineHelper(n, k, 1);
return result;
}

/**
* 每次从集合中选取元素,可选择的范围随着选择的进行而收缩,调整可选择的范围,就是要靠startIndex
* @param startIndex 用来记录本层递归的中,集合从哪里开始遍历(集合就是[1,...,n] )。
*/
private void combineHelper(int n, int k, int startIndex){
//终止条件
if (path.size() == k){
result.add(new ArrayList<>(path));
return;
}
for (int i = startIndex; i <= n - (k - path.size()) + 1; i++){
path.add(i);
combineHelper(n, k, i + 1);
path.removeLast();
}
}
}

3、组合总和3

216. 组合总和 III - 力扣(LeetCode)

找出所有相加之和为 n 的 k 个数的组合,且满足下列条件:

  • 只使用数字1到9
  • 每个数字 最多使用一次

返回 所有可能的有效组合的列表 。该列表不能包含相同的组合两次,组合可以以任何顺序返回。

示例 1:

1
2
3
4
5
输入: k = 3, n = 7
输出: [[1,2,4]]
解释:
1 + 2 + 4 = 7
没有其他符合的组合了。

示例 2:

1
2
3
4
5
6
7
输入: k = 3, n = 9
输出: [[1,2,6], [1,3,5], [2,3,4]]
解释:
1 + 2 + 6 = 9
1 + 3 + 5 = 9
2 + 3 + 4 = 9
没有其他符合的组合了。

示例 3:

1
2
3
4
输入: k = 4, n = 1
输出: []
解释: 不存在有效的组合。
在[1,9]范围内使用4个不同的数字,我们可以得到的最小和是1+2+3+4 = 10,因为10 > 1,没有有效的组合。

思路

本题在1~9这个集合里面找到和为n的K个数的组合。

相对于组合,无非就是多了一个限制,本题就是找到和为n的k个数的组合,而这个组合已经固定了1~9,

相当于k深度,而9(因为整个集合就是9个数)就是树的宽度

例如 k = 2,n = 4的话,就是在集合[1,2,3,4,5,6,7,8,9]中求 k(个数) = 2, n(和) = 4的组合。

选取过程如图:

216.组合总和III

图中,可以看出,只有最后取到集合(1,3)和为4 符合条件。

回溯三部曲

1、确定递归函数参数

和组合一样

1
2
List<List<Integer>> res;
List<Integer> path;

但是还需要如下参数

  • targetSum 目标和,也就是题目中的n

  • k就是k个数的集合

  • sum目前已经收集的元素的总和

  • startIndex为下一层for循环搜索的起始位置

  • ```java
    void backtracking(int targetSum,int k , int sum , int startIndex)

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14

    2、确定终止条件

    什么时候终止?

    这里已经知道了树的深度了,因为就取k个元素

    所以

    ```java
    if(path.size() == k){
    if(sum == targetSum) res.add(new ArrayList<>(path));
    return;
    }

3、单层搜索的过程

如图: 216.组合总和III

处理过程就是 path收集每次选取的元素,相当于树型结构里的边,sum来统计path里元素的总和

代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution {
public List<List<Integer>> res = new ArrayList<>();
public List<Integer> path = new ArrayList<>();

public List<List<Integer>> combinationSum3(int k, int n) {
backtracking(n,k,0,1);
return res;
}
public void backtracking(int targetSum,int k,int sum,int startIndex){
if(path.size() == k){
if(sum == targetSum){
res.add(new ArrayList<>(path));
}
return;
}

for(int i = startIndex ; i <= 9 ; i++){
sum += i;
path.add(i);
backtracking(targetSum,k,sum,i+1);
sum -= i;
path.removeLast();

}
return;


}
}

剪枝也很容易想到,如果元素总和已经大于n,直接减掉。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
LinkedList<Integer> path = new LinkedList<>();
List<List<Integer>> ans = new ArrayList<>();
public List<List<Integer>> combinationSum3(int k, int n) {
build(k, n, 1, 0);
return ans;
}

private void build(int k, int n, int startIndex, int sum) {

if (sum > n) return;

if (path.size() > k) return;

if (sum == n && path.size() == k) {
ans.add(new ArrayList<>(path));
return;
}

for(int i = startIndex; i <= 9; i++) {
path.add(i);
sum += i;
build(k, n, i + 1, sum);
sum -= i;
path.removeLast();
}
}
}

4、电话号码的字母组合

17. 电话号码的字母组合 - 力扣(LeetCode)

给定一个仅包含数字 2-9 的字符串,返回所有它能表示的字母组合。答案可以按 任意顺序 返回。

给出数字到字母的映射如下(与电话按键相同)。注意 1 不对应任何字母。

img

示例 1:

1
2
输入:digits = "23"
输出:["ad","ae","af","bd","be","bf","cd","ce","cf"]

示例 2:

1
2
输入:digits = ""
输出:[]

示例 3:

1
2
输入:digits = "2"
输出:["a","b","c"]

思路

理解本题后要解决三个问题

1、数字和字母如何映射

2、输入1或者其他奇怪按键等等异常情况

数字和字母如何映射以及处理奇怪情况

用数组,下标代表数字

1
2
//初始对应所有的数字,为了直接对应2-9,新增了两个无效的字符串""
String[] numString = {"", "", "abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"};

那么初始化好了就开始回溯法解决组合问题了

回溯三部曲

1、递归函数的参数

需要一个存放答案的数组,以及由于需要大量字符串操作所以用StringBuilder

1
2
List<String> res = new ArrayList<>();
StringBuilder tmp = new StringBuilder();

参数的话,思考一下,按的数字对应的集合总长度决定了宽度,然后数字的长度决定了深度,比如按了23,那么深度为2

17. 电话号码的字母组合

所以需要的参数有输入的digits,数字对应的字符numString,已经到哪个数字了的index

2、结束条件

结束条件就是深度达到了

1
2
3
4
if(num == digits.length()){
res.add(tmp.toString());
return;
}

3、确定单层递归逻辑

1
2
3
4
5
6
7
8
9
//str 表示当前num对应的字符串
String str = numString[digits.charAt(num) - '0'];
for (int i = 0; i < str.length(); i++) {
temp.append(str.charAt(i));
//递归,处理下一层
backTracking(digits, numString, num + 1);
//剔除末尾的继续尝试
temp.deleteCharAt(temp.length() - 1);
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
class Solution {
public List<String> res = new ArrayList<>();
StringBuilder tmp = new StringBuilder();

public List<String> letterCombinations(String digits) {
// 处理空输入
if (digits == null || digits.length() == 0) {
return res; // 返回空列表
}

// 数字到字母的映射
String[] numString = {"", "", "abc", "def", "ghi", "jkl", "mno", "pqrs", "tuv", "wxyz"};

backtracking(digits, numString, 0);
return res;
}

public void backtracking(String digits, String[] numString, int index) {
// 递归终止条件:已经处理完所有位数
if (index == digits.length()) {
res.add(tmp.toString()); // 添加当前组合
return;
}

// 获取当前数字对应的字母字符串
String str = numString[digits.charAt(index) - '0']; // 注意:char 转 int

// 遍历每个字母
for (int i = 0; i < str.length(); i++) {
tmp.append(str.charAt(i)); // 做选择
backtracking(digits, numString, index + 1); // 递归
tmp.deleteCharAt(tmp.length() - 1); // 回溯
}
}
}

5、组合总和

39. 组合总和 - 力扣(LeetCode)

给你一个 无重复元素 的整数数组 candidates 和一个目标整数 target ,找出 candidates 中可以使数字和为目标数 target 的 所有 不同组合 ,并以列表形式返回。你可以按 任意顺序 返回这些组合。

candidates 中的 同一个 数字可以 无限制重复被选取 。如果至少一个数字的被选数量不同,则两种组合是不同的。

对于给定的输入,保证和为 target 的不同组合数少于 150 个。

示例 1:

1
2
3
4
5
6
输入:candidates = [2,3,6,7], target = 7
输出:[[2,2,3],[7]]
解释:
2 和 3 可以形成一组候选,2 + 2 + 3 = 7 。注意 2 可以使用多次。
7 也是一个候选, 7 = 7 。
仅有这两种组合。

示例 2:

1
2
输入: candidates = [2,3,5], target = 8
输出: [[2,2,2,2],[2,3,3],[3,5]]

示例 3:

1
2
输入: candidates = [2], target = 1
输出: []

提示:

  • 1 <= candidates.length <= 30
  • 2 <= candidates[i] <= 40
  • candidates 的所有元素 互不相同
  • 1 <= target <= 40

思路

组合问题肯定是想到暴力,那么想到暴力就想到回溯法,那么开始分析怎么使用回溯法。

首先这个跟前面的不同,前面是找一个元素就长度变短,这里的元素是可以多次使用的,所以限制深度的只有target了。

回溯三部曲

1、确定参数

首先要有一个存放答案的List和存入答案的List

1
2
List<List<Integer>> res = new ArrayList<>();//表示结果
List<Integer> ans = new ArrayList<>();//符合答案的ans

那么要传入的参数有,一个是candidates数组,一个数目标target,还有一个sum,由于每次都可以从第一个开始就不用跟之前一样传开始位置了?并不,还是需要的,为什么呢?如果不用起始位置,会导致组合的重复什么意思比如要求target为7,那么组合里面可以取2,2,3,那么这时候2,3,2和3,2,2都是符合条件的,但是这三个都算是一个组合。

那么什么时候需要startIndex?

  • 如果是一个集合求组合,就需要startIndex

  • 如果是多个集合求组合,各个集合之间相互不影响就不用startIndex,比如电话号码。

注意上面只是求组合,如果是排列,又是另一个分析思路。

1
void backtracking(int[] candidates,int target,int sum,int startIndex)

2、结束条件

这里的结束条件是如果sum大于或者等于target就结束,如果等于target就存入ans里。

1
2
3
4
5
6
if(sum >= target){
if(sum == target){
res.add(new ArrayList<>(ans));
}
return;
}

3、确定单层递归的函数

1
2
3
4
5
6
7
for(int i = startIndex ; i < candidates.length ; i++){
sum += candidates[i];
ans.add(candidates[i]);
backtracking(candidates,target,sum,i + 1);
sum -= candidates[i];
ans.removeLast();
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

public List<List<Integer>> combinationSum(int[] candidates, int target) {
if(candidates == null){
return null;
}
int sum = 0;
int startIndex = 0;
backtracking(candidates,target,sum,startIndex);
return res;
}

public void backtracking(int[] candidates,int target,int sum,int startIndex){

if(sum >= target){
if(sum == target){
res.add(new ArrayList<>(ans));
}
return;
}

for(int i = startIndex ; i < candidates.length ; i++){
sum += candidates[i];
ans.add(candidates[i]);
backtracking(candidates,target,sum,i);
sum -= candidates[i];
ans.removeLast();
}
return;
}
}

看完代码后仔细思考一下,startIndex是怎么控制不会重复的?

看完这个图就知道了:

39.组合总和

剪枝

以及上面的版本一的代码大家可以看到,对于sum已经大于target的情况,其实是依然进入了下一层递归,只是下一层递归结束判断的时候,会判断sum > target的话就返回。

其实如果已经知道下一层的sum会大于target,就没有必要进入下一层递归了。

那么可以在for循环的搜索范围上做做文章了。

对总集合排序之后,如果下一层的sum(就是本层的 sum + candidates[i])已经大于target,就可以结束本轮for循环的遍历。

如图:

39.组合总和1

for循环剪枝代码如下:

1
for (int i = startIndex; i < candidates.size() && sum + candidates[i] <= target; i++)

整体代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
// 剪枝优化
class Solution {
public List<List<Integer>> combinationSum(int[] candidates, int target) {
List<List<Integer>> res = new ArrayList<>();
Arrays.sort(candidates); // 先进行排序
backtracking(res, new ArrayList<>(), candidates, target, 0, 0);
return res;
}

public void backtracking(List<List<Integer>> res, List<Integer> path, int[] candidates, int target, int sum, int idx) {
// 找到了数字和为 target 的组合
if (sum == target) {
res.add(new ArrayList<>(path));
return;
}

for (int i = idx; i < candidates.length; i++) {
// 如果 sum + candidates[i] > target 就终止遍历
if (sum + candidates[i] > target) break;
path.add(candidates[i]);
backtracking(res, path, candidates, target, sum + candidates[i], i);
path.remove(path.size() - 1); // 回溯,移除路径 path 最后一个元素
}
}
}

6、组合总和2

40. 组合总和 II - 力扣(LeetCode)

给定一个候选人编号的集合 candidates 和一个目标数 target ,找出 candidates 中所有可以使数字和为 target 的组合。

candidates 中的每个数字在每个组合中只能使用 一次 。

注意:解集不能包含重复的组合。

示例 1:

1
2
3
4
5
6
7
8
输入: candidates = [10,1,2,7,6,1,5], target = 8,
输出:
[
[1,1,6],
[1,2,5],
[1,7],
[2,6]
]

示例 2:

1
2
3
4
5
6
输入: candidates = [2,5,2,1,2], target = 5,
输出:
[
[1,2,2],
[5]
]

提示:

  • 1 <= candidates.length <= 100
  • 1 <= candidates[i] <= 50
  • 1 <= target <= 30

思路

这题和前面还是不同的,首先这里每个组合中的元素只能使用一次,并且元素里面是有重复的

首先是组合问题肯定用回溯法

回溯三部曲

首先candidates的长度决定了树的宽度和深度

1、确定参数

首先要有一个存放答案和最终答案的List

1
2
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

然后参数要传candidates,target,还有现在的sum,还有startIndex

1
void backtracking(int[] candidates,int target,int sum,int startIndex)

2、确定结束条件

1
2
3
4
5
6
if(sum >= target){
if(sum == target){
res.add(new ArrayList<>(sum));
}
return;
}

3、确定单层递归逻辑

1
2
3
4
5
6
7
8
for(int i = startIndex ; i < candidates.length ; i++){
sum += candidates[i];
ans.add(candidates[i]);
//难点在这里,要传的startIndex是多少呢?
backtracking(candidates,target,sum,i + 1);
sum -= candidates[i];
ans.removeLast();
}

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

public List<List<Integer>> combinationSum2(int[] candidates, int target) {
if (candidates == null) {
return null;
}
backtracking(candidates, target, 0, 0);
return res;
}

public void backtracking(int[] candidates, int target, int sum, int startIndex) {
if (sum >= target) {
if (sum == target) {
res.add(new ArrayList<>(ans));
}
return;
}

for (int i = startIndex; i < candidates.length; i++) {
sum += candidates[i];
ans.add(candidates[i]);
//难点在这里,要传的startIndex是多少呢?
backtracking(candidates, target, sum, i + 1);
sum -= candidates[i];
ans.removeLast();
}

return;
}
}

但是写完之后发现有问题,因为由于组合中元素是重复的可能造成的结果就是

假设有个组合1,2,1,然后target是3,那么就会造成1,2和2,1两种组合,但是这样是不对的,所以这题跟前面是不一样的,那么需要怎么修改呢?

所以需要排序+去重

提前将candidates排序好,然后递归的时候如果前一个数和当前数相等直接continue

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

public List<List<Integer>> combinationSum2(int[] candidates, int target) {
if (candidates == null) {
return null;
}
Arrays.sort(candidates);//提前排序好
backtracking(candidates, target, 0, 0);
return res;
}

public void backtracking(int[] candidates, int target, int sum, int startIndex) {
if (sum >= target) {
if (sum == target) {
res.add(new ArrayList<>(ans));
}
return;
}

for (int i = startIndex; i < candidates.length; i++) {
//这里为什么要i>startIndex,因为首先如果是第一个使用是可以的,比如1,1,2要组成2,那么两个1是可以允许的,其次后面的比较可以放出数组越界
if(i > startIndex && candidates[i] == candidates[i - 1]){
continue;
}
sum += candidates[i];
ans.add(candidates[i]);
//难点在这里,要传的startIndex是多少呢?
backtracking(candidates, target, sum, i + 1);
sum -= candidates[i];
ans.removeLast();
}

return;
}
}

7、分隔回文串

131. 分割回文串 - 力扣(LeetCode)

给你一个字符串 s,请你将 s 分割成一些 子串,使每个子串都是 回文串 。返回 s 所有可能的分割方案。

示例 1:

1
2
输入:s = "aab"
输出:[["a","a","b"],["aa","b"]]

示例 2:

1
2
输入:s = "a"
输出:[["a"]]

提示:

  • 1 <= s.length <= 16
  • s 仅由小写英文字母组成

思路

这里有两个关键问题

1、切割问题,有不同的切割方式

2、判断回文

首先这里肯定是回溯了,因为组合

那回溯法怎么切割字符串呢?

仔细分析一下切割其实就是组合

例如对于字符串abcdef:

  • 组合问题:选取一个a之后,在bcdef中再去选取第二个,选取b之后在cdef中再选取第三个…..。
  • 切割问题:切割一个a之后,在bcdef中再去切割第二段,切割b之后在cdef中再切割第三段…..。

感受出来了不?

所以切割问题,也可以抽象为一棵树形结构,如图:

image-20251114183614345

递归用来纵向遍历,for循环用来横向遍历,切割线(就是图中的红线)切割到字符串的结尾位置,说明找到了一个切割方法。

此时可以发现,切割问题的回溯搜索的过程和组合问题的回溯搜索的过程是差不多的。

从树形结构的图中可以看出:切割线切到了字符串最后面,说明找到了一种切割方法,此时就是本层递归的终止条件。

那么在代码里什么是切割线呢?

在处理组合问题的时候,递归参数需要传入startIndex,表示下一轮递归遍历的起始位置,这个startIndex就是切割线。

想通了之后开始回溯三部曲

1、确定回溯参数

1
2
3
List<List<String>> res = new ArrayList<>();
List<String> ans = new ArrayList<>();
void backtracking(String s,int startIndex,StringBuilder sb);

2、确定结束条件

1
2
3
4
if(startIndex >= s.size()){
res.add(new ArrayList<>(ans));
return;
}

3、确定单层递归逻辑

来看看在递归循环中如何截取子串呢?

在for (int i = startIndex; i < s.size(); i++)循环中,我们 定义了起始位置startIndex,那么 [startIndex, i] 就是要截取的子串。

首先判断这个子串是不是回文,如果是回文,就加入在ans中,ans用来记录切割过的回文子串。

首先需要一个方法来判断是否回文,这个可以用双指针。

那么最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
class Solution {
List<List<String>> res = new ArrayList<>();
List<String> ans = new ArrayList<>();

public List<List<String>> partition(String s) {
if(s == null){
return res;
}

backtracking(s,0,new StringBuilder());
return res;
}
public void backtracking(String s ,int startIndex ,StringBuilder sb){
if(s == null){
return ;
}
//确定结束条件
if(startIndex == s.length()){
res.add(new ArrayList<>(ans));
return;
}

//确定单层递归逻辑
for(int i = startIndex ; i < s.length() ; i++){
sb.append(s.charAt(i));
if(check(sb)){
ans.add(sb.toString());
backtracking(s,i+1,new StringBuilder());//这里需要重置sb,因为前面的已经分隔好了,这是分隔剩余子串
ans.removeLast();
}
}
}
public boolean check(StringBuilder sb){
for(int i = 0 ; i < sb.length() / 2 ; i++){
if(sb.charAt(i) != sb.charAt(sb.length() - 1 - i)){
return false;
}

}
return true;
}
}

看完代码再思考一下,怎么能分隔aa出来呢,这里可以看看但单层逻辑那里,有一个sb.append这里第一次是加了a然后开始回溯也就判断a是否是回文,然后第二次继续append这样就代表第一次分隔了aa出来了。后面也是一样的。

8、复原IP地址

93. 复原 IP 地址 - 力扣(LeetCode)

有效 IP 地址 正好由四个整数(每个整数位于 0 到 255 之间组成,且不能含有前导 0),整数之间用 '.' 分隔。

  • 例如:"0.1.2.201" 和"192.168.1.1" 是 有效 IP 地址,但是 "0.011.255.245"、"192.168.1.312" 和 "192.168@1.1" 是 无效 IP 地址。

给定一个只包含数字的字符串 s ,用以表示一个 IP 地址,返回所有可能的有效 IP 地址,这些地址可以通过在 s 中插入 '.' 来形成。你 不能 重新排序或删除 s 中的任何数字。你可以按 任何 顺序返回答案。

示例 1:

1
2
输入:s = "25525511135"
输出:["255.255.11.135","255.255.111.35"]

示例 2:

1
2
输入:s = "0000"
输出:["0.0.0.0"]

示例 3:

1
2
输入:s = "101023"
输出:["1.0.10.23","1.0.102.3","10.1.0.23","10.10.2.3","101.0.2.3"]

提示:

  • 1 <= s.length <= 20
  • s 仅由数字组成

思路

这题跟之前很像也是分隔问题,但是有区别的是这里的分隔是有限制的分隔,因为这是0~255的分隔,所以不能分隔成2333四长度的子串

切割问题可以抽象为树型结构,如图:

93.复原IP地址

回溯三部曲

1、递归参数

首先需要一个List存放结果,然后startIndex是肯定需要的,因为不能重复分隔,并且由于分隔数量是有限制的所以还需要传递添加逗点的数量。

1
void backtracking(String s,int startIndex, int pointNum)

2、递归的终止条件

终止条件这里很重要了,这题明确要求只会分成4段,所以用分隔的段数作为终止条件,如果pointNum为3说明分成4段了。

然后验证第四段是否合法,如果合法就加入到结果集里。

1
2
3
4
5
6
if(pointNum == 3){
if(isValid(s,startIndex,s.length() - 1)){
res.add(s);
}
return;
}

3、单层递归的逻辑

在for (int i = startIndex; i < s.size(); i++)循环中 [startIndex, i] 这个区间就是截取的子串,需要判断这个子串是否合法。

如果合法就在字符串后面加上符号.表示已经分割。

如果不合法就结束本层循环,如图中剪掉的分支:

93.复原IP地址

然后就是递归和回溯的过程:

递归调用时,下一层递归的startIndex要从i+2开始(因为需要在字符串中加入了分隔符.),同时记录分割符的数量pointNum 要 +1。

回溯的时候,就将刚刚加入的分隔符. 删掉就可以了,pointNum也要-1。

判断子串是否合法

在写一个判断位是否是有效段位了。

1、段位以0开头不合法

2、段位里有非正整数字符不合法

3、段位如果大于255不合法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
boolean isValid(StringBuilder s , int start,int end){
if(start > end){
return false;
}
if(s.charAt(start) == '0' && start != end){
return false;
}
int num = 0;
for(int i = start ; i <= end ; i++){
if(s.charAt(i) > '9' || s.charAt(i) < '0'){
return false;
}
num = num * 10 + (s.charAt[i] - '0');
if(num > 255){
return false;
}
}
return true;
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
class Solution {
List<String> res = new ArrayList<>();

public List<String> restoreIpAddresses(String s) {
if (s == null) {
return res;
}
backtracking(s, 0, 0);
return res;
}

public void backtracking(String s ,int startIndex,int pointNum ){
if(pointNum == 3){
if(isValid(s,startIndex,s.length() - 1)){
res.add(s);

}
return;
}

for(int i = startIndex ; i < s.length() - 1 ; i++){
if (isValid(s, startIndex, i)) {
s = s.substring(0, i + 1) + "." + s.substring(i + 1); //在str的后⾯插⼊⼀个逗点
pointNum++;
backtracking(s, i + 2, pointNum);// 插⼊逗点之后下⼀个⼦串的起始位置为i+2
pointNum--;// 回溯
s = s.substring(0, i + 1) + s.substring(i + 2);// 回溯删掉逗点
} else {
break;
}
}
}

public boolean isValid(String s, int start, int end) {
if (start > end) {
return false;
}
if (s.charAt(start) == '0' && start != end) {
return false;
}
int num = 0;
for (int i = start; i <= end; i++) {
if (s.charAt(i) > '9' || s.charAt(i) < '0') {
return false;
}
num = num * 10 + (s.charAt(i) - '0');
if (num > 255) {
return false;
}
}
return true;
}
}

9、子集

78. 子集 - 力扣(LeetCode)

给你一个整数数组 nums ,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。

解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。

示例 1:

1
2
输入:nums = [1,2,3]
输出:[[],[1],[2],[1,2],[3],[1,3],[2,3],[1,2,3]]

示例 2:

1
2
输入:nums = [0]
输出:[[],[0]]

提示:

  • 1 <= nums.length <= 10
  • -10 <= nums[i] <= 10
  • nums 中的所有元素 互不相同

思路

这个跟组合问题还是有区别的,如果不明白回去看看题目描述就知道了

如果把子集问题、组合问题、分割问题都抽象为一棵树的话,那么组合问题和分隔问题都是收集树的叶子结点,而子集问题是找树的所有节点。

其实自己也是一种组合问题,因为他的集合是无序的,那么既然是无序的,那么去过的元素不会重复取,写回溯的时候,for就要从startIndex开始,而不是从0开始

那什么时候从0开始,求排列问题的时候,因为1,2和2,1是不同的。

以示例中nums = [1,2,3]为例把求子集抽象为树型结构,如下:

![](https://oyy0v0pic.oss-cn-guangzhou.aliyuncs.com/image-20251115001042997.png)

从图中红线部分,可以看出遍历这个树的时候,把所有节点都记录下来,就是要求的子集集合。

回溯三部曲

1、递归函数的参数

用一个List存放最终结果,一个List存放子集组合然后需要startIndex

1
2
3
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();
void backtracking(int[] nums,int startIndex);

2、递归终止条件

从图中可以看出:

78.子集

剩余集合为空的时候,就是叶子节点。

那么什么时候剩余集合为空呢?

就是startIndex已经大于数组的长度了,就终止了,因为没有元素可取了,代码如下:

1
2
3
if (startIndex >= nums.length) {
return;
}

其实可以不需要加终止条件,因为startIndex >= nums.size(),本层for循环本来也结束了。

3、单层搜索逻辑

求取子集问题,不需要任何剪枝!因为子集就是要遍历整棵树。

那么单层递归逻辑代码如下:

1
2
3
4
5
for (int i = startIndex; i < nums.length; i++) {
ans.add(nums[i]); // 子集收集元素
backtracking(nums, i + 1); // 注意从i+1开始,元素不重复取
ans.removeLast(); // 回溯
}

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21

class Solution {
List<List<Integer>> result = new ArrayList<>();// 存放符合条件结果的集合
LinkedList<Integer> path = new LinkedList<>();// 用来存放符合条件结果
public List<List<Integer>> subsets(int[] nums) {
subsetsHelper(nums, 0);
return result;
}

private void subsetsHelper(int[] nums, int startIndex){
result.add(new ArrayList<>(path));//「遍历这个树的时候,把所有节点都记录下来,就是要求的子集集合」。
if (startIndex >= nums.length){ //终止条件可不加
return;
}
for (int i = startIndex; i < nums.length; i++){
path.add(nums[i]);
subsetsHelper(nums, i + 1);
path.removeLast();
}
}
}

10、子集2

90. 子集 II - 力扣(LeetCode)

给你一个整数数组 nums ,其中可能包含重复元素,请你返回该数组所有可能的 子集(幂集)。

解集 不能 包含重复的子集。返回的解集中,子集可以按 任意顺序 排列。

示例 1:

1
2
输入:nums = [1,2,2]
输出:[[],[1],[1,2],[1,2,2],[2],[2,2]]

示例 2:

1
2
输入:nums = [0]
输出:[[],[0]]

提示:

  • 1 <= nums.length <= 10
  • -10 <= nums[i] <= 10

思路

这题跟上题的区别就是有重复元素

之前组合问题的时候是排序+去重解决的了。

这里总结一下,“使用过”在树形结构上是有两个维度的,一个维度是同一树枝上使用过,一个维度是同一树层上使用过。

下图是组合问题的去重逻辑

40.组合总和II

那么这题的去重逻辑是

用示例中的[1, 2, 2] 来举例,如图所示: (注意去重需要先对集合排序)

90.子集II

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class Solution {

List<List<Integer>> res = new ArrayList<>();
LinkedList<Integer> path = new LinkedList<>();

public List<List<Integer>> subsetsWithDup( int[] nums ) {
Arrays.sort( nums );
subsetsWithDupHelper( nums, 0 );
return res;
}


private void subsetsWithDupHelper( int[] nums, int start ) {
res.add( new ArrayList<>( path ) );

for ( int i = start; i < nums.length; i++ ) {
// 跳过当前树层使用过的、相同的元素
if ( i > start && nums[i - 1] == nums[i] ) {
continue;
}
path.add( nums[i] );
subsetsWithDupHelper( nums, i + 1 );
path.removeLast();
}
}

}

11、递增子序列

491. 非递减子序列 - 力扣(LeetCode)

给你一个整数数组 nums ,找出并返回所有该数组中不同的递增子序列,递增子序列中 至少有两个元素 。你可以按 任意顺序 返回答案。

数组中可能含有重复元素,如出现两个整数相等,也可以视作递增序列的一种特殊情况。

示例 1:

1
2
输入:nums = [4,6,7,7]
输出:[[4,6],[4,6,7],[4,6,7,7],[4,7],[4,7,7],[6,7],[6,7,7],[7,7]]

示例 2:

1
2
输入:nums = [4,4,3,2,1]
输出:[[4,4]]

提示:

  • 1 <= nums.length <= 15
  • -100 <= nums[i] <= 100

思路

这个递增子序列比较像是取有序的子集。而且本题也要求不能有相同的递增子序列。

这又是子集,又是去重,是不是不由自主的想起了刚刚的子集2

就是因为太像了,更要注意差别所在,要不就掉坑里了!

本题求自增子序列,是不能对原数组进行排序的,排完序的数组都是自增子序列了。

所以不能使用之前的去重逻辑!

回溯三部曲

1、递归函数参数

本题求子序列,很明显一个元素不能重复使用,所以需要startIndex,调整下一层递归的起始位置

1
2
3
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();
void backtracking(int[] nums,int startIndex);

2、终止条件

本题其实类似求子集问题,也是要遍历树形结构找每一个节点,所以跟子集一样,可以不加终止条件

但是本题收集结果有所不同,题目要求递增子序列大小至少为2,所以代码如下:

1
2
3
4
if(ans.size() > 1){
res.add(new ArrayList<>(ans));
//注意这里不要return,因为要取树上的所有节点
}

3、单层搜索逻辑

491. 递增子序列1 在图中可以看出,同一父节点下的同层上使用过的元素就不能再使用了,这里可以用used数组来判断,也可以用hashset来去重,或者用map去重。

这里需要注意的是去重逻辑,怎么样去重呢?

1
2
3
4
5
6
7
8
9
10
11
12
if(path.size() >= 2)
result.add(new ArrayList<>(path));
HashSet<Integer> hs = new HashSet<>();
for(int i = startIndex; i < nums.length; i++){
//如果不是递增,或者同一层出现过
if(!path.isEmpty() && path.get(path.size() -1 ) > nums[i] || hs.contains(nums[i]))
continue;
hs.add(nums[i]);
path.add(nums[i]);
backTracking(nums, i + 1);
path.remove(path.size() - 1);
}

HashSet<Integer> hs 的作用:同一层去重

  • hs 是在 每一层递归中新建的(在 for 循环前声明)
  • 它记录了当前层已经使用过的数字
  • 如果当前数字 nums[i] 已经在 hs 中出现过,就跳过 → 避免在同一层选择相同的数字

举例

数组 [4, 6, 7, 7],当前层可选 [6,7,7]

  • i=1: 选 6,hs.add(6)
  • i=2: 选第一个 7,hs.add(7)
  • i=3: nums[3]==7,hs.contains(7)==true → 跳过第二个 7

    这样就避免了在同一层产生两个 [...,7] 的分支,防止重复子序列。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();
public List<List<Integer>> findSubsequences(int[] nums) {
if(nums == null){
return res;
}
backtracking(nums,0);
return res;
}

public void backtracking(int[] nums, int startIndex){
//结束条件这里可以不写因为for循环会自动结束
//但是由于这里要求长度所以要加入
if(ans.size() >= 2){
res.add(new ArrayList<>(ans));
//注意这里不用return,因为要遍历整棵树,之前return是因为获取叶子结点
}

HashSet<Integer> hs = new HashSet<>();//这里用来去重
for(int i = startIndex ; i < nums.length ; i++){
//如果ans的长度要大于1,然后如果ans的上一个数,比现在这个数大,或者已经在hs里面出现过了,就continue
if(!ans.isEmpty() && ans.get( ans.size() - 1) > nums[i] || hs.contains(nums[i])){
continue;
}
hs.add(nums[i]);
ans.add(nums[i]);
backtracking(nums,i + 1);
ans.remove(ans.size() - 1);
}
}
}

12、全排列

46. 全排列 - 力扣(LeetCode)

给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。

示例 1:

1
2
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]

示例 2:

1
2
输入:nums = [0,1]
输出:[[0,1],[1,0]]

示例 3:

1
2
输入:nums = [1]
输出:[[1]]

提示:

  • 1 <= nums.length <= 6
  • -10 <= nums[i] <= 10
  • nums 中的所有整数 互不相同

思路

回溯三部曲

1、确定参数,这里由于1,2和2,1是两个集合所以不需要startIndex了,但是需要used数组标记已经用过的树

1
2
3
4
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();
int[] used = new int[nums.length];
void backtracking(int[] nums,int[] used);

2、确定结束条件

1
2
3
4
if(ans.size() == nums.length){
res.add(new ArrayList<>(ans));
return;
}

3、确定单层递归逻辑

1
2
3
4
5
6
7
8
9
10
11
12
13
//首先这是全排列,也就是每次都要从第一个开始所以是0
for(int i = 0 ; i < nums.length ; i++){
if(used[i] == 1){//表示已经用过了
continue;
}
used[i] = 1;//标记用过的数
ans.add(nums[i]);
backtracking(nums,used);
ans.remove(ans.size() - 1);
used[i] = 0;


}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

public List<List<Integer>> permute(int[] nums) {
int[] used = new int[nums.length];
backtracking(nums, used);
return res;
}

public void backtracking(int[] nums, int[] used) {
if (ans.size() == nums.length) {
res.add(new ArrayList<>(ans));
return;
}

//首先这是全排列,也就是每次都要从第一个开始所以是0
for (int i = 0; i < nums.length; i++) {
if (used[i] == 1) {//表示已经用过了
continue;
}
used[i] = 1;//标记用过的数
ans.add(nums[i]);
backtracking(nums, used);
ans.remove(ans.size() - 1);
used[i] = 0;

}
}
}

13、全排列2

47. 全排列 II - 力扣(LeetCode)

给定一个可包含重复数字的序列 nums ,按任意顺序 返回所有不重复的全排列。

示例 1:

1
2
3
4
5
输入:nums = [1,1,2]
输出:
[[1,1,2],
[1,2,1],
[2,1,1]]

示例 2:

1
2
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]

提示:

  • 1 <= nums.length <= 8
  • -10 <= nums[i] <= 10

思路

这题跟之前的又有区别就是这里有重复的数字

所以需要再上一个全排列的基础上增加排序+去重

排序简单,然后思考是去重的维度

同一层去重,还是同一树枝去重,这次是同一层

那么重要的是去重逻辑,用一个used数组标注是否使用过,那么同一层的话用hashset来标注,

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
List<List<Integer>> res = new ArrayList<>();
List<Integer> ans = new ArrayList<>();

public List<List<Integer>> permuteUnique(int[] nums) {
int[] used = new int[nums.length];
backtracking(nums, used);
return res;
}

public void backtracking(int[] nums, int[] used) {
if (ans.size() == nums.length) {
res.add(new ArrayList<>(ans));
return;
}

HashSet<Integer> hs = new HashSet<>();
//首先这是全排列,也就是每次都要从第一个开始所以是0
for (int i = 0; i < nums.length; i++) {
if (used[i] == 1 || hs.contains(nums[i])) {//表示已经用过了
continue;
}
hs.add(nums[i]);
used[i] = 1;//标记用过的数
ans.add(nums[i]);
backtracking(nums, used);
ans.remove(ans.size() - 1);
used[i] = 0;

}
}
}

后面这三题太难了,看完图论再过来看比较好

14、重新安排行程

332. 重新安排行程 - 力扣(LeetCode)

给你一份航线列表 tickets ,其中 tickets[i] = [fromi, toi] 表示飞机出发和降落的机场地点。请你对该行程进行重新规划排序。

所有这些机票都属于一个从 JFK(肯尼迪国际机场)出发的先生,所以该行程必须从 JFK 开始。如果存在多种有效的行程,请你按字典排序返回最小的行程组合。

  • 例如,行程 ["JFK", "LGA"] 与 ["JFK", "LGB"] 相比就更小,排序更靠前。

假定所有机票至少存在一种合理的行程。且所有的机票 必须都用一次 且 只能用一次。

示例 1:
img

1
2
输入:tickets = [["MUC","LHR"],["JFK","MUC"],["SFO","SJC"],["LHR","SFO"]]
输出:["JFK","MUC","LHR","SFO","SJC"]

示例 2:

img

1
2
3
输入:tickets = [["JFK","SFO"],["JFK","ATL"],["SFO","ATL"],["ATL","JFK"],["ATL","SFO"]]
输出:["JFK","ATL","JFK","SFO","ATL","SFO"]
解释:另一种有效的行程是 ["JFK","SFO","ATL","JFK","ATL","SFO"] ,但是它字典排序更大更靠后。

提示:

  • 1 <= tickets.length <= 300
  • tickets[i].length == 2
  • fromi.length == 3
  • toi.length == 3
  • fromi 和 toi 由大写英文字母组成
  • fromi != toi

思路

直觉上来看 这道题和回溯法没有什么关系,更像是图论中的深度优先搜索。

实际上确实是深搜,但这是深搜中使用了回溯的例子,在查找路径的时候,如果不回溯,怎么能查到目标路径呢。

所以我倾向于说本题应该使用回溯法,那么我也用回溯法的思路来讲解本题,其实深搜一般都使用了回溯法的思路,在图论系列中我会再详细讲解深搜。

这里就是先给大家拓展一下,原来回溯法还可以这么玩!

这道题目有几个难点:

  1. 一个行程中,如果航班处理不好容易变成一个圈,成为死循环
  2. 有多种解法,字母序靠前排在前面,让很多同学望而退步,如何该记录映射关系呢 ?
  3. 使用回溯法(也可以说深搜) 的话,那么终止条件是什么呢?
  4. 搜索的过程中,如何遍历一个机场所对应的所有机场。

针对以上问题我来逐一解答!

如何理解死循环

对于死循环,我来举一个有重复机场的例子:

332.重新安排行程

为什么要举这个例子呢,就是告诉大家,出发机场和到达机场也会重复的,如果在解题的过程中没有对集合元素处理好,就会死循环。

记录映射关系

  • Map<String, Integer> 会自动按 key(机场名)字母序排序(如果是 TreeMap)
  • HashMap 不排序,TreeMap 排序

所以我们要用 TreeMap 来保证目的地按字母序排列。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
import java.util.*;

class Solution {
// targets: 出发机场 -> (到达机场 -> 航班次数)
private Map<String, TreeMap<String, Integer>> targets = new HashMap<>();

public List<String> findItinerary(List<List<String>> tickets) {
// 构建图
for (List<String> ticket : tickets) {
String from = ticket.get(0);
String to = ticket.get(1);

targets.putIfAbsent(from, new TreeMap<>()); // 自动按字母序排序
targets.get(from).merge(to, 1, Integer::sum); // 次数 +1
}

List<String> result = new ArrayList<>();
result.add("JFK"); // 起点固定为 JFK
backtrack("JFK", result, tickets.size() + 1);
return result;
}

private boolean backtrack(String airport, List<String> result, int total) {
// 如果结果长度等于总航班数 + 1,说明所有机票都用了
if (result.size() == total) {
return true;
}

// 获取当前机场的所有目的地
Map<String, Integer> destinations = targets.get(airport);
if (destinations != null) {
// TreeMap 会自动按 key(机场名)升序遍历
for (String next : destinations.keySet()) {
int count = destinations.get(next);
if (count > 0) { // 航班次数 > 0,说明还能飞
// 使用这张机票
destinations.put(next, count - 1);
result.add(next);

// 递归
if (backtrack(next, result, total)) {
return true;
}

// 回溯
result.remove(result.size() - 1);
destinations.put(next, count);
}
}
}

return false;
}
}

15、N皇后

51. N 皇后 - 力扣(LeetCode)

16、解数独

37. 解数独 - 力扣(LeetCode)

第八章 贪心算法

1、贪心算法理论基础

什么是贪心,贪心的本质就是选择的每一阶段都是局部最优,从而达到全局最优

这么说有一点抽象,举个例子:例如有一堆钞票,你可以拿走十张,如果想达到最大的金额,你要怎么拿?

指定每次拿最大的,最终的结果就是拿走最大数额的钱。

每次拿最大的就是局部最有,最后拿走最大数额的钱就是推出全局最优。

再聚一个例子,如果有一堆盒子,你有一个背包体积为n,如何把背包尽可能装满,如果每次还选最大的盒子,就不行了。这时候需要动态规划。

贪心的套路:什么时候使用贪心

这个就是靠常识性判断,或者想反例,如果想不出什么反例,可以试一试贪心。一般大部分不需要数学推导。

贪心的一般解题步骤

贪心算法一般分为4步

1、将问题分解为若干个子问题

2、找出适合的贪心策略

3、求解每一个子问题的最优解

4、将局部最优解堆叠成全局最优解

实际上做题的时候,只要想清楚局部最优是什么,如果推导出全局最有,其实就够了

所以说,贪心没有套路,常识性推导加上举反例

2、分发饼干

455. 分发饼干 - 力扣(LeetCode)

假设你是一位很棒的家长,想要给你的孩子们一些小饼干。但是,每个孩子最多只能给一块饼干。

对每个孩子 i,都有一个胃口值 g[i],这是能让孩子们满足胃口的饼干的最小尺寸;并且每块饼干 j,都有一个尺寸 s[j] 。如果 s[j] >= g[i],我们可以将这个饼干 j 分配给孩子 i ,这个孩子会得到满足。你的目标是满足尽可能多的孩子,并输出这个最大数值。

示例 1:

1
2
3
4
5
6
输入: g = [1,2,3], s = [1,1]
输出: 1
解释:
你有三个孩子和两块小饼干,3 个孩子的胃口值分别是:1,2,3。
虽然你有两块小饼干,由于他们的尺寸都是 1,你只能让胃口值是 1 的孩子满足。
所以你应该输出 1。

示例 2:

1
2
3
4
5
6
输入: g = [1,2], s = [1,2,3]
输出: 2
解释:
你有两个孩子和三块小饼干,2 个孩子的胃口值分别是 1,2。
你拥有的饼干数量和尺寸都足以让所有孩子满足。
所以你应该输出 2。

提示:

  • 1 <= g.length <= 3 * 104
  • 0 <= s.length <= 3 * 104
  • 1 <= g[i], s[j] <= 231 - 1

思路

为了满足更多的小孩,就不要造成饼干尺寸的浪费。

大尺寸的饼干既可以满足胃口大的孩子也可以满足胃口小的孩子,那么就应该优先满足胃口大的。

这里的局部最优就是大饼干喂给胃口大的,充分利用饼干尺寸喂饱一个,全局最优就是喂饱尽可能多的小孩。

可以尝试使用贪心策略,先将饼干数组和小孩数组排序。

然后从后向前遍历小孩数组,用大饼干优先满足胃口大的,并统计满足小孩数量。

如图:
img

这个例子可以看出饼干 9 只有喂给胃口为 7 的小孩,这样才是整体最优解,并想不出反例,那么就可以撸代码了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public int findContentChildren(int[] g, int[] s) {
int n = g.length;
int m = s.length;
Arrays.sort(g, 0, n);
Arrays.sort(s, 0, m);

int count = 0;
int i = 0;
int j = 0;

while (i < n && j < m) {
if (s[j] >= g[i]) {
count++;
i++;
}
j++;
}

return count;
}
}

ACM模式

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import java.io.*;
import java.util.*;

class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

// 读取孩子数量 n 和饼干数量 m
in.nextToken();
int n = (int) in.nval;
in.nextToken();
int m = (int) in.nval;

int[] g = new int[n]; // 孩子的胃口
int[] s = new int[m]; // 饼干的尺寸

// 读取胃口值
for (int i = 0; i < n; i++) {
in.nextToken();
g[i] = (int) in.nval;
}

// 读取饼干尺寸
for (int i = 0; i < m; i++) {
in.nextToken();
s[i] = (int) in.nval;
}

// 计算结果
int result = findContentChildren(g, s);

// 输出
out.println(result);
out.flush();
out.close();
}

// 贪心算法:尽可能满足更多孩子
public static int findContentChildren(int[] g, int[] s) {
Arrays.sort(g); // 胃口从小到大
Arrays.sort(s); // 饼干从小到大

int count = 0;
int childIndex = 0; // 当前尝试满足的孩子
int cookieIndex = 0; // 当前尝试使用的饼干

while (childIndex < g.length && cookieIndex < s.length) {
if (s[cookieIndex] >= g[childIndex]) {
// 当前饼干可以满足该孩子
count++;
childIndex++;
}
// 无论是否满足,都尝试下一个饼干(不满足时跳过该饼干)
cookieIndex++;
}

return count;
}
}

3、摆动序列

376. 摆动序列 - 力扣(LeetCode)

如果连续数字之间的差严格地在正数和负数之间交替,则数字序列称为 摆动序列 。第一个差(如果存在的话)可能是正数或负数。仅有一个元素或者含两个不等元素的序列也视作摆动序列。

  • 例如, [1, 7, 4, 9, 2, 5] 是一个 摆动序列 ,因为差值 (6, -3, 5, -7, 3) 是正负交替出现的。
  • 相反,[1, 4, 7, 2, 5] 和 [1, 7, 4, 5, 5] 不是摆动序列,第一个序列是因为它的前两个差值都是正数,第二个序列是因为它的最后一个差值为零。

子序列 可以通过从原始序列中删除一些(也可以不删除)元素来获得,剩下的元素保持其原始顺序。

给你一个整数数组 nums ,返回 nums 中作为 摆动序列 的 最长子序列的长度 。

示例 1:

1
2
3
输入:nums = [1,7,4,9,2,5]
输出:6
解释:整个序列均为摆动序列,各元素之间的差值为 (6, -3, 5, -7, 3) 。

示例 2:

1
2
3
4
输入:nums = [1,17,5,10,13,15,10,5,16,8]
输出:7
解释:这个序列包含几个长度为 7 摆动序列。
其中一个是 [1, 17, 10, 13, 10, 16, 8] ,各元素之间的差值为 (16, -7, 3, -3, 6, -8) 。

示例 3:

1
2
输入:nums = [1,2,3,4,5,6,7,8,9]
输出:2

提示:

  • 1 <= nums.length <= 1000
  • 0 <= nums[i] <= 1000

思路

本题要求通过从原始序列中删除一些(也可以不删除)元素来获得子序列,剩下的元素保持其原始顺序。

相信这么一说吓退不少同学,这要求最大摆动序列又可以修改数组,这得如何修改呢?

来分析一下,要求删除元素使其达到最大摆动序列,应该删除什么元素呢?

用示例二来举例,如图所示:

376.摆动序列

局部最优:删除单调坡度上的节点(不包括单调坡度两端的节点),那么这个坡度就可以有两个局部峰值。

整体最优:整个序列有最多的局部峰值,从而达到最长摆动序列。

局部最优推出全局最优,并举不出反例,那么试试贪心!

(为方便表述,以下说的峰值都是指局部峰值)

实际操作上,其实连删除的操作都不用做,因为题目要求的是最长摆动子序列的长度,所以只需要统计数组的峰值数量就可以了(相当于是删除单一坡度上的节点,然后统计长度)

这就是贪心所贪的地方,让峰值尽可能的保持峰值,然后删除单一坡度上的节点

在计算是否有峰值的时候,大家知道遍历的下标 i ,计算 prediff(nums[i] - nums[i-1]) 和 curdiff(nums[i+1] - nums[i]),如果prediff < 0 && curdiff > 0 或者 prediff > 0 && curdiff < 0 此时就有波动就需要统计。

这是我们思考本题的一个大体思路,但本题要考虑三种情况:

  1. 情况一:上下坡中有平坡
  2. 情况二:数组首尾两端
  3. 情况三:单调坡中有平坡

情况一:上下坡中有平坡

例如 [1,2,2,2,2,1]这样的数组,如图:

img

它的摇摆序列长度是多少呢? 其实是长度是 3,也就是我们在删除的时候 要不删除左面的三个 2,要不就删除右边的三个 2。

如图,可以统一规则,删除左边的三个 2:

img

在图中,当 i 指向第一个 2 的时候,prediff > 0 && curdiff = 0 ,当 i 指向最后一个 2 的时候 prediff = 0 && curdiff < 0。

如果我们采用,删左面三个 2 的规则,那么 当 prediff = 0 && curdiff < 0 也要记录一个峰值,因为他是把之前相同的元素都删掉留下的峰值。

所以我们记录峰值的条件应该是: (preDiff <= 0 && curDiff > 0) || (preDiff >= 0 && curDiff < 0),为什么这里允许 prediff == 0 ,就是为了 上面我说的这种情况。

2、情况二:数组首尾两端

所以本题统计峰值的时候,数组最左面和最右面如何统计呢?

题目中说了,如果只有两个不同的元素,那摆动序列也是 2。

例如序列[2,5],如果靠统计差值来计算峰值个数就需要考虑数组最左面和最右面的特殊情况。

因为我们在计算 prediff(nums[i] - nums[i-1]) 和 curdiff(nums[i+1] - nums[i])的时候,至少需要三个数字才能计算,而数组只有两个数字。

这里我们可以写死,就是 如果只有两个元素,且元素不同,那么结果为 2。

不写死的话,如何和我们的判断规则结合在一起呢?

可以假设,数组最前面还有一个数字,那这个数字应该是什么呢?

之前我们在 讨论 情况一:相同数字连续 的时候, prediff = 0 ,curdiff < 0 或者 >0 也记为波谷。

那么为了规则统一,针对序列[2,5],可以假设为[2,2,5],这样它就有坡度了即 preDiff = 0,如图:

376.摆动序列1

针对以上情形,result 初始为 1(默认最右面有一个峰值),此时 curDiff > 0 && preDiff <= 0,那么 result++(计算了左面的峰值),最后得到的 result 就是 2(峰值个数为 2 即摆动序列长度为 2)

经过以上分析后,我们可以写出如下代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 版本一
class Solution {
public:
int wiggleMaxLength(vector<int>& nums) {
if (nums.size() <= 1) return nums.size();
int curDiff = 0; // 当前一对差值
int preDiff = 0; // 前一对差值
int result = 1; // 记录峰值个数,序列默认序列最右边有一个峰值
for (int i = 0; i < nums.size() - 1; i++) {
curDiff = nums[i + 1] - nums[i];
// 出现峰值
if ((preDiff <= 0 && curDiff > 0) || (preDiff >= 0 && curDiff < 0)) {
result++;
}
preDiff = curDiff;
}
return result;
}
};
  • 时间复杂度:O(n)
  • 空间复杂度:O(1)

此时大家是不是发现 以上代码提交也不能通过本题?

所以此时我们要讨论情况三!

情况三:单调坡度有平坡

在版本一中,我们忽略了一种情况,即 如果在一个单调坡度上有平坡,例如[1,2,2,2,3,4],如图:

img

图中,我们可以看出,版本一的代码在三个地方记录峰值,但其实结果因为是 2,因为 单调中的平坡 不能算峰值(即摆动)。

之所以版本一会出问题,是因为我们实时更新了 prediff。

那么我们应该什么时候更新 prediff 呢?

我们只需要在 这个坡度 摆动变化的时候,更新 prediff 就行,这样 prediff 在 单调区间有平坡的时候 就不会发生变化,造成我们的误判

最终代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {
public int wiggleMaxLength(int[] nums) {
if (nums.length <= 1) {
return nums.length;
}
//当前差值
int curDiff = 0;
//上一个差值
int preDiff = 0;
int count = 1;
for (int i = 1; i < nums.length; i++) {
//得到当前差值
curDiff = nums[i] - nums[i - 1];
//如果当前差值和上一个差值为一正一负
//等于0的情况表示初始时的preDiff
if ((curDiff > 0 && preDiff <= 0) || (curDiff < 0 && preDiff >= 0)) {
count++;
preDiff = curDiff;
}
}
return count;
}
}

4、最大子序和

53. 最大子数组和 - 力扣(LeetCode)

给你一个整数数组 nums ,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。

子数组是数组中的一个连续部分。

示例 1:

1
2
3
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]
输出:6
解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。

示例 2:

1
2
输入:nums = [1]
输出:1

示例 3:

1
2
输入:nums = [5,4,-1,7,8]
输出:23

提示:

  • 1 <= nums.length <= 105
  • -104 <= nums[i] <= 104

进阶:如果你已经实现复杂度为 O(n) 的解法,尝试使用更为精妙的 分治法 求解。

思路

贪心解法

这里哪里可以贪呢

如果-2 1在一起,计算起点的时候,一定是从1开始计算,因为负数会拉低综总和。

局部最优:当前“连续和”为负数的时候立刻放弃,从下一个元素重新计算“连续和”,因为负数加上下一个元素“连续和”只会越来越小。

全局最优:选取最大“连续和”

局部最优的情况下,并记录最大的连续和,可以推出全局最优。

从代码角度上思考:遍历nums,从头开始用count累计,如果count一旦加上nums[i]变为负数,那么就应该从nums[i + 1]开始从0开始累计count了,因为已经变为了负数的count,只会拖累总和。

这相当于是暴力解法中的不断调整最大子序和区间的起始位置

那就有学问了,区间终止位置不用调整吗?如何才能找到最大连续和?

区间的终止位置,就是如果count取到最大值了,及时记录下来

1
if(count > result) result = count;

这样相当于是用result记录最大子序的区间和(变相的算是调整了终止位置)

力扣题解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public int maxSubArray(int[] nums) {
int len = nums.length;
int res = Integer.MIN_VALUE;
int count = 0;
for (int i = 0; i < len; i++) {
count += nums[i];
if (count > res) {
res = count;
}
if (count <= 0) count = 0;
}
return res;
}
}

ACM题解

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
import java.util.*;
import java.io.*;
public class Main{

public static Integer n;
public static Integer len;
public static final Integer MAX_NUM = 10001;
public static final Integer MAX_LEN = 100002;
public static int[] nums = new int[MAX_LEN];
public static int res = Integer.MIN_VALUE;
public static int count = 0;

public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){


n = (int)in.nval;


for(int i = 0 ; i < n ; i++){
in.nextToken();
len = (int)in.nval;
for(int j = 0 ; j < len ; j++){
in.nextToken();
nums[j] = (int)in.nval;
}
out.println(maxSubArray(nums));
count = 0;
res = Integer.MIN_VALUE;
}
out.flush();
out.close();
}

}
public static int maxSubArray(int[] nums) {
for (int i = 0; i < len; i++) {
count += nums[i];
if (count > res) {
res = count;
}
if (count <= 0) count = 0;
}
return res;
}
}

5、买股票的最佳时间

122. 买卖股票的最佳时机 II - 力扣(LeetCode)

给你一个整数数组 prices ,其中 prices[i] 表示某支股票第 i 天的价格。

在每一天,你可以决定是否购买和/或出售股票。你在任何时候 最多 只能持有 一股 股票。你也可以先购买,然后在 同一天 出售。

返回 你能获得的 最大 利润 。

示例 1:

1
2
3
4
5
输入:prices = [7,1,5,3,6,4]
输出:7
解释:在第 2 天(股票价格 = 1)的时候买入,在第 3 天(股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
随后,在第 4 天(股票价格 = 3)的时候买入,在第 5 天(股票价格 = 6)的时候卖出, 这笔交易所能获得利润 = 6 - 3 = 3。
最大总利润为 4 + 3 = 7 。

示例 2:

1
2
3
4
输入:prices = [1,2,3,4,5]
输出:4
解释:在第 1 天(股票价格 = 1)的时候买入,在第 5 天 (股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
最大总利润为 4 。

示例 3:

1
2
3
输入:prices = [7,6,4,3,1]
输出:0
解释:在这种情况下, 交易无法获得正利润,所以不参与交易可以获得最大利润,最大利润为 0。

提示:

  • 1 <= prices.length <= 3 * 104
  • 0 <= prices[i] <= 104
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public int maxProfit(int[] prices) {
int len = prices.length;
int res = 0;
if(prices == null){
return res;
}
for(int i = 0 ; i < len - 1 ; i++){
if(prices[i + 1] > prices[i]){
res += prices[i + 1] - prices[i];
}
}
return res;
}
}

6、跳跃游戏

55. 跳跃游戏 - 力扣(LeetCode)

给你一个非负整数数组 nums ,你最初位于数组的 第一个下标 。数组中的每个元素代表你在该位置可以跳跃的最大长度。

判断你是否能够到达最后一个下标,如果可以,返回 true ;否则,返回 false 。

示例 1:

1
2
3
输入:nums = [2,3,1,1,4]
输出:true
解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。

示例 2:

1
2
3
输入:nums = [3,2,1,0,4]
输出:false
解释:无论怎样,总会到达下标为 3 的位置。但该下标的最大跳跃长度是 0 , 所以永远不可能到达最后一个下标。

提示:

  • 1 <= nums.length <= 104
  • 0 <= nums[i] <= 105
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
class Solution {
public boolean canJump(int[] nums) {
int n = nums.length;

// 特判:只有一个元素,已经在终点
if (n == 1) {
return true;
}

for (int i = 0; i < n - 1; i++) { // 只需检查到 n-2,因为最后一个不用跳
if (nums[i] == 0) {
// 判断是否能跳过这个 0 或到达终点
if (!canJumpOver(i, nums)) {
return false;
}
}
}
return true;
}

/**
* 判断能否跳过位置为 'zeroIndex' 的 0
* 即:是否存在一个位置 j < zeroIndex,使得 nums[j] > zeroIndex - j
*/
private boolean canJumpOver(int zeroIndex, int[] nums) {
for (int i = zeroIndex - 1; i >= 0; i--) { // ⚠️ 这里必须 i >= 0
if (nums[i] > zeroIndex - i) {
return true;
}
}
return false;
}
}

7、跳跃游戏2

45. 跳跃游戏 II - 力扣(LeetCode)

给定一个长度为 n 的 0 索引整数数组 nums。初始位置为 nums[0]。

每个元素 nums[i] 表示从索引 i 向后跳转的最大长度。换句话说,如果你在 nums[i] 处,你可以跳转到任意 nums[i + j] 处:

  • 0 <= j <= nums[i]
  • i + j < n

返回到达 nums[n - 1] 的最小跳跃次数。生成的测试用例可以到达 nums[n - 1]。

示例 1:

1
2
3
4
输入: nums = [2,3,1,1,4]
输出: 2
解释: 跳到最后一个位置的最小跳跃数是 2。
从下标为 0 跳到下标为 1 的位置,跳 1 步,然后跳 3 步到达数组的最后一个位置。

示例 2:

1
2
输入: nums = [2,3,0,1,4]
输出: 2

提示:

  • 1 <= nums.length <= 104
  • 0 <= nums[i] <= 1000
  • 题目保证可以到达 nums[n-1]

思路

本题要计算最少步数,那么就要想清楚什么时候步数才一定要加一呢?

贪心的思路,局部最优:当前可移动距离尽可能多走,如果还没到终点,步数再加一。整体最优:一步尽可能多走,从而达到最少步数。

思路虽然是这样,但在写代码的时候还不能真的能跳多远就跳多远,那样就不知道下一步最远能跳到哪里了。

所以真正解题的时候,要从覆盖范围出发,不管怎么跳,覆盖范围内一定是可以跳到的,以最小的步数增加覆盖范围,覆盖范围一旦覆盖了终点,得到的就是最少步数!

这里需要统计两个覆盖范围,当前这一步的最大覆盖和下一步最大覆盖。

如果移动下标达到了当前这一步的最大覆盖最远距离了,还没有到终点的话,那么就必须再走一步来增加覆盖范围,直到覆盖范围覆盖了终点。

如图:

45.跳跃游戏II

图中覆盖范围的意义在于,只要红色的区域,最多两步一定可以到!(不用管具体怎么跳,反正一定可以跳到)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// 版本一
class Solution {
public int jump(int[] nums) {
if (nums == null || nums.length == 0 || nums.length == 1) {
return 0;
}
//记录跳跃的次数
int count=0;
//当前的覆盖最大区域
int curDistance = 0;
//最大的覆盖区域
int maxDistance = 0;
for (int i = 0; i < nums.length; i++) {
//在数组下标下最大覆盖区域
maxDistance = Math.max(maxDistance,i+nums[i]);
//说明当前一步,再跳一步就到达了末尾
if (maxDistance>=nums.length-1){
count++;
break;
}
//走到当前覆盖的最大区域时,更新下一步可达的最大区域
if (i==curDistance){
curDistance = maxDistance;
count++;
}
}
return count;
}
}

为什么“等到 i == curDistance 跳”?

因为这是贪心策略的关键:延迟决策,直到必须跳时才跳

  • 在 [0, curDistance] 这个范围内行走时,不断观察:“从这些位置出发,下一步最远能跳到哪?”
  • 不需要在 i=0 就决定跳到哪,而是走到 curDistance 边界时,才做决定
  • 这样可以收集到“当前跳跃范围内所有位置的信息”,从而做出最优决策

8、K次取反后最大化的数组和

1005. K 次取反后最大化的数组和 - 力扣(LeetCode)

给你一个整数数组 nums 和一个整数 k ,按以下方法修改该数组:

  • 选择某个下标 i 并将 nums[i] 替换为 -nums[i] 。

重复这个过程恰好 k 次。可以多次选择同一个下标 i 。

以这种方式修改数组后,返回数组 可能的最大和 。

示例 1:

1
2
3
输入:nums = [4,2,3], k = 1
输出:5
解释:选择下标 1 ,nums 变为 [4,-2,3] 。

示例 2:

1
2
3
输入:nums = [3,-1,0,2], k = 3
输出:6
解释:选择下标 (1, 2, 2) ,nums 变为 [3,1,0,2] 。

示例 3:

1
2
3
输入:nums = [2,-3,-1,5,-4], k = 2
输出:13
解释:选择下标 (1, 4) ,nums 变为 [2,3,-1,5,4] 。

提示:

  • 1 <= nums.length <= 104
  • -100 <= nums[i] <= 100
  • 1 <= k <= 104

思路

贪心的思路,局部最优,让绝对值大的负数变为正数,当前数值达到最大,整体最优:整个数组和达到最大。

局部最优可以推出全局最优。

那么如果将负数都转变为正数了,k依然大于0,此时的问题是一个有序的正整数序列,如何转变k次正负,让 数组 和达到最大

那么又是一个贪心:局部最优:只找数值最小的正整数进行反转,当前数值和可以达到最大,全局最优:整个数组和达到最大

那么本题的解题步骤为:

  • 第一步:将数组按照绝对值大小从大到小排序,注意要按照绝对值的大小
  • 第二步:从前向后遍历,遇到负数将其变为正数,同时K—
  • 第三步:如果K还大于0,那么反复转变数值最小的元素,将K用完
  • 第四步:求和
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import java.util.stream.IntStream;

class Solution {
public int largestSumAfterKNegations(int[] nums, int k) {
// 按绝对值从大到小排序
nums = IntStream.of(nums)
.boxed()
.sorted((o1, o2) -> Integer.compare(Math.abs(o2), Math.abs(o1)))
.mapToInt(Integer::intValue)
.toArray();

// 第一步:把负数变成正数(优先处理绝对值大的负数)
for (int i = 0; i < nums.length; i++) {
if (nums[i] < 0 && k > 0) {
nums[i] = -nums[i];
k--;
}
}

// 第二步:如果 k 还有剩余,看是否为奇数
if (k % 2 == 1) {
nums[nums.length - 1] = -nums[nums.length - 1]; // 对绝对值最小的数取反一次
}

// 求和
int sum = 0;
for (int num : nums) {
sum += num;
}
return sum;
}
}

9、加油站

134. 加油站 - 力扣(LeetCode)

在一条环路上有 n 个加油站,其中第 i 个加油站有汽油 gas[i] 升。

你有一辆油箱容量无限的的汽车,从第 i 个加油站开往第 i+1 个加油站需要消耗汽油 cost[i] 升。你从其中的一个加油站出发,开始时油箱为空。

给定两个整数数组 gas 和 cost ,如果你可以按顺序绕环路行驶一周,则返回出发时加油站的编号,否则返回 -1 。如果存在解,则 保证 它是 唯一 的。

示例 1:

1
2
3
4
5
6
7
8
9
10
输入: gas = [1,2,3,4,5], cost = [3,4,5,1,2]
输出: 3
解释:
从 3 号加油站(索引为 3 处)出发,可获得 4 升汽油。此时油箱有 = 0 + 4 = 4 升汽油
开往 4 号加油站,此时油箱有 4 - 1 + 5 = 8 升汽油
开往 0 号加油站,此时油箱有 8 - 2 + 1 = 7 升汽油
开往 1 号加油站,此时油箱有 7 - 3 + 2 = 6 升汽油
开往 2 号加油站,此时油箱有 6 - 4 + 3 = 5 升汽油
开往 3 号加油站,你需要消耗 5 升汽油,正好足够你返回到 3 号加油站。
因此,3 可为起始索引。

示例 2:

1
2
3
4
5
6
7
8
9
输入: gas = [2,3,4], cost = [3,4,3]
输出: -1
解释:
你不能从 0 号或 1 号加油站出发,因为没有足够的汽油可以让你行驶到下一个加油站。
我们从 2 号加油站出发,可以获得 4 升汽油。 此时油箱有 = 0 + 4 = 4 升汽油
开往 0 号加油站,此时油箱有 4 - 3 + 2 = 3 升汽油
开往 1 号加油站,此时油箱有 3 - 3 + 3 = 3 升汽油
你无法返回 2 号加油站,因为返程需要消耗 4 升汽油,但是你的油箱只有 3 升汽油。
因此,无论怎样,你都不可能绕环路行驶一周。

提示:

  • n == gas.length == cost.length
  • 1 <= n <= 105
  • 0 <= gas[i], cost[i] <= 104
  • 输入保证答案唯一。

思路

用贪心的思想,局部最优推出全局最优。

  1. 如果总加油量 < 总消耗量 → 肯定无法绕一圈 → 返回 -1
  2. 如果总加油量 ≥ 总消耗量 → 一定存在一个合法起点(题目保证唯一解)
  3. 我们可以从 0 开始尝试,记录当前剩余油量,一旦油量不够到下一站,就说明前面这一段都不能作为起点。(因为剩余油量加上当前油量都过不了,说明这前面的起点都不行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {
public int canCompleteCircuit(int[] gas, int[] cost) {
int totalSurplus = 0; // 总油量 - 总消耗
int currentSurplus = 0; // 当前路径的油量盈余
int start = 0; // 候选起点

for (int i = 0; i < gas.length; i++) {
int surplus = gas[i] - cost[i]; // 在第 i 站加油后能多出的油
totalSurplus += surplus;
currentSurplus += surplus;

if (currentSurplus < 0) {
// 从 start 出发无法到达 i+1
// 所以 start 到 i 都不能作为起点
start = i + 1; // 尝试从下一站重新开始
currentSurplus = 0; // 重置当前油量
}
}

// 如果总油量够,就一定有解,返回 start
return totalSurplus >= 0 ? start : -1;
}
}

10、分发糖果

135. 分发糖果 - 力扣(LeetCode)

n 个孩子站成一排。给你一个整数数组 ratings 表示每个孩子的评分。

你需要按照以下要求,给这些孩子分发糖果:

  • 每个孩子至少分配到 1 个糖果。
  • 相邻两个孩子中,评分更高的那个会获得更多的糖果。

请你给每个孩子分发糖果,计算并返回需要准备的 最少糖果数目 。

示例 1:

1
2
3
输入:ratings = [1,0,2]
输出:5
解释:你可以分别给第一个、第二个、第三个孩子分发 2、1、2 颗糖果。

示例 2:

1
2
3
4
输入:ratings = [1,2,2]
输出:4
解释:你可以分别给第一个、第二个、第三个孩子分发 1、2、1 颗糖果。
第三个孩子只得到 1 颗糖果,这满足题面中的两个条件。

提示:

  • n == ratings.length
  • 1 <= n <= 2 * 104
  • 0 <= ratings[i] <= 2 * 104

思路

这道题目一定是要确定一边之后,再确定另一边,例如比较每一个孩子的左边,然后再比较右边,如果两边一起考虑一定会顾此失彼。

先确定右边评分大于左边的情况(也就是从前向后遍历)

此时局部最优:只要右边评分比左边大,右边的孩子就多一个糖果,全局最优:相邻的孩子中,评分高的右孩子获得比左边孩子更多的糖果

局部最优可以推出全局最优。

也就是说一定要从后向前遍历来确定左孩子大于右孩子的情况,然后从前往后遍历来确定右孩子大于左孩子的情况。

直到这个约束之后就能解决问题了,然后之鱼先从后往前还是从前往后都可以的。

那么为什么会有这个从后往前来确定左孩子大于右孩子的约束呢?

因为我们要满足两个规则,如果右>左,那么糖果右大于左

如果左>右,那么糖果左大于右

我们要同时满足这两个约束。

那么如果右大于左,那么右边的糖果=左边糖果+1,那么我们要先知道左边糖果的值,那么左边糖果的值要先处理了才能知道左边糖果的值,所以从前往后处理,然后右>左。

最终整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {

public int candy(int[] ratings) {
int len = ratings.length;
int[] candyVec = new int[len];
candyVec[0] = 1;
for (int i = 1; i < len; i++) {
candyVec[i] = (ratings[i] > ratings[i - 1]) ? candyVec[i - 1] + 1 : 1;
}

for (int i = len - 2; i >= 0; i--) {
if (ratings[i] > ratings[i + 1]) {
candyVec[i] = Math.max(candyVec[i], candyVec[i + 1] + 1);
}
}

int ans = 0;
for (int num : candyVec) {
ans += num;
}
return ans;
}
}

11、柠檬水找零

860. 柠檬水找零 - 力扣(LeetCode)

在柠檬水摊上,每一杯柠檬水的售价为 5 美元。顾客排队购买你的产品,(按账单 bills 支付的顺序)一次购买一杯。

每位顾客只买一杯柠檬水,然后向你付 5 美元、10 美元或 20 美元。你必须给每个顾客正确找零,也就是说净交易是每位顾客向你支付 5 美元。

注意,一开始你手头没有任何零钱。

给你一个整数数组 bills ,其中 bills[i] 是第 i 位顾客付的账。如果你能给每位顾客正确找零,返回 true ,否则返回 false 。

示例 1:

1
2
3
4
5
6
7
输入:bills = [5,5,5,10,20]
输出:true
解释:
前 3 位顾客那里,我们按顺序收取 3 张 5 美元的钞票。
第 4 位顾客那里,我们收取一张 10 美元的钞票,并返还 5 美元。
第 5 位顾客那里,我们找还一张 10 美元的钞票和一张 5 美元的钞票。
由于所有客户都得到了正确的找零,所以我们输出 true。

示例 2:

1
2
3
4
5
6
7
输入:bills = [5,5,10,10,20]
输出:false
解释:
前 2 位顾客那里,我们按顺序收取 2 张 5 美元的钞票。
对于接下来的 2 位顾客,我们收取一张 10 美元的钞票,然后返还 5 美元。
对于最后一位顾客,我们无法退回 15 美元,因为我们现在只有两张 10 美元的钞票。
由于不是每位顾客都得到了正确的找零,所以答案是 false。

提示:

  • 1 <= bills.length <= 105
  • bills[i] 不是 5 就是 10 或是 20

思路

仔细一琢磨就会发现,可供我们做判断的空间非常少!

只需要维护三种金额的数量,5,10和20。

有如下三种情况:

  • 情况一:账单是5,直接收下。
  • 情况二:账单是10,消耗一个5,增加一个10
  • 情况三:账单是20,优先消耗一个10和一个5,如果不够,再消耗三个5

此时大家就发现 情况一,情况二,都是固定策略,都不用我们来做分析了,而唯一不确定的其实在情况三。

而情况三逻辑也不复杂甚至感觉纯模拟就可以了,其实情况三这里是有贪心的。

账单是20的情况,为什么要优先消耗一个10和一个5呢?

因为美元10只能给账单20找零,而美元5可以给账单10和账单20找零,美元5更万能!

所以局部最优:遇到账单20,优先消耗美元10,完成本次找零。全局最优:完成全部账单的找零。

局部最优可以推出全局最优,并找不出反例,那么就试试贪心算法!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
public boolean lemonadeChange(int[] bills) {
int five = 0;
int ten = 0;

for (int i = 0; i < bills.length; i++) {
if (bills[i] == 5) {
five++;
} else if (bills[i] == 10) {
five--;
ten++;
} else if (bills[i] == 20) {
if (ten > 0) {
ten--;
five--;
} else {
five -= 3;
}
}
if (five < 0 || ten < 0) return false;
}

return true;
}
}

12、根据身高重建队列(未解决没读懂题)

406. 根据身高重建队列 - 力扣(LeetCode)

假设有打乱顺序的一群人站成一个队列,数组 people 表示队列中一些人的属性(不一定按顺序)。每个 people[i] = [hi, ki] 表示第 i 个人的身高为 hi ,前面 正好 有 ki 个身高大于或等于 hi 的人。

请你重新构造并返回输入数组 people 所表示的队列。返回的队列应该格式化为数组 queue ,其中 queue[j] = [hj, kj] 是队列中第 j 个人的属性(queue[0] 是排在队列前面的人)。

示例 1:

1
2
3
4
5
6
7
8
9
10
输入:people = [[7,0],[4,4],[7,1],[5,0],[6,1],[5,2]]
输出:[[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]]
解释:
编号为 0 的人身高为 5 ,没有身高更高或者相同的人排在他前面。
编号为 1 的人身高为 7 ,没有身高更高或者相同的人排在他前面。
编号为 2 的人身高为 5 ,有 2 个身高更高或者相同的人排在他前面,即编号为 0 和 1 的人。
编号为 3 的人身高为 6 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。
编号为 4 的人身高为 4 ,有 4 个身高更高或者相同的人排在他前面,即编号为 0、1、2、3 的人。
编号为 5 的人身高为 7 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。
因此 [[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]] 是重新构造后的队列。

示例 2:

1
2
输入:people = [[6,0],[5,0],[4,0],[3,2],[2,2],[1,4]]
输出:[[4,0],[5,0],[2,2],[3,2],[1,4],[6,0]]

提示:

  • 1 <= people.length <= 2000
  • 0 <= hi <= 106
  • 0 <= ki < people.length
  • 题目数据确保队列可以被重建

13、用最少数量的箭引爆气球

452. 用最少数量的箭引爆气球 - 力扣(LeetCode)

有一些球形气球贴在一堵用 XY 平面表示的墙面上。墙面上的气球记录在整数数组 points ,其中points[i] = [xstart, xend] 表示水平直径在 xstart 和 xend之间的气球。你不知道气球的确切 y 坐标。

一支弓箭可以沿着 x 轴从不同点 完全垂直 地射出。在坐标 x 处射出一支箭,若有一个气球的直径的开始和结束坐标为 x``start,x``end, 且满足 xstart ≤ x ≤ x``end,则该气球会被 引爆 。可以射出的弓箭的数量 没有限制 。 弓箭一旦被射出之后,可以无限地前进。

给你一个数组 points ,返回引爆所有气球所必须射出的 最小 弓箭数 。

示例 1:

1
2
3
4
5
输入:points = [[10,16],[2,8],[1,6],[7,12]]
输出:2
解释:气球可以用2支箭来爆破:
-在x = 6处射出箭,击破气球[2,8]和[1,6]。
-在x = 11处发射箭,击破气球[10,16]和[7,12]。

示例 2:

1
2
3
输入:points = [[1,2],[3,4],[5,6],[7,8]]
输出:4
解释:每个气球需要射出一支箭,总共需要4支箭。

示例 3:

1
2
3
4
5
输入:points = [[1,2],[2,3],[3,4],[4,5]]
输出:2
解释:气球可以用2支箭来爆破:
- 在x = 2处发射箭,击破气球[1,2]和[2,3]。
- 在x = 4处射出箭,击破气球[3,4]和[4,5]。

提示:

  • 1 <= points.length <= 105
  • points[i].length == 2
  • -231 <= xstart < xend <= 231 - 1

思路

首先得理解题目意思,首先points里面记录的是气球的直径的x坐标,然后弓箭是能水平y轴射出,所以也就是说,只要两个气球直径有重合一支箭就能把重合的气球一箭射爆。

那么我们就思考这题是不是找重合坐标了。

算法确定下来了,那么如何模拟气球射爆的过程?是在数组中移除元素还是标记?

如果真实的模拟过程,应该射一个,气球数组就remove一个元素,这样最直观。

但是仔细思考一下:如果把气球排序之后,从前到后遍历气球,被蛇果的气球仅仅跳过就行了,没必要让气球数组remove气球,只要记录一下箭的数量就可以了。

为了让气球尽可能的重叠,需要对数组进行排序。

那么按照气球起始位置排序,还是按照气球终止位置排序呢?

其实都可以!只不过对应的遍历顺序不同,我就按照气球的起始位置排序了。

既然按照起始位置排序,那么就从前向后遍历气球数组,靠左尽可能让气球重复。

从前向后遍历遇到重叠的气球了怎么办?

如果气球重叠了,重叠气球中右边边界的最小值 之前的区间一定需要一个弓箭。

以题目示例: [[10,16],[2,8],[1,6],[7,12]]为例,如图:(方便起见,已经排序)

452.用最少数量的箭引爆气球

可以看出首先第一组重叠气球,一定是需要一个箭,气球3,的左边界大于了 第一组重叠气球的最小右边界,所以再需要一支箭来射气球3了。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public int findMinArrowShots(int[][] points) {
//先排序
Arrays.sort(points, (a,b) -> Integer.compare(a[0],b[0] ));
//这里排序是根据数组的左边排序

int count = 1;//这里是记录箭
for(int i = 1 ; i < points.length ; i++){
if(points[i][0] > points[i - 1][1]){
count++;//当前球的左边界大于上一个球的有边界,也就是说两个球不挨着,所以箭的数量+1
}else{
//挨着
points[i][1] = Math.min(points[i][1],points[i - 1][1]);
//更新当前球的最小右边界。

}
}
return count;
}
}

14、无重叠区间

435. 无重叠区间 - 力扣(LeetCode)

给定一个区间的集合 intervals ,其中 intervals[i] = [starti, endi] 。返回 需要移除区间的最小数量,使剩余区间互不重叠 。

注意 只在一点上接触的区间是 不重叠的。例如 [1, 2] 和 [2, 3] 是不重叠的。

示例 1:

1
2
3
输入: intervals = [[1,2],[2,3],[3,4],[1,3]]
输出: 1
解释: 移除 [1,3] 后,剩下的区间没有重叠。

示例 2:

1
2
3
输入: intervals = [ [1,2], [1,2], [1,2] ]
输出: 2
解释: 你需要移除两个 [1,2] 来使剩下的区间没有重叠。

示例 3:

1
2
3
输入: intervals = [ [1,2], [2,3] ]
输出: 0
解释: 你不需要移除任何区间,因为它们已经是无重叠的了。

提示:

  • 1 <= intervals.length <= 105
  • intervals[i].length == 2
  • -5 * 104 <= starti < endi <= 5 * 104

思路

相信很多同学看到这道题目都冥冥之中感觉要排序,但是究竟是按照右边界排序,还是按照左边界排序呢?

其实都可以。主要就是为了让区间尽可能的重叠。

我来按照右边界排序,从左向右记录非交叉区间的个数。最后用区间总数减去非交叉区间的个数就是需要移除的区间个数了。

此时问题就是要求非交叉区间的最大个数。

这里记录非交叉区间的个数还是有技巧的,如图:

img

区间,1,2,3,4,5,6都按照右边界排好序。

当确定区间 1 和 区间2 重叠后,如何确定是否与 区间3 也重贴呢?

就是取 区间1 和 区间2 右边界的最小值,因为这个最小值之前的部分一定是 区间1 和区间2 的重合部分,如果这个最小值也触达到区间3,那么说明 区间 1,2,3都是重合的。

接下来就是找大于区间1结束位置的区间,是从区间4开始。那有同学问了为什么不从区间5开始?别忘了已经是按照右边界排序的了。

区间4结束之后,再找到区间6,所以一共记录非交叉区间的个数是三个。

总共区间个数为6,减去非交叉区间的个数3。移除区间的最小数量就是3。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int eraseOverlapIntervals(int[][] intervals) {
Arrays.sort(intervals, (a,b)-> {
return Integer.compare(a[0],b[0]);
});
int count = 1;
for(int i = 1;i < intervals.length;i++){
if(intervals[i][0] < intervals[i-1][1]){//当前左边界小于上一个有边界,说明重叠
intervals[i][1] = Math.min(intervals[i - 1][1], intervals[i][1]);
continue;
}else{
//不重叠++
count++;
}
}
return intervals.length - count;//返回要删除的个数
}
}

15、划分字母区间

763. 划分字母区间 - 力扣(LeetCode)

给你一个字符串 s 。我们要把这个字符串划分为尽可能多的片段,同一字母最多出现在一个片段中。例如,字符串 "ababcc" 能够被分为 ["abab", "cc"],但类似 ["aba", "bcc"] 或 ["ab", "ab", "cc"] 的划分是非法的。

注意,划分结果需要满足:将所有划分结果按顺序连接,得到的字符串仍然是 s 。

返回一个表示每个字符串片段的长度的列表。

示例 1:

1
2
3
4
5
6
输入:s = "ababcbacadefegdehijhklij"
输出:[9,7,8]
解释:
划分结果为 "ababcbaca"、"defegde"、"hijhklij" 。
每个字母最多出现在一个片段中。
像 "ababcbacadefegde", "hijhklij" 这样的划分是错误的,因为划分的片段数较少。

示例 2:

1
2
输入:s = "eccbbbbdec"
输出:[10]

提示:

  • 1 <= s.length <= 500
  • s 仅由小写英文字母组成

思路

一想到分割字符串就想到了回溯,但本题其实不用回溯去暴力搜索。

题目要求同一字母最多出现在一个片段中,那么如何把同一个字母的都圈在同一个区间里呢?

如果没有接触过这种题目的话,还挺有难度的。

在遍历的过程中相当于是要找每一个字母的边界,如果找到之前遍历过的所有字母的最远边界,说明这个边界就是分割点了。此时前面出现过所有字母,最远也就到这个边界了。

可以分为如下两步:

  • 统计每一个字符最后出现的位置
  • 从头遍历字符,并更新字符的最远出现下标,如果找到字符最远出现位置下标和当前下标相等了,则找到了分割点

如图:

763.划分字母区间

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution {
public List<Integer> partitionLabels(String s) {
List<Integer> list = new LinkedList<>();
int[] edge = new int[26];//存最远的边界
//并且edge存放的屎每个字母的最远距离
char[] chars = s.toCharArray();
for(int i = 0 ; i < chars.length ; i++){
edge[chars[i] - 'a'] = i;
}
//上面已经列好每个字母的最远位置了

int idx = 0; // 当前子串的最远边界
int last = -1; // 上一个分割点的位置(初始为 -1)
for(int i = 0 ; i < chars.length ; i++){
idx = Math.max(idx,edge[chars[i] - 'a']);//更新最远边界,就一个子串可能有abc三个字母这样就需要找到这三个字母的最远边界
if(i == idx){
//说明已经到了最远边界了,这时候就把切割点加入到list中,然后更新上一个切割点的位置
list.add(i - last);
last = i;
}
}
return list;
}
}

16、合并区间

56. 合并区间 - 力扣(LeetCode)

以数组 intervals 表示若干个区间的集合,其中单个区间为 intervals[i] = [starti, endi] 。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。

示例 1:

1
2
3
输入:intervals = [[1,3],[2,6],[8,10],[15,18]]
输出:[[1,6],[8,10],[15,18]]
解释:区间 [1,3] 和 [2,6] 重叠, 将它们合并为 [1,6].

示例 2:

1
2
3
输入:intervals = [[1,4],[4,5]]
输出:[[1,5]]
解释:区间 [1,4] 和 [4,5] 可被视为重叠区间。

提示:

  • 1 <= intervals.length <= 104
  • intervals[i].length == 2
  • 0 <= starti <= endi <= 104

思路

这个题目跟前面的题目类似,可以先尝试一下。这里的难点是二维数组该怎么合并?

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution {
public int[][] merge(int[][] intervals) {
List<int[]> res = new LinkedList<>();
//按照左边界排序
Arrays.sort(intervals, (x, y) -> Integer.compare(x[0], y[0]));
//initial start 是最小左边界
int start = intervals[0][0];
int rightmostRightBound = intervals[0][1];
for (int i = 1; i < intervals.length; i++) {
//如果左边界大于最大右边界
if (intervals[i][0] > rightmostRightBound) {
//加入区间 并且更新start
res.add(new int[]{start, rightmostRightBound});
start = intervals[i][0];
rightmostRightBound = intervals[i][1];
} else {
//更新最大右边界
rightmostRightBound = Math.max(rightmostRightBound, intervals[i][1]);
}
}
res.add(new int[]{start, rightmostRightBound});
return res.toArray(new int[res.size()][]);
}
}

17、单调递增的数字

738. 单调递增的数字 - 力扣(LeetCode)

给定一个非负整数 N,找出小于或等于 N 的最大的整数,同时这个整数需要满足其各个位数上的数字是单调递增。

(当且仅当每个相邻位数上的数字 x 和 y 满足 x <= y 时,我们称这个整数是单调递增的。)

示例 1:

  • 输入: N = 10
  • 输出: 9

示例 2:

  • 输入: N = 1234
  • 输出: 1234

示例 3:

  • 输入: N = 332
  • 输出: 299

说明: N 是在 [0, 10^9] 范围内的一个整数。

思路

暴力方法是超时的这里就不说了,但是一看到这个题目还有例子会很容易想到后面都是9前面小一位就行了。

例如:98,一旦出现strNum[i - 1] > strNum[i]的情况()非单调递增的),首先就是想到让strNum[i - 1]–,然后后面给9就找到了89就找到了小于98的最大的单调递增整数。

那么这时候思考?我是从前向后还是从后向前遍历?

从前向后如果遇到前面大于后面的情况让前面-1,但是如果前面-1可能又小于前面的前面那个数。

那么从后向前遍历,就可以重复利用上次比较的结果了。

难点在于操作数字,把数字变成string数组再从string数组变成int

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
class Solution {
public int monotoneIncreasingDigits(int n) {
String s = String.valueOf(n);
char[] c = s.toCharArray();

int start = s.length();
for(int i = s.length() - 2 ; i >= 0 ; i--){
if(c[i] > c[i+1]){
//如果倒数第二比倒数 第一大,也就是不是递增的情况
c[i]--;//前面的数--
start = i + 1;//起始位置9的位置
}
}
for(int i = start ; i < s.length() ; i++){
c[i] = '9';//把后面的数都变为9
}
return Integer.parseInt(String.valueOf(c));
}
}

18、监控二叉树

968. 监控二叉树 - 力扣(LeetCode)

给定一个二叉树,我们在树的节点上安装摄像头。

节点上的每个摄影头都可以监视其父对象、自身及其直接子对象。

计算监控树的所有节点所需的最小摄像头数量。

示例 1:

img

1
2
3
输入:[0,0,null,0,0]
输出:1
解释:如图所示,一台摄像头足以监控所有节点。

示例 2:

img

1
2
3
输入:[0,0,null,0,null,0,null,null,0]
输出:2
解释:需要至少两个摄像头来监视树的所有节点。 上图显示了摄像头放置的有效位置之一。

提示:

  1. 给定树的节点数的范围是 [1, 1000]。
  2. 每个节点的值都是 0。

思路

首先要思考,如何放置,才能让摄像头最小的呢?

从题目中示例,其实可以得到启发,我们发现题目示例中的摄像头都没有放在叶子节点上!

这是很重要的一个线索,摄像头可以覆盖上中下三层,如果把摄像头放在叶子节点上,就浪费的一层的覆盖。

所以把摄像头放在叶子节点的父节点位置,才能充分利用摄像头的覆盖面积。

那么有同学可能问了,为什么不从头结点开始看起呢,为啥要从叶子节点看呢?

因为头结点放不放摄像头也就省下一个摄像头, 叶子节点放不放摄像头省下了的摄像头数量是指数阶别的。

所以我们要从下往上看,局部最优:让叶子节点的父节点安摄像头,所用摄像头最少,整体最优:全部摄像头数量所用最少!

局部最优推出全局最优,找不出反例,那么就按照贪心来!

此时,大体思路就是从低到上,先给叶子节点父节点放个摄像头,然后隔两个节点放一个摄像头,直至到二叉树头结点。

此时这道题目还有两个难点:

  1. 二叉树的遍历
  2. 如何隔两个节点放一个摄像头

首先遍历顺序肯定是后序遍历也就是左右中的顺序

如何隔两个节点放一个摄像头

此时需要状态转移的公式,大家不要和动态的状态转移公式混到一起,本题状态转移没有择优的过程,就是单纯的状态转移!

来看看这个状态应该如何转移,先来看看每个节点可能有几种状态:

有如下三种:

  • 该节点无覆盖
  • 本节点有摄像头
  • 本节点有覆盖

我们分别有三个数字来表示:

  • 0:该节点无覆盖
  • 1:本节点有摄像头
  • 2:本节点有覆盖

大家应该找不出第四个节点的状态了。

一些同学可能会想有没有第四种状态:本节点无摄像头,其实无摄像头就是 无覆盖 或者 有覆盖的状态,所以一共还是三个状态。

因为在遍历树的过程中,就会遇到空节点,那么问题来了,空节点究竟是哪一种状态呢? 空节点表示无覆盖? 表示有摄像头?还是有覆盖呢?

回归本质,为了让摄像头数量最少,我们要尽量让叶子节点的父节点安装摄像头,这样才能摄像头的数量最少。

那么空节点不能是无覆盖的状态,这样叶子节点就要放摄像头了,空节点也不能是有摄像头的状态,这样叶子节点的父节点就没有必要放摄像头了,而是可以把摄像头放在叶子节点的爷爷节点上。

所以空节点的状态只能是有覆盖,这样就可以在叶子节点的父节点放摄像头了

接下来就是递推关系。

那么递归的终止条件应该是遇到了空节点,此时应该返回2(有覆盖),原因上面已经解释过了。

1
2
// 空节点,该节点有覆盖
if (cur == NULL) return 2;

递归的函数,以及终止条件已经确定了,再来看单层逻辑处理。

主要有如下四类情况:

  • 情况1:左右节点都有覆盖

左孩子有覆盖,右孩子有覆盖,那么此时中间节点应该就是无覆盖的状态了。

如图:

968.监控二叉树2

代码如下:

1
2
// 左右节点都有覆盖
if (left == 2 && right == 2) return 0;
  • 情况2:左右节点至少有一个无覆盖的情况

如果是以下情况,则中间节点(父节点)应该放摄像头:

  • left == 0 && right == 0 左右节点无覆盖
  • left == 1 && right == 0 左节点有摄像头,右节点无覆盖
  • left == 0 && right == 1 左节点有无覆盖,右节点摄像头
  • left == 0 && right == 2 左节点无覆盖,右节点覆盖
  • left == 2 && right == 0 左节点覆盖,右节点无覆盖

这个不难理解,毕竟有一个孩子没有覆盖,父节点就应该放摄像头。

此时摄像头的数量要加一,并且return 1,代表中间节点放摄像头。

代码如下:

1
2
3
4
if (left == 0 || right == 0) {
result++;
return 1;
}
  • 情况3:左右节点至少有一个有摄像头

如果是以下情况,其实就是 左右孩子节点有一个有摄像头了,那么其父节点就应该是2(覆盖的状态)

  • left == 1 && right == 2 左节点有摄像头,右节点有覆盖
  • left == 2 && right == 1 左节点有覆盖,右节点有摄像头
  • left == 1 && right == 1 左右节点都有摄像头

代码如下:

1
if (left == 1 || right == 1) return 2;

从这个代码中,可以看出,如果left == 1, right == 0 怎么办?其实这种条件在情况2中已经判断过了,如图:

968.监控二叉树1

这种情况也是大多数同学容易迷惑的情况。

  1. 情况4:头结点没有覆盖

以上都处理完了,递归结束之后,可能头结点 还有一个无覆盖的情况,如图:

968.监控二叉树3

所以递归结束之后,还要判断根节点,如果没有覆盖,result++,代码如下:

1
2
3
4
5
6
7
int minCameraCover(TreeNode* root) {
result = 0;
if (traversal(root) == 0) { // root 无覆盖
result++;
}
return result;
}

以上四种情况我们分析完了,代码也差不多了,整体代码如下:

(以下我的代码注释很详细,为了把情况说清楚,特别把每种情况列出来。)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
class Solution {
int res=0;
public int minCameraCover(TreeNode root) {
// 对根节点的状态做检验,防止根节点是无覆盖状态 .
if(minCame(root)==0){
res++;
}
return res;
}
/**
节点的状态值:
0 表示无覆盖
1 表示 有摄像头
2 表示有覆盖
后序遍历,根据左右节点的情况,来判读 自己的状态
*/
public int minCame(TreeNode root){
if(root==null){
// 空节点默认为 有覆盖状态,避免在叶子节点上放摄像头
return 2;
}
int left=minCame(root.left);
int right=minCame(root.right);

// 如果左右节点都覆盖了的话, 那么本节点的状态就应该是无覆盖,没有摄像头
if(left==2&&right==2){
//(2,2)
return 0;
}else if(left==0||right==0){
// 左右节点都是无覆盖状态,那 根节点此时应该放一个摄像头
// (0,0) (0,1) (0,2) (1,0) (2,0)
// 状态值为 1 摄像头数 ++;
res++;
return 1;
}else{
// 左右节点的 状态为 (1,1) (1,2) (2,1) 也就是左右节点至少存在 1个摄像头,
// 那么本节点就是处于被覆盖状态
return 2;
}
}
}

第九章 动态规划

1、理论基础

什么是动态规划,简称DP,如果某一个问题有很多重叠子问题,那么使用动态规划是最有效的。

所以动态规划中每一个状态一定是由上一个状态推导出来的,这一点就区分于贪心,贪心没有状态推导,而是从局部直接选最优的。

在贪心算法中,举了一个背包问题的例子,例如:有N件物品和一个最多能背重量为W 的背包。第i件物品的重量是weight[i],得到的价值是value[i] 。每件物品只能用一次,求解将哪些物品装入背包里物品价值总和最大。

动态规划中dp[j]是由dp[j-weight[i]]推导出来的,然后取max(dp[j], dp[j - weight[i]] + value[i])。

但如果是贪心呢,每次拿物品选一个最大的或者最小的就完事了,和上一个状态没有关系。

所以贪心解决不了动态规划的问题。

其实大家也不用死扣动规和贪心的理论区别,后面做做题目自然就知道了。

而且很多讲解动态规划的文章都会讲最优子结构啊和重叠子问题啊这些,这些东西都是教科书的上定义,晦涩难懂而且不实用。

大家知道动规是由前一个状态推导出来的,而贪心是局部直接选最优的,对于刷题来说就够用了。

上述提到的背包问题,后序会详细讲解。

动态规划的解题步骤

做动规题目的时候,很多同学会陷入一个误区,就是以为把状态转移公式背下来,照葫芦画瓢改改,就开始写代码,甚至把题目AC之后,都不太清楚dp[i]表示的是什么。

这就是一种朦胧的状态,然后就把题给过了,遇到稍稍难一点的,可能直接就不会了,然后看题解,然后继续照葫芦画瓢陷入这种恶性循环中。

状态转移公式(递推公式)是很重要,但动规不仅仅只有递推公式。

对于动态规划问题,我将拆解为如下五步曲,这五步都搞清楚了,才能说把动态规划真的掌握了!

  1. 确定dp数组(dp table)以及下标的含义
  2. 确定递推公式
  3. dp数组如何初始化
  4. 确定遍历顺序
  5. 举例推导dp数组

一些同学可能想为什么要先确定递推公式,然后在考虑初始化呢?

因为一些情况是递推公式决定了dp数组要如何初始化!

后面的讲解中我都是围绕着这五点来进行讲解。

可能刷过动态规划题目的同学可能都知道递推公式的重要性,感觉确定了递推公式这道题目就解出来了。

其实 确定递推公式 仅仅是解题里的一步而已!

一些同学知道递推公式,但搞不清楚dp数组应该如何初始化,或者正确的遍历顺序,以至于记下来公式,但写的程序怎么改都通过不了。

后序的讲解的大家就会慢慢感受到这五步的重要性了。

动态规划应该如何debug

相信动规的题目,很大部分同学都是这样做的。

看一下题解,感觉看懂了,然后照葫芦画瓢,如果能正好画对了,万事大吉,一旦要是没通过,就怎么改都通过不了,对 dp数组的初始化,递推公式,遍历顺序,处于一种黑盒的理解状态。

写动规题目,代码出问题很正常!

找问题的最好方式就是把dp数组打印出来,看看究竟是不是按照自己思路推导的!

一些同学对于dp的学习是黑盒的状态,就是不清楚dp数组的含义,不懂为什么这么初始化,递推公式背下来了,遍历顺序靠习惯就是这么写的,然后一鼓作气写出代码,如果代码能通过万事大吉,通过不了的话就凭感觉改一改。

这是一个很不好的习惯!

做动规的题目,写代码之前一定要把状态转移在dp数组的上具体情况模拟一遍,心中有数,确定最后推出的是想要的结果。

然后再写代码,如果代码没通过就打印dp数组,看看是不是和自己预先推导的哪里不一样。

如果打印出来和自己预先模拟推导是一样的,那么就是自己的递归公式、初始化或者遍历顺序有问题了。

如果和自己预先模拟推导的不一样,那么就是代码实现细节有问题。

这样才是一个完整的思考过程,而不是一旦代码出问题,就毫无头绪的东改改西改改,最后过不了,或者说是稀里糊涂的过了。

这也是我为什么在动规五步曲里强调推导dp数组的重要性。

可以自己先思考这三个问题:

  • 这道题目我举例推导状态转移公式了么?
  • 我打印dp数组的日志了么?
  • 打印出来了dp数组和我想的一样么?

如果这灵魂三问自己都做到了,基本上这道题目也就解决了,或者更清晰的知道自己究竟是哪一点不明白,是状态转移不明白,还是实现代码不知道该怎么写,还是不理解遍历dp数组的顺序。

然后再问问题,目的性就很强了

2、斐波那契数

509. 斐波那契数 - 力扣(LeetCode)

斐波那契数,通常用 F(n) 表示,形成的序列称为 斐波那契数列 。该数列由 0 和 1 开始,后面的每一项数字都是前面两项数字的和。也就是: F(0) = 0,F(1) = 1 F(n) = F(n - 1) + F(n - 2),其中 n > 1 给你n ,请计算 F(n) 。

示例 1:

  • 输入:2
  • 输出:1
  • 解释:F(2) = F(1) + F(0) = 1 + 0 = 1

示例 2:

  • 输入:3
  • 输出:2
  • 解释:F(3) = F(2) + F(1) = 1 + 1 = 2

示例 3:

  • 输入:4
  • 输出:3
  • 解释:F(4) = F(3) + F(2) = 2 + 1 = 3

提示:

  • 0 <= n <= 30

思路

先动态规划五部曲

1、确定dp数组以及下标的含义

dp[i]的定义为:第i个数的斐波那契数值是dp[i]

2、确定递推公式

题目已经把递推公式直接给我们了,dp[i] = dp[i - 1] + dp[i - 2]

3、dp数组如何初始化

题目中也把如何初始化给我们了

1
2
dp[0] = 0;
dp[1] = 1;

4、确定遍历顺序

从递归公式中可以看出dp[i]是依赖前一个dp和前一个的前一个来决定的,那么遍历顺序一定是从前到后遍历的。

5、举例子推导dp数组

按照这个递推公式dp[i] = dp[i - 1] + dp[i - 2],我们来推导一下,当N为10的时候,dp数组应该是如下的数列:

0 1 1 2 3 5 8 13 21 34 55

如果代码写出来,发现结果不对,就把dp数组打印出来看看和我们推导的数列是不是一致的。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
class Solution {
public int fib(int n) {
if (n <= 1) return n;
int[] dp = new int[n + 1];
dp[0] = 0;
dp[1] = 1;
for (int index = 2; index <= n; index++){
dp[index] = dp[index - 1] + dp[index - 2];
}
return dp[n];
}
}

3、爬楼梯

70. 爬楼梯 - 力扣(LeetCode)

假设你正在爬楼梯。需要 n 阶你才能到达楼顶。

每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢?

示例 1:

1
2
3
4
5
输入:n = 2
输出:2
解释:有两种方法可以爬到楼顶。
1. 1 阶 + 1 阶
2. 2 阶

示例 2:

1
2
3
4
5
6
输入:n = 3
输出:3
解释:有三种方法可以爬到楼顶。
1. 1 阶 + 1 阶 + 1 阶
2. 1 阶 + 2 阶
3. 2 阶 + 1 阶

提示:

  • 1 <= n <= 45

思路

爬到第一层楼梯有一种方法,爬到二层楼梯有两种方法。

那么第一层楼梯再跨两步就到第三层 ,第二层楼梯再跨一步就到第三层。

所以到第三层楼梯的状态可以由第二层楼梯 和 到第一层楼梯状态推导出来,那么就可以想到动态规划了。

我们来分析一下,动规五部曲:

定义一个一维数组来记录不同楼层的状态

  1. 确定dp数组以及下标的含义

dp[i]: 爬到第i层楼梯,有dp[i]种方法

  1. 确定递推公式

如何可以推出dp[i]呢?

从dp[i]的定义可以看出,dp[i] 可以有两个方向推出来。

首先是dp[i - 1],上i-1层楼梯,有dp[i - 1]种方法,那么再一步跳一个台阶不就是dp[i]了么。

还有就是dp[i - 2],上i-2层楼梯,有dp[i - 2]种方法,那么再一步跳两个台阶不就是dp[i]了么。

那么dp[i]就是 dp[i - 1]与dp[i - 2]之和!

这里有人会问,之前的路不会重复吗?不会因为路径不同就是不同的路径。

所以dp[i] = dp[i - 1] + dp[i - 2] .

在推导dp[i]的时候,一定要时刻想着dp[i]的定义,否则容易跑偏。

这体现出确定dp数组以及下标的含义的重要性!

  1. dp数组如何初始化

再回顾一下dp[i]的定义:爬到第i层楼梯,有dp[i]种方法。

那么i为0,dp[i]应该是多少呢,这个可以有很多解释,但基本都是直接奔着答案去解释的。

例如强行安慰自己爬到第0层,也有一种方法,什么都不做也就是一种方法即:dp[0] = 1,相当于直接站在楼顶。

但总有点牵强的成分。

那还这么理解呢:我就认为跑到第0层,方法就是0啊,一步只能走一个台阶或者两个台阶,然而楼层是0,直接站楼顶上了,就是不用方法,dp[0]就应该是0.

其实这么争论下去没有意义,大部分解释说dp[0]应该为1的理由其实是因为dp[0]=1的话在递推的过程中i从2开始遍历本题就能过,然后就往结果上靠去解释dp[0] = 1。

从dp数组定义的角度上来说,dp[0] = 0 也能说得通。

需要注意的是:题目中说了n是一个正整数,题目根本就没说n有为0的情况。

所以本题其实就不应该讨论dp[0]的初始化!

我相信dp[1] = 1,dp[2] = 2,这个初始化大家应该都没有争议的。

所以我的原则是:不考虑dp[0]如何初始化,只初始化dp[1] = 1,dp[2] = 2,然后从i = 3开始递推,这样才符合dp[i]的定义。

  1. 确定遍历顺序

从递推公式dp[i] = dp[i - 1] + dp[i - 2];中可以看出,遍历顺序一定是从前向后遍历的

  1. 举例推导dp数组

举例当n为5的时候,dp table(dp数组)应该是这样的

70.爬楼梯

如果代码出问题了,就把dp table 打印出来,看看究竟是不是和自己推导的一样。

此时大家应该发现了,这不就是斐波那契数列么!

唯一的区别是,没有讨论dp[0]应该是什么,因为dp[0]在本题没有意义!

1
2
3
4
5
6
7
8
9
10
// 常规方式
public int climbStairs(int n) {
int[] dp = new int[n + 1];
dp[0] = 1;
dp[1] = 1;
for (int i = 2; i <= n; i++) {
dp[i] = dp[i - 1] + dp[i - 2];
}
return dp[n];
}

4、使用最小花费爬楼梯

746. 使用最小花费爬楼梯 - 力扣(LeetCode)

给你一个整数数组 cost ,其中 cost[i] 是从楼梯第 i 个台阶向上爬需要支付的费用。一旦你支付此费用,即可选择向上爬一个或者两个台阶。

你可以选择从下标为 0 或下标为 1 的台阶开始爬楼梯。

请你计算并返回达到楼梯顶部的最低花费。

示例 1:

1
2
3
4
5
输入:cost = [10,15,20]
输出:15
解释:你将从下标为 1 的台阶开始。
- 支付 15 ,向上爬两个台阶,到达楼梯顶部。
总花费为 15 。

示例 2:

1
2
3
4
5
6
7
8
9
10
输入:cost = [1,100,1,1,1,100,1,1,100,1]
输出:6
解释:你将从下标为 0 的台阶开始。
- 支付 1 ,向上爬两个台阶,到达下标为 2 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 4 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 6 的台阶。
- 支付 1 ,向上爬一个台阶,到达下标为 7 的台阶。
- 支付 1 ,向上爬两个台阶,到达下标为 9 的台阶。
- 支付 1 ,向上爬一个台阶,到达楼梯顶部。
总花费为 6 。

提示:

  • 2 <= cost.length <= 1000
  • 0 <= cost[i] <= 999

思路

1、确定dp数组以及下标的含义

使用动态规划,就要有一个数组来记录状态,本题只需要一个一维数组dp[i]就可以了。

dp[i]的定义:到达第i台阶所花费的最少体力为dp[i]

2、确定递推公式

可以有两个途径可以得到dp[i],一个是dp[i-1]一个是dp[i-2]

dp[i - 1] 跳到 dp[i] 需要花费 dp[i - 1] + cost[i - 1]。

dp[i - 2] 跳到 dp[i] 需要花费 dp[i - 2] + cost[i - 2]。

那么究竟是选从dp[i - 1]跳还是从dp[i - 2]跳呢?

一定是选最小的,所以dp[i] = min(dp[i - 1] + cost[i - 1], dp[i - 2] + cost[i - 2]);

3、dp数组如何初始化

看一下递归公式,dp[i]由dp[i - 1],dp[i - 2]推出,既然初始化所有的dp[i]是不可能的,那么只初始化dp[0]和dp[1]就够了,其他的最终都是dp[0]dp[1]推出。

那么 dp[0] 应该是多少呢? 根据dp数组的定义,到达第0台阶所花费的最小体力为dp[0],那么有同学可能想,那dp[0] 应该是 cost[0],例如 cost = [1, 100, 1, 1, 1, 100, 1, 1, 100, 1] 的话,dp[0] 就是 cost[0] 应该是1。

这里就要说明本题力扣为什么改题意,而且修改题意之后 就清晰很多的原因了。

新题目描述中明确说了 “你可以选择从下标为 0 或下标为 1 的台阶开始爬楼梯。” 也就是说 到达 第 0 个台阶是不花费的,但从 第0 个台阶 往上跳的话,需要花费 cost[0]。

所以初始化 dp[0] = 0,dp[1] = 0;

4、确定遍历顺序

最后一步,递归公式有了,初始化有了,如何遍历呢?

本题的遍历顺序其实比较简单,简单到很多同学都忽略了思考这一步直接就把代码写出来了。

因为是模拟台阶,而且dp[i]由dp[i-1]dp[i-2]推出,所以是从前到后遍历cost数组就可以了。

5、举例子推导dp数组

拿示例2:cost = [1, 100, 1, 1, 1, 100, 1, 1, 100, 1] ,来模拟一下dp数组的状态变化,如下:

img

如果大家代码写出来有问题,就把dp数组打印出来,看看和如上推导的是不是一样的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public int minCostClimbingStairs(int[] cost) {
int len = cost.length;

int[] dp = new int[len + 1];

dp[0] = 0;
dp[1] = 0;

for(int i = 2 ; i <= len ; i++){
dp[i] = Math.min(dp[i - 1] + cost[i - 1],dp[i - 2] + cost[i - 2]);
}
return dp[len];
}
}

5、不同路径

62. 不同路径 - 力扣(LeetCode)

一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。

机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。

问总共有多少条不同的路径?

示例 1:

img

1
2
输入:m = 3, n = 7
输出:28

示例 2:

1
2
3
4
5
6
7
输入:m = 3, n = 2
输出:3
解释:
从左上角开始,总共有 3 条路径可以到达右下角。
1. 向右 -> 向下 -> 向下
2. 向下 -> 向下 -> 向右
3. 向下 -> 向右 -> 向下

示例 3:

1
2
输入:m = 7, n = 3
输出:28

示例 4:

1
2
输入:m = 3, n = 3
输出:6

思路

机器人从(0,0)位置出发,到(m - 1, n - 1)终点。

按照动规五部曲来分析:

  1. 确定dp数组(dp table)以及下标的含义

dp[i][j] :表示从(0 ,0)出发,到(i, j) 有dp[i][j]条不同的路径。

  1. 确定递推公式

想要求dp[i]j,只能有两个方向来推导出来,即dp[i - 1]j 和 dp[i]j - 1。

此时在回顾一下 dp[i - 1]j 表示啥,是从(0, 0)的位置到(i - 1, j)有几条路径,dp[i]j - 1同理。

那么很自然,dp[i]j = dp[i - 1]j + dp[i]j - 1,因为dp[i]j只有这两个方向过来。

  1. dp数组的初始化

如何初始化呢,首先dp[i]0一定都是1,因为从(0, 0)的位置到(i, 0)的路径只有一条,那么dp[0]j也同理。

所以初始化代码为:

1
2
for (int i = 0; i < m; i++) dp[i][0] = 1;
for (int j = 0; j < n; j++) dp[0][j] = 1;
  1. 确定遍历顺序

这里要看一下递推公式dp[i]j = dp[i - 1]j + dp[i]j - 1,dp[i]j都是从其上方和左方推导而来,那么从左到右一层一层遍历就可以了。

这样就可以保证推导dp[i]j的时候,dp[i - 1]j 和 dp[i]j - 1一定是有数值的。

  1. 举例推导dp数组

如图所示:

62.不同路径1

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int uniquePaths(int m, int n) {
int[][] dp = new int[m][n];
for(int i = 0 ; i < n ; i++){
dp[0][i] = 1;
}
for(int i = 0 ; i < m ; i++){
dp[i][0] = 1;
}

for(int i = 1 ; i < m; i++){
for(int j = 1 ; j < n ;j++){
dp[i][j] = dp[i-1][j] + dp[i][j-1];
}
}
return dp[m-1][n-1];
}
}

6、不同路径2

63. 不同路径 II - 力扣(LeetCode)

一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为“Start” )。

机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为“Finish”)。

现在考虑网格中有障碍物。那么从左上角到右下角将会有多少条不同的路径?

img

网格中的障碍物和空位置分别用 1 和 0 来表示。

示例 1:

img

  • 输入:obstacleGrid = [[0,0,0],[0,1,0],[0,0,0]]
  • 输出:2 解释:
  • 3x3 网格的正中间有一个障碍物。
  • 从左上角到右下角一共有 2 条不同的路径:
    1. 向右 -> 向右 -> 向下 -> 向下
    2. 向下 -> 向下 -> 向右 -> 向右

示例 2:

img

  • 输入:obstacleGrid = [[0,1],[0,0]]
  • 输出:1

提示:

  • m == obstacleGrid.length
  • n == obstacleGrid[i].length
  • 1 <= m, n <= 100
  • obstacleGrid[i][j] 为 0 或 1

思路

第一次接触这种题目的同学可能会有点懵,这有障碍了,应该怎么算呢?有障碍的话,其实就是标记对应的dp table(dp数组)保持初始值(0)就可以了。

动态规划五部曲

1、确定dp数组以及下标的含义

dpij表示从00出发,到ij有dpij条不同的路径

2、确定递推公式

dpij = dp i-1 j + dp i j-1

因为有了障碍所以ij如果是障碍的话就保持初始状态0

1
2
3
if (obstacleGrid[i][j] == 0) { // 当(i, j)没有障碍的时候,再推导dp[i][j]
dp[i][j] = dp[i - 1][j] + dp[i][j - 1];
}

3、dp数组如何初始化

之前行和列都初始化为1,但是现在有了障碍之后,障碍之前都是1,障碍之后都是0

如图:

63.不同路径II

4、确定遍历顺序

从递归公式dp[i]j = dp[i - 1]j + dp[i]j - 1 中可以看出,一定是从左到右一层一层遍历,这样保证推导dp[i][j]的时候,dp[i - 1]j 和 dp[i]j - 1一定是有数值。

代码如下:

1
2
3
4
5
6
for (int i = 1; i < m; i++) {
for (int j = 1; j < n; j++) {
if (obstacleGrid[i][j] == 1) continue;
dp[i][j] = dp[i - 1][j] + dp[i][j - 1];
}
}
  1. 举例推导dp数组

拿示例1来举例如题:

63.不同路径II1

对应的dp table 如图:

63.不同路径II2

代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
class Solution {
public int uniquePathsWithObstacles(int[][] obstacleGrid) {
int m = obstacleGrid.length;
int n = obstacleGrid[0].length;
int[][] dp = new int[m][n];

// 起点或终点被堵,直接无路径
if (obstacleGrid[0][0] == 1 || obstacleGrid[m - 1][n - 1] == 1) {
return 0;
}

// 初始化第一列
for (int i = 0; i < m; i++) {
if (obstacleGrid[i][0] == 1) {
dp[i][0] = 0; // 遇到障碍
// 注意:后面即使没有障碍也无法到达,但我们会通过break避免后续赋值
// 或者你可以 break,因为后面不可能再有路径
break; // 很重要:一旦遇到障碍,后面第一列的格子都不能到达
} else {
dp[i][0] = 1;
}
}

// 初始化第一行
for (int j = 0; j < n; j++) {
if (obstacleGrid[0][j] == 1) {
dp[0][j] = 0;
break; // 同样,遇到障碍就终止
} else {
dp[0][j] = 1;
}
}

// 填充DP表
for (int i = 1; i < m; i++) {
for (int j = 1; j < n; j++) {
if (obstacleGrid[i][j] == 1) {
dp[i][j] = 0;
} else {
dp[i][j] = dp[i - 1][j] + dp[i][j - 1];
}
}
}

return dp[m - 1][n - 1];
}
}

7、整数拆分

343. 整数拆分 - 力扣(LeetCode)

给定一个正整数 n ,将其拆分为 k 个 正整数 的和( k >= 2 ),并使这些整数的乘积最大化。

返回 你可以获得的最大乘积 。

示例 1:

1
2
3
输入: n = 2
输出: 1
解释: 2 = 1 + 1, 1 × 1 = 1。

示例 2:

1
2
3
输入: n = 10
输出: 36
解释: 10 = 3 + 3 + 4, 3 × 3 × 4 = 36。

提示:

  • 2 <= n <= 58

思路

首先看这种题目,第一次的拆分会影响下一次拆分的决定,那么这时候会想到dp

那么来dp五部曲

  1. 确定dp数组(dp table)以及下标的含义

dp[i]:分拆数字i,可以得到的最大乘积为dp[i]。

dp[i]的定义将贯彻整个解题过程,下面哪一步想不懂了,就想想dp[i]究竟表示的是啥!

  1. 确定递推公式

可以想 dp[i]最大乘积是怎么得到的呢?

其实可以从1遍历j,然后有两种渠道得到dp[i].

一个是j * (i - j) 直接相乘。

一个是j * dp[i - j],相当于是拆分(i - j),对这个拆分不理解的话,可以回想dp数组的定义。

那有同学问了,j怎么就不拆分呢?

j是从1开始遍历,拆分j的情况,在遍历j的过程中其实都计算过了。那么从1遍历j,比较(i - j) j和dp[i - j] j 取最大的。递推公式:dp[i] = max(dp[i], max((i - j) j, dp[i - j] j));

也可以这么理解,j (i - j) 是单纯的把整数拆分为两个数相乘,而j dp[i - j]是拆分成两个以及两个以上的个数相乘。

如果定义dp[i - j] * dp[j] 也是默认将一个数强制拆成4份以及4份以上了。

所以递推公式:dp[i] = max({dp[i], (i - j) j, dp[i - j] j});

那么在取最大值的时候,为什么还要比较dp[i]呢?

因为在递推公式推导的过程中,每次计算dp[i],取最大的而已。

这里的 dp[i] 并不是“最终结果”,而是当前已知的最佳值。我们在 j 的循环中不断尝试不同的拆分方式,每试一种就更新一次 dp[i]。

  1. dp的初始化

不少同学应该疑惑,dp[0] dp[1]应该初始化多少呢?

有的题解里会给出dp[0] = 1,dp[1] = 1的初始化,但解释比较牵强,主要还是因为这么初始化可以把题目过了。

严格从dp[i]的定义来说,dp[0] dp[1] 就不应该初始化,也就是没有意义的数值。

拆分0和拆分1的最大乘积是多少?

这是无解的。

这里我只初始化dp[2] = 1,从dp[i]的定义来说,拆分数字2,得到的最大乘积是1,这个没有任何异议!

  1. 确定遍历顺序

确定遍历顺序,先来看看递归公式:dp[i] = max(dp[i], max((i - j) j, dp[i - j] j));

dp[i] 是依靠 dp[i - j]的状态,所以遍历i一定是从前向后遍历,先有dp[i - j]再有dp[i]。

所以遍历顺序为:

1
2
3
4
5
for (int i = 3; i <= n ; i++) {
for (int j = 1; j < i - 1; j++) {
dp[i] = max(dp[i], max((i - j) * j, dp[i - j] * j));
}
}

注意 枚举j的时候,是从1开始的。从0开始的话,那么让拆分一个数拆个0,求最大乘积就没有意义了。

j的结束条件是 j < i - 1 ,其实 j < i 也是可以的,不过可以节省一步,例如让j = i - 1,的话,其实在 j = 1的时候,这一步就已经拆出来了,重复计算,所以 j < i - 1

至于 i是从3开始,这样dp[i - j]就是dp[2]正好可以通过我们初始化的数值求出来。

更优化一步,可以这样:

1
2
3
4
5
for (int i = 3; i <= n ; i++) {
for (int j = 1; j <= i / 2; j++) {
dp[i] = max(dp[i], max((i - j) * j, dp[i - j] * j));
}
}

因为拆分一个数n 使之乘积最大,那么一定是拆分成m个近似相同的子数相乘才是最大的。

例如 6 拆成 3 3, 10 拆成 3 3 * 4。 100的话 也是拆成m个近似数组的子数 相乘才是最大的。

只不过我们不知道m究竟是多少而已,但可以明确的是m一定大于等于2,既然m大于等于2,也就是 最差也应该是拆成两个相同的 可能是最大值。

那么 j 遍历,只需要遍历到 n/2 就可以,后面就没有必要遍历了,一定不是最大值。

至于 “拆分一个数n 使之乘积最大,那么一定是拆分成m个近似相同的子数相乘才是最大的” 这个我就不去做数学证明了,感兴趣的同学,可以自己证明。

  1. 举例推导dp数组

举例当n为10 的时候,dp数组里的数值,如下:

343.整数拆分

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int integerBreak(int n) {
//dp[i] 为正整数 i 拆分后的结果的最大乘积
int[] dp = new int[n+1];
dp[2] = 1;
for(int i = 3; i <= n; i++) {
for(int j = 1; j <= i-j; j++) {
// 这里的 j 其实最大值为 i-j,再大只不过是重复而已,
//并且,在本题中,我们分析 dp[0], dp[1]都是无意义的,
//j 最大到 i-j,就不会用到 dp[0]与dp[1]
dp[i] = Math.max(dp[i], Math.max(j*(i-j), j*dp[i-j]));
// j * (i - j) 是单纯的把整数 i 拆分为两个数 也就是 i,i-j ,再相乘
//而j * dp[i - j]是将 i 拆分成两个以及两个以上的个数,再相乘。
}
}
return dp[n];
}
}

8、不同的二叉搜索树

96. 不同的二叉搜索树 - 力扣(LeetCode)

给你一个整数 n ,求恰由 n 个节点组成且节点值从 1 到 n 互不相同的 二叉搜索树 有多少种?返回满足题意的二叉搜索树的种数。

示例 1:

img

1
2
输入:n = 3
输出:5

示例 2:

1
2
输入:n = 1
输出:1

提示:

  • 1 <= n <= 19

思路

我们应该先举几个例子,画画图,看看有没有什么规律,如图:

96.不同的二叉搜索树

n为1的时候有一棵树,n为2有两棵树,这个是很直观的。

96.不同的二叉搜索树1

来看看n为3的时候,有哪几种情况。

当1为头结点的时候,其右子树有两个节点,看这两个节点的布局,是不是和 n 为2的时候两棵树的布局是一样的啊!

(可能有同学问了,这布局不一样啊,节点数值都不一样。别忘了我们就是求不同树的数量,并不用把搜索树都列出来,所以不用关心其具体数值的差异)

当3为头结点的时候,其左子树有两个节点,看这两个节点的布局,是不是和n为2的时候两棵树的布局也是一样的啊!

当2为头结点的时候,其左右子树都只有一个节点,布局是不是和n为1的时候只有一棵树的布局也是一样的啊!

发现到这里,其实我们就找到了重叠子问题了,其实也就是发现可以通过dp[1] 和 dp[2] 来推导出来dp[3]的某种方式。

思考到这里,这道题目就有眉目了。

dp[3],就是 元素1为头结点搜索树的数量 + 元素2为头结点搜索树的数量 + 元素3为头结点搜索树的数量

元素1为头结点搜索树的数量 = 右子树有2个元素的搜索树数量 * 左子树有0个元素的搜索树数量

元素2为头结点搜索树的数量 = 右子树有1个元素的搜索树数量 * 左子树有1个元素的搜索树数量

元素3为头结点搜索树的数量 = 右子树有0个元素的搜索树数量 * 左子树有2个元素的搜索树数量

有2个元素的搜索树数量就是dp[2]。

有1个元素的搜索树数量就是dp[1]。

有0个元素的搜索树数量就是dp[0]。

所以dp[3] = dp[2] dp[0] + dp[1] dp[1] + dp[0] * dp[2]

如图所示:

96.不同的二叉搜索树2

此时我们已经找到递推关系了,那么可以用动规五部曲再系统分析一遍。

  1. 确定dp数组(dp table)以及下标的含义

dp[i] : 1到i为节点组成的二叉搜索树的个数为dp[i]。

也可以理解是i个不同元素节点组成的二叉搜索树的个数为dp[i] ,都是一样的。

以下分析如果想不清楚,就来回想一下dp[i]的定义

  1. 确定递推公式

在上面的分析中,其实已经看出其递推关系, dp[i] += dp[以j为头结点左子树节点数量] * dp[以j为头结点右子树节点数量]

j相当于是头结点的元素,从1遍历到i为止。

所以递推公式:dp[i] += dp[j - 1] * dp[i - j]; ,j-1 为j为头结点左子树节点数量,i-j 为以j为头结点右子树节点数量

  1. dp数组如何初始化

初始化,只需要初始化dp[0]就可以了,推导的基础,都是dp[0]。

那么dp[0]应该是多少呢?

从定义上来讲,空节点也是一棵二叉树,也是一棵二叉搜索树,这是可以说得通的。

从递归公式上来讲,dp[以j为头结点左子树节点数量] * dp[以j为头结点右子树节点数量] 中以j为头结点左子树节点数量为0,也需要dp[以j为头结点左子树节点数量] = 1, 否则乘法的结果就都变成0了。

所以初始化dp[0] = 1

  1. 确定遍历顺序

首先一定是遍历节点数,从递归公式:dp[i] += dp[j - 1] * dp[i - j]可以看出,节点数为i的状态是依靠 i之前节点数的状态。

那么遍历i里面每一个数作为头结点的状态,用j来遍历。

1
2
3
4
5
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= i; j++) {
dp[i] += dp[j - 1] * dp[i - j];
}
}
  1. 举例推导dp数组

n为5时候的dp数组状态如图:

96.不同的二叉搜索树3

当然如果自己画图举例的话,基本举例到n为3就可以了,n为4的时候,画图已经比较麻烦了。

我这里列到了n为5的情况,是为了方便大家 debug代码的时候,把dp数组打出来,看看哪里有问题。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
class Solution {
public int numTrees(int n) {
int[] dp = new int[n + 1];
dp[0] = 1;
for(int i = 1 ; i <= n ; i++){
for(int j = 1 ; j <= i;j++){
dp[i] += dp[j - 1] * dp[i - j];
}
}
return dp[n];
}
}

9、动态规划:01背包理论基础

46. 携带研究材料(第六期模拟笔试)

题目描述

小明是一位科学家,他需要参加一场重要的国际科学大会,以展示自己的最新研究成果。他需要带一些研究材料,但是他的行李箱空间有限。这些研究材料包括实验设备、文献资料和实验样本等等,它们各自占据不同的空间,并且具有不同的价值。

小明的行李空间为 N,问小明应该如何抉择,才能携带最大价值的研究材料,每种研究材料只能选择一次,并且只有选与不选两种选择,不能进行切割。

输入描述

第一行包含两个正整数,第一个整数 M 代表研究材料的种类,第二个正整数 N,代表小明的行李空间。

第二行包含 M 个正整数,代表每种研究材料的所占空间。

第三行包含 M 个正整数,代表每种研究材料的价值。

输出描述

输出一个整数,代表小明能够携带的研究材料的最大价值。

输入示

1
2
3
6 1
2 2 3 1 5 2
2 3 1 5 4 3

输出示例

1
5

提示信息

小明能够携带 6 种研究材料,但是行李空间只有 1,而占用空间为 1 的研究材料价值为 5,所以最终答案输出 5。

数据范围:
1 <= N <= 5000
1 <= M <= 5000
研究材料占用空间和价值都小于等于 1000

思路

正式开始讲解背包问题!

对于面试的话,其实掌握01背包和完全背包,就够用了,最多可以再来一个多重背包。

如果这几种背包,分不清,我这里画了一个图,如下:

416.分割等和子集1

除此以外其他类型的背包,面试几乎不会问,都是竞赛级别的了,leetcode上连多重背包的题目都没有,所以题库也告诉我们,01背包和完全背包就够用了。

而完全背包又是也是01背包稍作变化而来,即:完全背包的物品数量是无限的。

所以背包问题的理论基础重中之重是01背包,一定要理解透!

leetcode上没有纯01背包的问题,都是01背包应用方面的题目,也就是需要转化为01背包问题。

所以我先通过纯01背包问题,把01背包原理讲清楚,后续再讲解leetcode题目的时候,重点就是讲解如何转化为01背包问题了。

01背包

有n件物品和一个最多能背重量为w 的背包。第i件物品的重量是weight[i],得到的价值是value[i] 。每件物品只能用一次,求解将哪些物品装入背包里物品价值总和最大。

这是标准的背包问题,以至于很多同学看了这个自然就会想到背包,甚至都不知道暴力的解法应该怎么解了。

这样其实是没有从底向上去思考,而是习惯性想到了背包,那么暴力的解法应该是怎么样的呢?

每一件物品其实只有两个状态,取或者不取,所以可以使用回溯法搜索出所有的情况,那么时间复杂度就是O(2^n),这里的n表示物品数量。

所以暴力的解法是指数级别的时间复杂度。进而才需要动态规划的解法来进行优化!

在下面的讲解中,我举一个例子:

背包最大重量为4。

物品为:

重量 价值
物品0 1 15
物品1 3 20
物品2 4 30

问背包能背的物品最大价值是多少?

以下讲解和图示中出现的数字都是以这个例子为例。

二维dp数组01背包

依然动规五部曲分析一波。

1、确定dp数组以及下标的含义

我们需要使用二维数组,为什么呢?

因为有两个维度需要分别表示:物品 和 背包容量

如图,二维数组为 dp[i]j。

动态规划-背包问题1

那么这里 i 、j、dp[i]j 分别表示什么呢?

i 来表示物品、j表示背包容量。

我们来尝试把上面的 二维表格填写一下。

动态规划的思路是根据子问题的求解推导出整体的最优解。

我们先看把物品0 放入背包的情况:

img

背包容量为0,放不下物品0,此时背包里的价值为0。

背包容量为1,可以放下物品0,此时背包里的价值为15.

背包容量为2,依然可以放下物品0 (注意 01背包里物品只有一个),此时背包里的价值为15。

背包容量为 3,上一行同一状态,背包只能放物品0,这次也可以选择物品1了,背包可以放物品1 或者 物品0,物品1价值更大,背包里的价值为20。

背包容量为 4,上一行同一状态,背包只能放物品0,这次也可以选择物品1了,背包可以放下物品0 和 物品1,背包价值为35。

以上举例,是比较容易看懂,我主要是通过这个例子,来帮助大家明确dp数组的含义。

上图中,我们看 dp[1] [4] 表示什么意思呢。

任取 物品0,物品1 放进容量为4的背包里,最大价值是 dp[1] [4]。

通过这个举例,我们来进一步明确dp数组的含义。

即dp[i] [j] 表示从下标为[0-i]的物品里任意取,放进容量为j的背包,价值总和最大是多少。

要时刻记着这个dp数组的含义,下面的一些步骤都围绕这dp数组的含义进行的,如果哪里看懵了,就来回顾一下i代表什么,j又代表什么。

2、确定递推公式

这里在把基本信息给出来:

重量 价值
物品0 1 15
物品1 3 20
物品2 4 30

对于递推公式,首先我们要明确有哪些方向可以推导出 dp[i][j]。

这里我们dp[1]4的状态来举例:

求取 dp[1]4 有两种情况:

  1. 放物品1
  2. 还是不放物品1

如果不放物品1, 那么背包的价值应该是 dp[0][4] 即 容量为4的背包,只放物品0的情况。

推导方向如图:

img

如果放物品1, 那么背包要先留出物品1的容量,目前容量是4,物品1 的容量(就是物品1的重量)为3,此时背包剩下容量为1。

容量为1,只考虑放物品0 的最大价值是 dp[0][1],这个值我们之前就计算过。

所以 放物品1 的情况 = dp[0][1] + 物品1 的价值,推导方向如图:

img

两种情况,分别是放物品1 和 不放物品1,我们要取最大值(毕竟求的是最大价值)

1
dp[1][4] = max(dp[0][4], dp[0][1] + 物品1 的价值)

以上过程,抽象化如下:

  • 不放物品i:背包容量为j,里面不放物品i的最大价值是dp[i - 1][j]。
  • 放物品i:背包空出物品i的容量后,背包容量为j - weight[i],dp[i - 1][j - weight[i]] 为背包容量为j - weight[i]且不放物品i的最大价值,那么dp[i - 1] [j - weight[i]] + value[i] (物品i的价值),就是背包放物品i得到的最大价值

递归公式: dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);

3、dp数组如何初始化

关于初始化,一定要和dp数组的定义吻合,否则到递推公式的时候就会越来越乱。

首先从dp[i][j]的定义出发,如果背包容量j为0的话,即dp[i][0],无论是选取哪些物品,背包价值总和一定为0。如图:

动态规划-背包问题2

在看其他情况。

状态转移方程 dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]); 可以看出i 是由 i-1 推导出来,那么i为0的时候就一定要初始化。

dp[0][j],即:i为0,存放编号0的物品的时候,各个容量的背包所能存放的最大价值。

那么很明显当 j < weight[0]的时候,dp[0][j] 应该是 0,因为背包容量比编号0的物品重量还小。

当j >= weight[0]时,dp[0][j] 应该是value[0],因为背包容量放足够放编号0物品。

1
2
3
4
5
6
7
for (int i = 1; i < weight.size(); i++) {  // 当然这一步,如果把dp数组预先初始化为0了,这一步就可以省略,但很多同学应该没有想清楚这一点。
dp[i][0] = 0;
}
// 正序遍历
for (int j = weight[0]; j <= bagweight; j++) {
dp[0][j] = value[0];
}

此时dp数组初始化情况如图所示:

动态规划-背包问题7

dp[0][j] 和 dp[i][0] 都已经初始化了,那么其他下标应该初始化多少呢?

其实从递归公式: dp[i][j] = max(dp[i - 1] [j], dp[i - 1] [j - weight[i]] + value[i]); 可以看出dp[i][j] 是由左上方数值推导出来了,那么 其他下标初始为什么数值都可以,因为都会被覆盖。

初始-1,初始-2,初始100,都可以!

但只不过一开始就统一把dp数组统一初始为0,更方便一些。

如图:
动态规划-背包问题10

4、确定遍历顺序

在如下图中,可以看出,有两个遍历的维度:物品与背包重量

动态规划-背包问题3

那么问题来了,先遍历 物品还是先遍历背包重量呢?

其实都可以!! 但是先遍历物品更好理解。

那么我先给出先遍历物品,然后遍历背包重量的代码。

1
2
3
4
5
6
7
8
// weight数组的大小 就是物品个数
for(int i = 1; i < weight.size(); i++) { // 遍历物品
for(int j = 0; j <= bagweight; j++) { // 遍历背包容量
if (j < weight[i]) dp[i][j] = dp[i - 1][j];
else dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);

}
}

选择 1:不选第 i 个物品

  • 最大价值是:dp[i - 1][j]

选择 2:选择第 i 个物品

  • 先腾出 weight[i] 的空间 → 剩余容量是 j - weight[i]
  • 在前 i-1 个物品中,用这个剩余容量能获得的最大价值是:dp[i - 1][j - weight[i]]
  • 加上当前物品的价值:+ value[i]
  • 所以总价值是:dp[i - 1][j - weight[i]] + value[i]

5、举例推导dp数组

来看一下对应的dp数组的数值,如图:

动态规划-背包问题4

最终结果就是dp[2][4]。

建议大家此时自己在纸上推导一遍,看看dp数组里每一个数值是不是这样的。

做动态规划的题目,最好的过程就是自己在纸上举一个例子把对应的dp数组的数值推导一下,然后在动手写代码!

很多同学做dp题目,遇到各种问题,然后凭感觉东改改西改改,怎么改都不对,或者稀里糊涂就改过了。

主要就是自己没有动手推导一下dp数组的演变过程,如果推导明白了,代码写出来就算有问题,只要把dp数组打印出来,对比一下和自己推导的有什么差异,很快就可以发现问题了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
import java.util.*;
import java.io.*;

public class Main{

static int m;//材料种类
static int n;//行李空间
static final int MAXN = 5003;//行李最大空间
static final int MAXM =5003;//物品做多数量
static final int[] weight = new int[MAXM];//物品体积
static final int[] value = new int[MAXM];//物品价值
static final int[][] dp = new int[MAXM][MAXN];

public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){
m = (int)in.nval;
in.nextToken();
n = (int)in.nval;
for(int i = 0 ; i < m ; i++){
in.nextToken();
weight[i] = (int)in.nval;
}
for(int i = 0 ; i < m ; i++){
in.nextToken();
value[i] = (int)in.nval;
}
out.println(fun(m,n,weight,value));

}
out.flush();
out.close();
}

public static int fun(int m,int n,int[] weight,int[] value){
//重置dp
for(int i = 0 ; i < m ; i++){
for(int j = 0 ; j <= n ; j++){
dp[i][j] = 0;
}
}

//初始化dp,初始化行
for(int i = 0 ; i < m ; i++){
dp[i][0] = 0;
}
//初始化列,注意这里列的范围是多了一列0背包空间的
for(int i = 0 ; i <= n ; i++){
if(weight[0] <= i){
dp[0][i] = value[0];
}else{
dp[0][i] = 0;
}
}

for(int i = 1 ; i < m ; i++){
for(int j = 1 ; j <= n ; j++){
if(j < weight[i]){
dp[i][j] = dp[i - 1][j];
}else{
dp[i][j] = Math.max(dp[i - 1][j] , dp[i - 1][j - weight[i]] + value[i]);
}
}
}
return dp[m - 1][n];
}
}
滚动数组

今天我们就来说一说滚动数组,其实在前面的题目中我们已经用到过滚动数组了,就是把二维dp降为一维dp,一些录友当时还表示比较困惑。

那么我们通过01背包,来彻底讲一讲滚动数组!

接下来还是用如下这个例子来进行讲解

背包最大重量为4。

物品为:

重量 价值
物品0 1 15
物品1 3 20
物品2 4 30

问背包能背的物品最大价值是多少?

用一维dp数组(滚动数组)

对于背包问题其实状态都是可以压缩的。

在使用二维数组的时候,递推公式:dp[i] [j] = max(dp[i - 1] [j], dp[i - 1] [j - weight[i]] + value[i]);

其实可以发现如果把dp[i - 1]那一层拷贝到dp[i]上,表达式完全可以是:dp[i] [j] = max(dp[i] [j], dp[i] [j - weight[i]] + value[i]);

与其把dp[i - 1]这一层拷贝到dp[i]上,不如只用一个一维数组了,只用dp[j](一维数组,也可以理解是一个滚动数组)。

这就是滚动数组的由来,需要满足的条件是上一层可以重复利用,直接拷贝到当前层。

读到这里估计大家都忘了 dp[i][j]里的i和j表达的是什么了,i是物品,j是背包容量。

dp[i]j 表示从下标为[0-i]的物品里任意取,放进容量为j的背包,价值总和最大是多少。

一定要时刻记住这里i和j的含义,要不然很容易看懵了。

动规五部曲分析如下:

1、确定dp数组的含义

在一维dp数组中,dp[j]表示:容量为j的背包,所背的物品价值可以最大为dp[j]。

2、一维dp数组的递推公式

二维dp数组的递推公式为: dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);

一维dp数组,其实就上上一层 dp[i-1] 这一层 拷贝的 dp[i]来。

所以在 上面递推公式的基础上,去掉i这个维度就好。

递推公式为:dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

以下为分析:

dp[j]为 容量为j的背包所背的最大价值。

dp[j]可以通过dp[j - weight[i]]推导出来,dp[j - weight[i]]表示容量为j - weight[i]的背包所背的最大价值。

dp[j - weight[i]] + value[i] 表示 容量为 [j - 物品i重量] 的背包 加上 物品i的价值。(也就是容量为j的背包,放入物品i了之后的价值即:dp[j])

此时dp[j]有两个选择,一个是取自己dp[j] 相当于 二维dp数组中的dp[i-1]j,即不放物品i,一个是取dp[j - weight[i]] + value[i],即放物品i,指定是取最大的,毕竟是求最大价值,

所以递归公式为:

1
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

可以看出相对于二维dp数组的写法,就是把dp[i][j]中i的维度去掉了

3、关于一维dp数组如何初始化

关于初始化,一定要和dp数组的定义吻合,否则到递推公式的时候就会越来越乱。

dp[j]表示:容量为j的背包,所背的物品价值可以最大为dp[j],那么dp[0]就应该是0,因为背包容量为0所背的物品的最大价值就是0。

那么dp数组除了下标0的位置,初始为0,其他下标应该初始化多少呢?

看一下递归公式:dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

dp数组在推导的时候一定是取价值最大的数,如果题目给的价值都是正整数那么非0下标都初始化为0就可以了。

这样才能让dp数组在递归公式的过程中取的最大的价值,而不是被初始值覆盖了。

那么我假设物品价值都是大于0的,所以dp数组初始化的时候,都初始为0就可以了。

4、一维dp数组遍历顺序

1
2
3
4
5
6
for(int i = 0; i < weight.size(); i++) { // 遍历物品
for(int j = bagWeight; j >= weight[i]; j--) { // 遍历背包容量
dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

}
}

这里大家发现和二维dp的写法中,遍历背包的顺序是不一样的!

二维dp遍历的时候,背包容量是从小到大,而一维dp遍历的时候,背包是从大到小。

为什么呢?

倒序遍历是为了保证物品i只被放入一次!。但如果一旦正序遍历了,那么物品0就会被重复加入多次!

举一个例子:物品0的重量weight[0] = 1,价值value[0] = 15

如果正序遍历

dp[1] = dp[1 - weight[0]] + value[0] = 15

dp[2] = dp[2 - weight[0]] + value[0] = 30

此时dp[2]就已经是30了,意味着物品0,被放入了两次,所以不能正序遍历。

为什么倒序遍历,就可以保证物品只放入一次呢?

倒序就是先算dp[2]

dp[2] = dp[2 - weight[0]] + value[0] = 15 (dp数组已经都初始化为0)

dp[1] = dp[1 - weight[0]] + value[0] = 15

所以从后往前循环,每次取得状态不会和之前取得状态重合,这样每种物品就只取一次了。

那么问题又来了,为什么二维dp数组遍历的时候不用倒序呢?

因为对于二维dp,dp[i][j]都是通过上一层即dp[i - 1]j计算而来,本层的dp[i][j]并不会被覆盖!

(如何这里读不懂,大家就要动手试一试了,空想还是不靠谱的,实践出真知!)

再来看看两个嵌套for循环的顺序,代码中是先遍历物品嵌套遍历背包容量,那可不可以先遍历背包容量嵌套遍历物品呢?

不可以!

因为一维dp的写法,背包容量一定是要倒序遍历(原因上面已经讲了),如果遍历背包容量放在上一层,那么每个dp[j]就只会放入一个物品,即:背包里只放入了一个物品。

所以一维dp数组的背包在遍历顺序上和二维其实是有很大差异的!,这一点大家一定要注意。

  1. 举例推导dp数组

一维dp,分别用物品0,物品1,物品2 来遍历背包,最终得到结果如下:
动态规划-背包问题9

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
import java.util.*;
import java.io.*;

public class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int m = (int) in.nval; // 物品数量
in.nextToken();
int n = (int) in.nval; // 背包容量

int[] weight = new int[m];
for (int i = 0; i < m; i++) {
in.nextToken();
weight[i] = (int) in.nval;
}

int[] value = new int[m];
for (int i = 0; i < m; i++) {
in.nextToken();
value[i] = (int) in.nval;
}

out.println(fun(m, n, weight, value));
}

out.flush();
out.close();
}

public static int fun(int m, int n, int[] weight, int[] value) {
// ✅ dp[j] 表示容量为 j 时的最大价值
int[] dp = new int[n + 1]; // 大小是 n+1,不是 m!

// 初始化:dp[0..n] 默认为 0,表示初始价值为0

for (int i = 0; i < m; i++) {
// ✅ 倒序遍历容量,防止重复选择
for (int j = n; j >= weight[i]; j--) {
dp[j] = Math.max(
dp[j], // 不选第 i 个物品
dp[j - weight[i]] + value[i] // 选第 i 个物品
);
}
}

return dp[n]; // 返回容量为 n 时的最大价值
}
}

10、分割等和子集

416. 分割等和子集 - 力扣(LeetCode)

给定一个只包含正整数的非空数组。是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。

注意: 每个数组中的元素不会超过 100 数组的大小不会超过 200

示例 1:

  • 输入: [1, 5, 11, 5]
  • 输出: true
  • 解释: 数组可以分割成 [1, 5, 5] 和 [11].

示例 2:

  • 输入: [1, 2, 3, 5]
  • 输出: false
  • 解释: 数组不能分割成两个元素和相等的子集.

提示:

  • 1 <= nums.length <= 200
  • 1 <= nums[i] <= 100

思路

这道题目初步看,和如下两题几乎是一样的,大家可以用回溯法,解决如下两题

  • 698.划分为k个相等的子集
  • 473.火柴拼正方形

这道题目是要找是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。

那么只要找到集合里能够出现 sum / 2 的子集总和,就算是可以分割成两个相同元素和子集了。

本题是可以用回溯暴力搜索出所有答案的,但最后超时了,也不想再优化了,放弃回溯。

是否有其他解法可以解决此题。

本题的本质是,能否把容量为 sum / 2的背包装满。

dp五部曲

1、确定dp数组以及下标的含义

dp[j] 表示容量为j的背包,所背的物品价值最大可以为dp[j]。

如果背包所载重量为target, dp[target]就是装满 背包之后的总价值,因为 本题中每一个元素的数值既是重量,也是价值,所以,当 dp[target] == target 的时候,背包就装满了。

2、确定递推公式

01背包的递推公式为:dp[j] = max(dp[j], dp[j - weight[i]] + value[i]);

本题,相当于背包里放入数值,那么物品i的重量是nums[i],其价值也是nums[i]。

所以递推公式:dp[j] = max(dp[j], dp[j - nums[i]] + nums[i]);

3、dp数组如何初始化

在01背包,一维dp如何初始化,已经讲过,

从dp[j]的定义来看,首先dp[0]一定是0。

如果题目给的价值都是正整数那么非0下标都初始化为0就可以了,如果题目给的价值有负数,那么非0下标就要初始化为负无穷。

这样才能让dp数组在递推的过程中取得最大的价值,而不是被初始值覆盖了。

本题题目中 只包含正整数的非空数组,所以非0下标的元素初始化为0就可以了。

4、确定遍历顺序

如果使用一维dp数组,物品遍历的for循环放在外层,遍历背包的for循环放在内层,且内层for循环倒序遍历!

1
2
3
4
5
6
// 开始 01背包
for(int i = 0; i < nums.size(); i++) {
for(int j = target; j >= nums[i]; j--) { // 每一个元素一定是不可重复放入,所以从大到小遍历
dp[j] = max(dp[j], dp[j - nums[i]] + nums[i]);
}
}

5、举例推导dp数组

dp[j]的数值一定是小于等于j的。

如果dp[j] == j 说明,集合中的子集总和正好可以凑成总和j,理解这一点很重要。

用例1,输入[1,5,11,5] 为例,如图:

416.分割等和子集2

最后dp[11] == 11,说明可以将这个数组分割成两个子集,使得两个子集的元素和相等。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public boolean canPartition(int[] nums) {
int sum = 0;
for (int num : nums) {
sum += num;
}

// ✅ 关键:如果总和是奇数,无法等分
if (sum % 2 == 1) return false;

int target = sum / 2;
int[] dp = new int[target + 1];

for (int i = 0; i < nums.length; i++) {
for (int j = target; j >= nums[i]; j--) {
dp[j] = Math.max(dp[j], dp[j - nums[i]] + nums[i]);
}
}

return dp[target] == target;
}
}

11、最后一块石头的重量2

1049. 最后一块石头的重量 II - 力扣(LeetCode)

有一堆石头,用整数数组 stones 表示。其中 stones[i] 表示第 i 块石头的重量。

每一回合,从中选出任意两块石头,然后将它们一起粉碎。假设石头的重量分别为 x 和 y,且 x <= y。那么粉碎的可能结果如下:

  • 如果 x == y,那么两块石头都会被完全粉碎;
  • 如果 x != y,那么重量为 x 的石头将会完全粉碎,而重量为 y 的石头新重量为 y-x。

最后,最多只会剩下一块 石头。返回此石头 最小的可能重量 。如果没有石头剩下,就返回 0。

示例 1:

1
2
3
4
5
6
7
输入:stones = [2,7,4,1,8,1]
输出:1
解释:
组合 2 和 4,得到 2,所以数组转化为 [2,7,1,8,1],
组合 7 和 8,得到 1,所以数组转化为 [2,1,1,1],
组合 2 和 1,得到 1,所以数组转化为 [1,1,1],
组合 1 和 1,得到 0,所以数组转化为 [1],这就是最优值。

示例 2:

1
2
输入:stones = [31,26,33,21,40]
输出:5

提示:

  • 1 <= stones.length <= 30
  • 1 <= stones[i] <= 100

思路

首先这个也是dp问题,因为选择石头的过程是有上一次选择的结果推出来的。

首先这道题目就是分石头,将石头分成两部分尽可能相等,然后给出最后的差值就可以了,那么跟上一题很相似。

dp五部曲

1、确定dp数组以及下标的含义

dp[j]表示容量为j的背包最多能装下dp[j] 大的石头

2、递推公式

之前的01背包公式推导一下,

1
dp[j] = Math.max(dp[j] , dp[j - stones[i]] + stones[i])

stones[i]表示石头的大小和价值

3、dp如何初始化

1
dp[o] = 0;

4、确定遍历顺序,第一层遍历物品,第二层倒序遍历价格

1
2
3
4
5
for(int i = 0 ; i < stones.length ; i++){
for(int j = sum / 2 ; j >= stones[i] ; j--){
dp[j] = Math.max(dp[j] , dp[j - stones[i]] + stones[i])
}
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int lastStoneWeightII(int[] stones) {
int sum = 0 ;
for(int i : stones){
sum+=i;
}
int target = sum / 2;//默认向下取整,然后这是背包的大小,背包尽可能只装一半的石头
int[] dp = new int[target + 1];
dp[0] = 0;

for(int i = 0 ; i < stones.length ; i++){
for(int j = target ; j >= stones[i] ; j--){
dp[j] = Math.max(dp[j],dp[j - stones[i]] + stones[i]);
}
}
return sum - 2 * dp[target];
}
}

12、目标和

494. 目标和 - 力扣(LeetCode)

给你一个非负整数数组 nums 和一个整数 target 。

向数组中的每个整数前添加 '+' 或 '-' ,然后串联起所有整数,可以构造一个 表达式 :

  • 例如,nums = [2, 1] ,可以在 2 之前添加 '+' ,在 1 之前添加 '-' ,然后串联起来得到表达式 "+2-1" 。

返回可以通过上述方法构造的、运算结果等于 target 的不同 表达式 的数目。

示例 1:

1
2
3
4
5
6
7
8
输入:nums = [1,1,1,1,1], target = 3
输出:5
解释:一共有 5 种方法让最终目标和为 3 。
-1 + 1 + 1 + 1 + 1 = 3
+1 - 1 + 1 + 1 + 1 = 3
+1 + 1 - 1 + 1 + 1 = 3
+1 + 1 + 1 - 1 + 1 = 3
+1 + 1 + 1 + 1 - 1 = 3

示例 2:

1
2
输入:nums = [1], target = 1
输出:1

提示:

  • 1 <= nums.length <= 20
  • 0 <= nums[i] <= 1000
  • 0 <= sum(nums[i]) <= 1000
  • -1000 <= target <= 1000

思路

首先这种题想到dp,因为第一次的选择会影响下一次的选择并且每次问题都是一样的。

既然为target,那么就一定有 left组合 - right组合 = target。

left + right = sum,而sum是固定的。right = sum - left

left - (sum - left) = target 推导出 left = (target + sum)/2 。

target是固定的,sum是固定的,left就可以求出来。

此时问题就是在集合nums中找出和为left的组合。

动态规划(二维dp数组)

假设加法的总和为x,那么减法对应的总和就是sum - x。

所以我们要求的是 x - (sum - x) = target

x = (target + sum) / 2

此时问题就转化为,用nums装满容量为x的背包,有几种方法。

这里的x,就是bagSize,也就是我们后面要求的背包容量。

大家看到(target + sum) / 2 应该担心计算的过程中向下取整有没有影响。

这么担心就对了,例如sum是5,target是2 的话其实就是无解的,所以:

1
if ((target + sum) % 2 == 1) return 0; // 此时没有方案

同时如果target 的绝对值已经大于sum,那么也是没有方案的。

1
if (abs(target) > sum) return 0; // 此时没有方案

因为每个物品(题目中的1)只用一次!

这次和之前遇到的背包问题不一样了,之前都是求容量为j的背包,最多能装多少。

本题则是装满有几种方法。其实这就是一个组合问题了。

1、确定dp数组以及下标的含义

先用 二维 dp数组求解本题,dp[i][j] :使用 下标为[0, i]的nums[i]能够凑满j(包括j)这么大容量的包,有dp[i][j]种方法。

再详细解释一下

假设你有一个数组:nums = [1, 1, 1, 1, 1],目标是凑出 target = 3。

你可以把每个数前面加 + 或 -,比如:

  • +1 +1 +1 -1 -1 = 1
  • +1 +1 -1 +1 -1 = 1
  • +1 +1 +1 +1 -1 = 3 ✅

我们要找的是:有多少种方式能让最终结果等于 target。

这个问题可以转化为一个 0-1 背包问题:
我们要从数组中选出一部分数字作为正数(比如加法部分),剩下的作为负数(减法部分)。

设:

  • 所有正数之和为 x
  • 所有负数之和为 sum - x
  • 那么 x - (sum - x) = target → x = (target + sum) / 2

所以问题变成:从数组中选出一些数,使它们的和等于 x,有多少种选法?

这就是一个 “装满背包有几种方法” 的组合问题。

拆解 dp[i][j] 的

dp[i][j] 表示:
使用下标从 0 到 i 的这些数字(即前 i+1 个数),
能够恰好凑出总和为 j 的方案数。

我们来用一个具体例子说明:

示例:

1
nums = [1, 2, 3]`,我们想凑出 `j = 3

我们定义 dp[i][j] 为:用 nums[0] 到 nums[i] 这些数,凑出和为 j 的方法数。

dp[2][3] 是什么意思?

用 nums[0], nums[1], nums[2](也就是 1, 2, 3)这三个数,凑出和为 3,有多少种方法?

答案是:

  1. 3(直接用 3)
  2. 1 + 2(用前两个数)

所以 dp[2][3] = 2


dp[1][3] 呢

用 nums[0], nums[1](也就是 1 和 2),凑出和为 3

只有 1 种方法:1 + 2 = 3 → dp[1][3] = 1


dp[0][1] 呢?

用 nums[0] = 1,凑出和为 1

只有 1 种方法:选它 → dp[0][1] = 1

2、开始推导递推公式

我们先手动推导一下,这个二维数组里面的数值。


先只考虑物品0,如图:

img

(这里的所有物品,都是题目中的数字1)。

装满背包容量为0 的方法个数是1,即 放0件物品。

装满背包容量为1 的方法个数是1,即 放物品0。

装满背包容量为2 的方法个数是0,目前没有办法能装满容量为2的背包。


接下来 考虑 物品0 和 物品1,如图:

img

装满背包容量为0 的方法个数是1,即 放0件物品。

装满背包容量为1 的方法个数是2,即 放物品0 或者 放物品1。

装满背包容量为2 的方法个数是1,即 放物品0 和 放物品1。

其他容量都不能装满,所以方法是0。


接下来 考虑 物品0 、物品1 和 物品2 ,如图:

img

装满背包容量为0 的方法个数是1,即 放0件物品。

装满背包容量为1 的方法个数是3,即 放物品0 或者 放物品1 或者 放物品2。

装满背包容量为2 的方法个数是3,即 放物品0 和 放物品1、放物品0 和 物品2、放物品1 和 物品2。

装满背包容量为3的方法个数是1,即 放物品0 和 物品1 和 物品2。


通过以上举例,我们来看 dp[2][2] 可以有哪些方向推出来。

如图红色部分:
img

dp[2][2] = 3,即 放物品0 和 放物品1、放物品0 和 物品 2、放物品1 和 物品2, 如图所示,三种方法:

img

容量为2 的背包,如果不放 物品2 有几种方法呢?

有 dp[1][2] 种方法,即 背包容量为2,只考虑物品0 和 物品1 ,有 dp[1][2] 种方法,如图:

img

容量为2 的背包, 如果放 物品2 有几种方法呢?

首先 要在背包里 先把物品2的容量空出来, 装满 刨除物品2容量 的背包 有几种方法呢?

刨除物品2容量后的背包容量为 1。

此时装满背包容量为1 有 dp[1][1] 种方法,即: 不放物品2,背包容量为1,只考虑物品 0 和 物品 1,有 dp[1][1] 种方法。

如图:

img

有录友可能疑惑,这里计算的是放满 容量为2的背包 有几种方法,那物品2去哪了?

在上面图中,你把物品2补上就好,同样是两种方法。

dp[2][2] = 容量为2的背包不放物品2有几种方法 + 容量为2的背包放物品2有几种方法

所以 dp[2][2] = dp[1][2] + dp[1][1] ,如图:

img

以上过程,抽象化如下:

  • 不放物品i:即背包容量为j,里面不放物品i,装满有dp[i - 1][j]中方法。
  • 放物品i: 即:先空出物品i的容量,背包容量为(j - 物品i容量),放满背包有 dp[i - 1][j - 物品i容量] 种方法。

本题中,物品i的容量是nums[i],价值也是nums[i]。

递推公式:dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]];

考到这个递推公式,我们应该注意到,j - nums[i] 作为数组下标,如果 j - nums[i] 小于零呢?

说明背包容量装不下 物品i,所以此时装满背包的方法值 等于 不放物品i的装满背包的方法,即:dp[i][j] = dp[i - 1][j];

所以递推公式:

1
2
if (nums[i] > j) dp[i][j] = dp[i - 1][j]; 
else dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]];

3、dp数组如何初始化

先明确递推的方向,如图,求解 dp[2][2] 是由 上方和左上方推出。

img

那么二维数组的最上行 和 最左列一定要初始化,这是递推公式推导的基础,如图红色部分:

img

关于dp[0][0]的值,在上面的递推公式讲解中已经讲过,装满背包容量为0 的方法数量是1,即 放0件物品。

那么最上行dp[0][j] 如何初始化呢?

dp[0][j]:只放物品0, 把容量为j的背包填满有几种方法。

只有背包容量为 物品0 的容量的时候,方法为1,正好装满。

其他情况下,要不是装不满,要不是装不下。

所以初始化:dp[0][nums[0]] = 1 ,其他均为0 。

表格最左列也要初始化,dp[i][0] : 背包容量为0, 放物品0 到 物品i,装满有几种方法。

都是有一种方法,就是放0件物品。

即 dp[i][0] = 1

但这里有例外,就是如果 物品数值就是0呢?

如果有两个物品,物品0为0, 物品1为0,装满背包容量为0的方法有几种。

  • 放0件物品
  • 放物品0
  • 放物品1
  • 放物品0 和 物品1

此时是有4种方法。

其实就是算数组里有t个0,然后按照组合数量求,即 2^t 。

初始化如下:

1
2
3
4
5
int numZero = 0;
for (int i = 0; i < nums.size(); i++) {
if (nums[i] == 0) numZero++;
dp[i][0] = (int) pow(2.0, numZero);
}
  1. 确定遍历顺序

在明确递推方向时,我们知道 当前值 是由上方和左上方推出。

那么我们的遍历顺序一定是 从上到下,从左到右。

因为只有这样,我们才能基于之前的数值做推导。

例如下图,如果上方没数值,左上方没数值,就无法推出 dp[2][2]。

img

那么是先 从上到下 ,再从左到右遍历,例如这样:

1
2
3
4
for (int i = 1; i < nums.size(); i++) { // 行,遍历物品
for (int j = 0; j <= bagSize; j++) { // 列,遍历背包
}
}

举例推导dp数组

输入:nums: [1, 1, 1, 1, 1], target: 3

bagSize = (target + sum) / 2 = (3 + 5) / 2 = 4

dp数组状态变化如下:

img

这么大的矩阵,我们是可以自己手动模拟出来的。

在模拟的过程中,既可以帮我们寻找规律,也可以帮我们验证 递推公式加遍历顺序是不是按照我们想象的结果推进的。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
class Solution {
public int findTargetSumWays(int[] nums, int target) {

// 01背包应用之“有多少种不同的填满背包最大容量的方法“
// 易于理解的二维数组解法及详细注释

int sum = 0;
for(int i = 0; i < nums.length; i++) {
sum += nums[i];
}

// 注意nums[i] >= 0的题目条件,意味着sum也是所有nums[i]的绝对值之和
// 这里保证了sum + target一定是大于等于零的,也就是left大于等于零(毕竟我们定义left大于right)
if(sum < Math.abs(target)){
return 0;
}

// 利用二元一次方程组将left用target和sum表示出来(替换掉right组合),详见代码随想录对此题的分析
// 如果所求的left数组和为小数,则作为整数数组的nums里的任何元素自然是没有办法凑出这个小数的
if((sum + target) % 2 != 0) {
return 0;
}

int left = (sum + target) / 2;

// dp[i][j]:遍历到数组第i个数时, left为j时的能装满背包的方法总数
int[][] dp = new int[nums.length][left + 1];

// 初始化最上行(dp[0][j]),当nums[0] == j时(注意nums[0]和j都一定是大于等于零的,因此不需要判断等于-j时的情况),有唯一一种取法可取到j,dp[0][j]此时等于1
// 其他情况dp[0][j] = 0
// java整数数组默认初始值为0
if (nums[0] <= left) {
dp[0][nums[0]] = 1;
}

// 初始化最左列(dp[i][0])
// 当从nums数组的索引0到i的部分有n个0时(n > 0),每个0可以取+/-,因此有2的n次方中可以取到j = 0的方案
// n = 0说明当前遍历到的数组部分没有0全为正数,因此只有一种方案可以取到j = 0(就是所有数都不取)
int numZeros = 0;
for(int i = 0; i < nums.length; i++) {
if(nums[i] == 0) {
numZeros++;
}
dp[i][0] = (int) Math.pow(2, numZeros);

}

// 递推公式分析:
// 当nums[i] > j时,这时候nums[i]一定不能取,所以是dp[i - 1][j]种方案数
// nums[i] <= j时,num[i]可取可不取,因此方案数是dp[i - 1][j] + dp[i - 1][j - nums[i]]
// 由递推公式可知,先遍历i或j都可
for(int i = 1; i < nums.length; i++) {
for(int j = 1; j <= left; j++) {
if(nums[i] > j) {
dp[i][j] = dp[i - 1][j];
} else {
dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]];
}
}
}


return dp[nums.length - 1][left];

}
}

动态规划(一维dp数组)

将二维dp数组压缩成一维dp数组,讲过滚动数组,原理是一样的,即重复利用每一行的数值。

既然是重复利用每一行,就是将二维数组压缩成一行。

dp[i][j] 去掉 行的维度,即 dp[j],表示:填满j(包括j)这么大容积的包,有dp[j]种方法。

2、确定递推公式

二维DP数组递推公式: dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]];

去掉维度i 之后,递推公式:dp[j] = dp[j] + dp[j - nums[i]] ,即:dp[j] += dp[j - nums[i]]

这个公式在后面在讲解背包解决排列组合问题的时候还会用到!

3、dp数组如何初始化

在上面 二维dp数组中,我们讲解过 dp[0][0] 初始为1,这里dp[0] 同样初始为1 ,即装满背包为0的方法有一种,放0件物品。

4、确定遍历顺序

遍历物品放在外循环,遍历背包在内循环,且内循环倒序(为了保证物品只使用一次)。

5、举例推导dp数组

输入:nums: [1, 1, 1, 1, 1], target: 3

bagSize = (target + sum) / 2 = (3 + 5) / 2 = 4

dp数组状态变化如下:

img

总结这个二维数组的意思就是用物品0到n装满背包有几种方法

注意两个排除:总数小于目标数排除,目标数+总数不为偶数也要排除,因为公式推导的过程中要除以2,如果不为偶数就会除不尽也就是说装不满背包,总会多一个或者少一个。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution {
public int findTargetSumWays(int[] nums, int target) {
int sum = 0 ;
for(int i : nums){
sum += i;
}
if(sum < Math.abs(target)){
return 0;
}
if((target + sum) % 2 != 0){
return 0;
}
int size = target + (sum - target) / 2;
int[] dp = new int[size + 1];
dp[0] = 1;

for(int i = 0 ; i < nums.length ; i++){
for(int j = size ; j >= nums[i]; j--){
dp[j] = dp[j] + dp[j - nums[i]];
}
}
return dp[size];
}
}

13、一和零

474. 一和零 - 力扣(LeetCode)

给你一个二进制字符串数组 strs 和两个整数 m 和 n 。

请你找出并返回 strs 的最大子集的长度,该子集中 最多 有 m 个 0 和 n 个 1 。

如果 x 的所有元素也是 y 的元素,集合 x 是集合 y 的 子集 。

示例 1:

1
2
3
4
输入:strs = ["10", "0001", "111001", "1", "0"], m = 5, n = 3
输出:4
解释:最多有 5 个 0 和 3 个 1 的最大子集是 {"10","0001","1","0"} ,因此答案是 4 。
其他满足题意但较小的子集包括 {"0001","1"} 和 {"10","1","0"} 。{"111001"} 不满足题意,因为它含 4 个 1 ,大于 n 的值 3 。

示例 2:

1
2
3
输入:strs = ["10", "0", "1"], m = 1, n = 1
输出:2
解释:最大的子集是 {"0", "1"} ,所以答案是 2 。

提示:

  • 1 <= strs.length <= 600
  • 1 <= strs[i].length <= 100
  • strs[i] 仅由 '0' 和 '1' 组成
  • 1 <= m, n <= 100

思路

首先这种题目要么动态规划,要么贪心,要么回溯,回溯会超时,贪心没想到什么能局部推到全局,每次选最大的?可能0或者1会超,每次选0和1少的,可能不是最大的,不能推所以贪心不行了,那么思考dp、

首先分析这是什么背包问题

01背包:物品只有一个

完全背包:物品无限多个

多重背包:物品数量不一样

分析题目,strs是物品,里面的子集都是一个,那么背包容量是多少呢?现在有m个0和n个1的背包大量小

分析完之后可以知道这是01背包了。

但是背包容量不同,维度不同。

开始dp五部曲

1、确定dp数组以及下标的含义

dp[i][j]:最多有i个0和j个1的strs的最大子集的大小为dp[i][j]

2、确定递推公式

dp[i][j]可以由前一个strs里的字符串推导出来,str里的字符串有zeroNum个0,oneNum个1

dp[i][j]就可以是dp[i-zeroNum][j - oneNum] + 1

对比一下就会发现,字符串的zeroNum和oneNum相当于物品的重量(weight[i]),字符串本身的个数相当于物品的价值(value[i])。

这就是一个典型的01背包! 只不过物品的重量有了两个维度而已。

3、dp数组初始化

dp的行是0的个数,列是1的个数,也就是dp[m][n]

dp[0][0]是0

4、确定遍历顺序

这里的维度其实可以是三维数组,但是压缩成二维了,所以背包容量要从后往前。

那么本题也是,物品就是strs里的字符串,背包容量就是题目描述中的m和n。

代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
for(String str : strs){//遍历物品
int oneNum = 0 ,zeroNum = 0;
for(char c : str){
if(c == '0') zeroNum++;
else oneNum++;
}
for(int i = m ; i >= zeroNum ; i--){//遍历背包
for(int j = n ; j >= oneNum ; j--){
dp[i][j] = Math.max(dp[i][j],dp[i - zeroNum][j-oneNum] + 1);
}
}

}

有同学可能想,那个遍历背包容量的两层for循环先后循序有没有什么讲究?

没讲究,都是物品重量的一个维度,先遍历哪个都行!

5、举例推导dp数组

以输入:[“10”,”0001”,”111001”,”1”,”0”],m = 3,n = 3为例

最后dp数组的状态如下所示:

474.一和零

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class Solution {
public int findMaxForm(String[] strs, int m, int n) {
//dp[i][j]表示i个0和j个1时的最大子集
int[][] dp = new int[m + 1][n + 1];
int oneNum, zeroNum;
for (String str : strs) {
oneNum = 0;
zeroNum = 0;
for (char ch : str.toCharArray()) {
if (ch == '0') {
zeroNum++;
} else {
oneNum++;
}
}
//倒序遍历
for (int i = m; i >= zeroNum; i--) {
for (int j = n; j >= oneNum; j--) {
dp[i][j] = Math.max(dp[i][j], dp[i - zeroNum][j - oneNum] + 1);
}
}
}
return dp[m][n];
}
}

番外总结

此时我们讲解了0-1背包的多种应用,

14、完全背包理论基础

这个跟01背包的区别就是每件物品都有无限个,也就是可以放入背包多次,求将哪些物品放入背包,价值最大

同样leetcode上没有纯完全背包问题,都是需要完全背包的各种应用,需要转化成完全背包问题,所以我这里还是以纯完全背包问题进行讲解理论和原理。

用个例题讲解一下

背包最大重量为4,物品为:

重量 价值
物品0 1 15
物品1 3 20
物品2 4 30

每件商品都有无限个!

问背包能背的物品最大价值是多少?

开始动态规划五部曲

1、确定dp数组以及下标的含义

dp[i][j] 表示从下标为[0-i]的物品,每个物品可以取无限次,放进容量为j的背包,价值总和最大是多少。

2、确定递推公式

这里在把基本信息给出来:

重量 价值
物品0 1 15
物品1 3 20
物品2 4 30

对于递推公式,首先我们要明确有哪些方向可以推导出 dp[ i ] [ j ]。

这里依然拿dp[1][4]的状态来举例

求取 dp[1][4]有两种情况:

  1. 放物品1
  2. 还是不放物品1

如果不放物品1, 那么背包的价值应该是 dp[0] [4] 即 容量为4的背包,只放物品0的情况。

推导方向如图:

img

如果放物品1, 那么背包要先留出物品1的容量,目前容量是4,物品1 的容量(就是物品1的重量)为3,此时背包剩下容量为1。

容量为1,只考虑放物品0 和物品1 的最大价值是 dp[1][1], 注意 这里和01背包就不同了

01背包,背包先空流出物品1的容量,此时容量为1,只考虑放物品0的最大价值是dp[0][1],因为01背包每个物品只有一个,既然空出物品1,那么背包中也不会再有物品1。

简单来说就是,用dp[i][j] 和 dp[i-1][j - weight[i]] + value[i]

1
2
3
4
5
6
7
8
9
10
11
12
13
14
for (int i = 0; i < n; i++) {
for (int j = 0; j <= W; j++) {
if (j < weight[i]) {
// 背包容量不够,只能不选
dp[i][j] = dp[i-1][j];
} else {
// 能选,取最大值
dp[i][j] = Math.max(
dp[i-1][j], // 不选
dp[i-1][j - weight[i]] + value[i] // 选
);
}
}
}

但是在完全背包中,物品是可以放无限个,所以即使空出物品1空间容量,那背包中也可能还有物品1,所以此时我们依然考虑放物品1和物品0的最大价值dp[1][1]而不是dp[0][1]

所以放物品1 的时候 = dp[1][1] + 物品1的价值

两种情况,分别是放物品1 和 不放物品1,我们要取最大值(毕竟求的是最大价值)

1
dp[1][4] = max(dp[0][4], dp[1][1] + 物品1 的价值)

以上过程,抽象化如下:

  • 不放物品i:背包容量为j,里面不放物品i的最大价值是dp[i - 1][j]。
  • 放物品i:背包空出物品i的容量后,背包容量为j - weight[i],dp[i][j - weight[i]] 为背包容量为j - weight[i]且不放物品i的最大价值,那么dp[i][j - weight[i]] + value[i] (物品i的价值),就是背包放物品i得到的最大价值

递推公式: dp[i][j] = max(dp[i - 1][j], dp[i][j - weight[i]] + value[i]);

(注意,完全背包二维dp数组 和 01背包二维dp数组 递推公式的区别,01背包中是 dp[i - 1][j - weight[i]] + value[i]))

3、dp数组如何初始化

关于初始化,一定要和dp数组的定义吻合,否则到递推公式的时候就会越来越乱。

首先从dp[ i ] [ j ]的定义出发,如果背包容量j为0的话,即dp[i][0],无论是选取哪些物品,背包价值总和一定为0。如图:

动态规划-背包问题2

在看其他情况。

状态转移方程 dp[i][j] = max(dp[i - 1][j], dp[i][j - weight[i]] + value[i]); 可以看出有一个方向 i 是由 i-1 推导出来,那么i为0的时候就一定要初始化。

dp[0][j],即:存放编号0的物品的时候,各个容量的背包所能存放的最大价值。

那么很明显当 j < weight[0]的时候,dp[0][j] 应该是 0,因为背包容量比编号0的物品重量还小。

当j >= weight[0]时,dp[0][j] 如果能放下weight[0]的话,就一直装,每一种物品有无限个。

代码初始化如下:

1
2
3
4
5
6
7
for (int i = 1; i < weight.size(); i++) {  // 当然这一步,如果把dp数组预先初始化为0了,这一步就可以省略,但很多同学应该没有想清楚这一点。
dp[i][0] = 0;
}

// 正序遍历,如果能放下就一直装物品0
for (int j = weight[0]; j <= bagWeight; j++)
dp[0][j] = dp[0][j - weight[0]] + value[0];

4、确定遍历顺序

这里习惯性的先遍历物品,再遍历背包容量

1
2
3
4
5
6
for (int i = 1; i < n; i++) { // 遍历物品
for(int j = 0; j <= bagWeight; j++) { // 遍历背包容量
if (j < weight[i]) dp[i][j] = dp[i - 1][j];
else dp[i][j] = max(dp[i - 1][j], dp[i][j - weight[i]] + value[i]);
}
}

5、举例推导dp数组

以本篇举例数据为例,填满了dp二维数组如图:

img

因为 物品0 的性价比是最高的,而且 在完全背包中,每一类物品都有无限个,所以有无限个物品0,既然物品0 性价比最高,当然是优先放物品0。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
import java.util.Scanner;

public class Main {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
int bagWeight = scanner.nextInt();

int[] weight = new int[n];
int[] value = new int[n];

for (int i = 0; i < n; i++) {
weight[i] = scanner.nextInt();
value[i] = scanner.nextInt();
}

int[][] dp = new int[n][bagWeight + 1];

// 初始化
for (int j = weight[0]; j <= bagWeight; j++) {
dp[0][j] = dp[0][j - weight[0]] + value[0];
}

// 动态规划
for (int i = 1; i < n; i++) {
for (int j = 0; j <= bagWeight; j++) {
if (j < weight[i]) {
dp[i][j] = dp[i - 1][j];
} else {
dp[i][j] = Math.max(dp[i - 1][j], dp[i][j - weight[i]] + value[i]);
}
}
}

System.out.println(dp[n - 1][bagWeight]);
scanner.close();
}
}

15、零钱兑换2

518. 零钱兑换 II - 力扣(LeetCode)

给你一个整数数组 coins 表示不同面额的硬币,另给一个整数 amount 表示总金额。

请你计算并返回可以凑成总金额的硬币组合数。如果任何硬币组合都无法凑出总金额,返回 0 。

假设每一种面额的硬币有无限个。

题目数据保证结果符合 32 位带符号整数。

示例 1:

1
2
3
4
5
6
7
输入:amount = 5, coins = [1, 2, 5]
输出:4
解释:有四种方式可以凑成总金额:
5=5
5=2+2+1
5=2+1+1+1
5=1+1+1+1+1

示例 2:

1
2
3
输入:amount = 3, coins = [2]
输出:0
解释:只用面额 2 的硬币不能凑成总金额 3 。

示例 3:

1
2
输入:amount = 10, coins = [10] 
输出:1

提示:

  • 1 <= coins.length <= 300
  • 1 <= coins[i] <= 5000
  • coins 中的所有值 互不相同
  • 0 <= amount <= 5000

思路

自己的思路,首先这里的amount=5相当于背包容量,然后coins相当于物品的重量,然后之前是返回最大价值,那么这里是返回最大方式,该怎么办呢?

本题和纯完全背包不一样,纯完全背包是凑成背包最大价值是多少,而本题是要求凑成总金额的物品组合个数!

注意题目描述中是凑成总金额的硬币组合数,为什么强调是组合数呢?

例如示例一:

5 = 2 + 2 + 1

5 = 2 + 1 + 2

这是一种组合,都是 2 2 1。

如果问的是排列数,那么上面就是两种排列了。

组合不强调元素之间的顺序,排列强调元素之间的顺序。

dp五部曲

1、确定dp下标和含义

dp[i][j] i表示物品,j表示背包容量,dp[i][j]表示容量j的背包装[0...i]的物品的有dp[i][j]种方法

2、确定递推公式

首先二维dp数组的递推公式为

dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i])

然后完全背包的dp是

dp[i][j] = max(dp[i - 1][j], dp[i][j - weight[i]] + value[i])

可以发现是后面那部分一个是i-1一个是i,主要原因就是完全背包物品有无限个。

那么这题求排列组合其实跟目标和问题是一样的,唯一的区别就是之前是01背包,现在是完全背包。

在目标和中推出的递推公式:dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]]

所以本题递推公式:dp[i][j] = dp[i - 1][j] + dp[i][j - nums[i]] ,区别依然是 dp[i - 1][j - nums[i]] 和 dp[i][j - nums[i]]

这个所以省略了很多,具体的推导过程看目标和

3、dp数组的初始化

那么二维数组的最上行 和 最左列一定要初始化,这是递推公式推导的基础,如图红色部分:

img

这里首先要关注的就是 dp[0][0] 应该是多少?

背包空间为0,装满「物品0」 的组合数有多少呢?

应该是 0 个, 但如果 「物品0」 的 数值就是0呢? 岂不是可以有无限个0 组合 和为0!

题目描述中说了1 <= coins.length <= 300 ,所以不用考虑 物品数值为0的情况。·那么最上行dp[0][j] 如何初始化呢?

dp[0][j]的含义:用「物品0」(即coins[0]) 装满 背包容量为j的背包,有几种组合方法。

如果 j 可以整除 物品0,那么装满背包就有1种组合方法。

初始化代码:

1
2
3
for (int j = 0; j <= bagSize; j++) {
if (j % coins[0] == 0) dp[0][j] = 1;
}

最左列如何初始化呢?

dp[i][0] 的含义:用物品i(即coins[i]) 装满容量为0的背包 有几种组合方法。

都有一种方法,即不装。

所以 dp[i][0] 都初始化为1

4、确定遍历顺序

维DP数组的完全背包的两个for循环先后顺序是无所谓的。

先遍历背包,还是先遍历物品都是可以的。

5、举例打印dp数组

以amount为5,coins为:[2,3,5] 为例:

dp数组应该是这样的:

1
2
3
1 0 1 0 1 0
1 0 1 1 1 1
1 0 1 1 1 2

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public int change(int amount, int[] coins) {
int wupin = coins.length;
int[][] dp = new int[wupin][amount + 1];
for(int j = 0 ; j <= amount ; j++){
if(j % coins[0] == 0) dp[0][j] = 1;
}
for(int i = 1; i < wupin ; i++){
dp[i][0] = 1;
}
for(int i = 1 ; i < wupin ; i++){
for(int j = 1 ; j <= amount ; j++){
if(j < coins[i]){
dp[i][j] = dp[i - 1][j];
}else{
dp[i][j] = dp[i - 1][j]+dp[i][j-coins[i]];
}
}
}
return dp[wupin-1][amount];
}
}

换成一维dp的话也是跟之前一样

1、确定dp数组以及下标的含义

dp[j]:凑成总金额j的货币组合数为dp[j]

2、确定递推公式

将二维dp的递推公式:dp[i][j] = dp[i - 1][j] + dp[i][j-coins[i]]

压缩成一维

dp[j] += dp[j - coins[i]]

3、dp数组如何初始化

装满背包容量为0 的方法是1,即不放任何物品,dp[0] = 1

4、确定遍历顺序

本题中我们是外层for循环遍历物品(钱币),内层for遍历背包(金钱总额),还是外层for遍历背包(金钱总额),内层for循环遍历物品(钱币)呢?

之前我们是外层遍历背包,内层遍历物品并且内层要调转顺序

但是本题就不行了

因为纯完全背包求得装满背包的最大价值是多少,和凑成总和的元素有没有顺序没关系,即:有顺序也行,没有顺序也行!

而本题要求凑成总和的组合数,元素之间明确要求没有顺序。

所以纯完全背包是能凑成总和就行,不用管怎么凑的。

本题是求凑出来的方案个数,且每个方案个数是组合数。

那么本题,两个for循环的先后顺序可就有说法了。

我们先来看 外层for循环遍历物品(钱币),内层for遍历背包(金钱总额)的情况。

代码如下:

1
2
3
4
5
for (int i = 0; i < coins.size(); i++) { // 遍历物品
for (int j = coins[i]; j <= amount; j++) { // 遍历背包容量
dp[j] += dp[j - coins[i]];
}
}

假设:coins[0] = 1,coins[1] = 5。

那么就是先把1加入计算,然后再把5加入计算,得到的方法数量只有{1, 5}这种情况。而不会出现{5, 1}的情况。

所以这种遍历顺序中dp[j]里计算的是组合数!

如果把两个for交换顺序,代码如下:

1
2
3
4
5
for (int j = 0; j <= amount; j++) { // 遍历背包容量
for (int i = 0; i < coins.size(); i++) { // 遍历物品
if (j - coins[i] >= 0) dp[j] += dp[j - coins[i]];
}
}

背包容量的每一个值,都是经过 1 和 5 的计算,包含了{1, 5} 和 {5, 1}两种情况。

此时dp[j]里算出来的就是排列数!

可能这里很多同学还不是很理解,建议动手把这两种方案的dp数组数值变化打印出来,对比看一看!(实践出真知)

5、举例推导dp数组

输入: amount = 5, coins = [1, 2, 5] ,dp状态图如下:

518.零钱兑换II

最后红色框dp[amount]为最终结果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
class Solution {
public int change(int amount, int[] coins) {
int[] dp = new int[amount + 1];

dp[0] = 1;

for(int i = 0 ; i < coins.length ; i++){
for(int j = coins[i]; j <= amount ; j++){
dp[j] += dp[j - coins[i]];
}
}

return dp[amount];
}
}

16、组合总和4

377. 组合总和 Ⅳ - 力扣(LeetCode)

给你一个由 不同 整数组成的数组 nums ,和一个目标整数 target 。请你从 nums 中找出并返回总和为 target 的元素组合的个数。

题目数据保证答案符合 32 位整数范围。

示例 1:

1
2
3
4
5
6
7
8
9
10
11
12
输入:nums = [1,2,3], target = 4
输出:7
解释:
所有可能的组合为:
(1, 1, 1, 1)
(1, 1, 2)
(1, 2, 1)
(1, 3)
(2, 1, 1)
(2, 2)
(3, 1)
请注意,顺序不同的序列被视作不同的组合。

示例 2:

1
2
输入:nums = [9], target = 3
输出:0

提示:

  • 1 <= nums.length <= 200
  • 1 <= nums[i] <= 1000
  • nums 中的所有元素 互不相同
  • 1 <= target <= 1000

思路

跟上题得出,上题求的是组合数,这题求的是排列数,这里就要思考遍历顺序了,01背包由于只有一次使用机会,所以不会有排列数和组合数这种情况,但是完全背包就会出现,

如果是外层背包,内层物品,那么求的是排列数,

如果是外层物品,内层背包,求的是组合数。

思路理解之后开始dp

1、确定dp数的含义

dp[j]表示凑成j的排列个数

在这道题目中target就是背包容量,nums就是物品

2、确定递推公式

dp[i] += dp[i - nums[j]]

3、确定遍历顺序

1
2
3
4
5
6
7
8
9
10
11
int[] dp = new int[target + 1];
dp[0] = 1; // 和为 0 的方案数是 1

for (int i = 1; i <= target; i++) { // 外层:目标值
for (int j = 0; j < nums.length; j++) { // 内层:每个数字
if (i >= nums[j]) {
dp[i] += dp[i - nums[j]]; // 累加方案数
}
}
}
return dp[target];

4、初始化

初始化的话

dp[0] = 1

没有意义,不用强行解释,单纯是为了得到答案

5、举例画出dp

我们再来用示例中的例子推导一下:

377.组合总和Ⅳ

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
class Solution {
public int combinationSum4(int[] nums, int target) {
int[] dp = new int[target + 1];
dp[0] = 1;
for (int i = 1; i <= target; i++) {
for (int j = 0; j < nums.length; j++) {
if (i >= nums[j]) {
dp[i] += dp[i - nums[j]];
}
}
}
return dp[target];
}
}

17、爬楼梯(进阶版)

57. 爬楼梯(第八期模拟笔试)

假设你正在爬楼梯。需要 n 阶你才能到达楼顶。

每次你可以爬至多m (1 <= m < n)个台阶。你有多少种不同的方法可以爬到楼顶呢?

注意:给定 n 是一个正整数。

输入描述:输入共一行,包含两个正整数,分别表示n, m

输出描述:输出一个整数,表示爬到楼顶的方法数。

输入示例:3 2

输出示例:3

提示:

当 m = 2,n = 3 时,n = 3 这表示一共有三个台阶,m = 2 代表你每次可以爬一个台阶或者两个台阶。

此时你有三种方法可以爬到楼顶。

  • 1 阶 + 1 阶 + 1 阶段
  • 1 阶 + 2 阶
  • 2 阶 + 1 阶

思路

之前没有讲背包问题,只是讲了一下爬楼梯最直接的动态规划方法(斐波那契),因为之前是至多只能爬两个台阶

这次可以爬m个台阶。

首先这是一个完全背包问题

那么n个台阶是目标数,物品数量就是m,那么这个题是求排列数,因为先爬1个楼梯再爬两个和先爬两个再爬一个是不一样的。

理清楚思路开始dp

1、确定dp下标和含义

dp[i] 表示组成 i 大小有dp[i]种方法

2、确定递推公式

dp[i] += dp[i - j]

这里的j是楼梯的大小,因为爬2楼有几种方法就是爬1楼有几种方法然后1楼爬一层

3、确定遍历顺序

1
2
3
4
5
6
7
for(int i = 1 ; i <= n ; i++){
for(int j = 0 ; j <= m ; j++){
if(i >= j){
dp[i] += dp[i - j];
}
}
}

4、确定初始化

dp[0] = 1

5、举例子

这里跟上一题几乎一样就不举例子了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import java.util.*;
import java.io.*;

public class Main{
public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){
int n = (int)in.nval;
in.nextToken();
int m = (int)in.nval;
out.println(fun(n,m));
}
out.flush();
out.close();
}

public static int fun(int n , int m){
int[] dp = new int[n + 1];
dp[0] = 1;

for(int i = 1; i <= n ; i++){
for(int j = 1 ; j <= m ; j++){
if(i >= j){
dp[i] += dp[i - j];
}
}
}
return dp[n];
}
}

18、零钱兑换

322. 零钱兑换 - 力扣(LeetCode)

给你一个整数数组 coins ,表示不同面额的硬币;以及一个整数 amount ,表示总金额。

计算并返回可以凑成总金额所需的 最少的硬币个数 。如果没有任何一种硬币组合能组成总金额,返回 -1 。

你可以认为每种硬币的数量是无限的。

示例 1:

1
2
3
输入:coins = [1, 2, 5], amount = 11
输出:3
解释:11 = 5 + 5 + 1

示例 2:

1
2
输入:coins = [2], amount = 3
输出:-1

示例 3:

1
2
输入:coins = [1], amount = 0
输出:0

提示:

  • 1 <= coins.length <= 12
  • 1 <= coins[i] <= 231 - 1
  • 0 <= amount <= 104

思路

肯定是完全背包问题开始dp

1、确定dp数组以及下标

dp[j] 表示凑足总额为 j 所需要钱币最少得个数为dp[j]

2、确定递推公式

凑足总额为j - coins[i]的最少个数为dp[j - coins[i]],那么只需要加上一个钱币coins[i]即dp[j - coins[i]] + 1就是dp[j](考虑coins[i])

所以dp[j] 要取所有 dp[j - coins[i]] + 1 中最小的。

递推公式:dp[j] = min(dp[j - coins[i]] + 1, dp[j]);

因为要考虑用不用第i个硬币

3、dp数组初始化

首先走卒金额为0的所需钱币的数量一定是0,所以dp[0] = 0

那么其他下标都是对应最大值,因为每次都要取最小

4、确定遍历顺序

首先这个是组合数,所以组合数的话需要先遍历背包数再遍历物品数

5、举例推导dp数组

以输入:coins = [1, 2, 5], amount = 5为例

322.零钱兑换

  • 如果 dp[j - coins[i]] 是 MAX_VALUE,说明“前面这部分都凑不出来”,那加一个硬币也无济于事,跳过
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public int coinChange(int[] coins, int amount) {
int[] dp = new int[amount + 1];
dp[0] = 0;
for(int i = 1 ; i <= amount ; i++){
dp[i] = Integer.MAX_VALUE;
}

for(int i = 0 ; i < coins.length ; i++){
for (int j = coins[i]; j <= amount; j++) {
//只有dp[j-coins[i]]不是初始最大值时,该位才有选择的必要
if (dp[j - coins[i]] != Integer.MAX_VALUE) {
//选择硬币数目最小的情况
dp[j] = Math.min(dp[j], dp[j - coins[i]] + 1);
}
}
}

return dp[amount] == Integer.MAX_VALUE ? -1 : dp[amount];
}
}

19、完全平方数

279. 完全平方数 - 力扣(LeetCode)

给你一个整数 n ,返回 和为 n 的完全平方数的最少数量 。

完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9 和 16 都是完全平方数,而 3 和 11 不是。

示例 1:

1
2
3
输入:n = 12
输出:3
解释:12 = 4 + 4 + 4

示例 2:

1
2
3
输入:n = 13
输出:2
解释:13 = 4 + 9

提示:

  • 1 <= n <= 104

思路

首先翻译一下题目:完全平方数就是物品(可以无限使用),凑成n,n就是背包,问凑满这个背包最少有多少物品

1、确定dp的含义和下标

dp[j] 表示凑满 j 最少需要 dp[j] 个平方数

2、确定递推公式

dp[j] 可以由dp[j - i i]推出, dp[j - i i] + 1 便可以凑成dp[j]。

此时我们要选择最小的dp[j],所以递推公式:dp[j] = min(dp[j - i * i] + 1, dp[j]);

3、dp数组如何初始化

dp[0]表示 和为0的完全平方数的最小数量,那么dp[0]一定是0

非0的值肯定就是最大值了

4、确定遍历顺序

这题求的是组合数和顺序数都无所谓因为是取最小值

组合数的话就需要外层物品,内层背包

1
2
3
4
5
6
for(int i = 0 ; i )//写到这里发现这个物品好像没限制,所以试试先背包再物品
for(int i = 0 ; i <= n ; i++){
for(int j = 1 ; j*j <= i ;j++){
dp[i] = Math.min(dp[i - j * j] + 1);
}
}

5、举例推导dp数组

已输入n为5例,dp状态图如下:

279.完全平方数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class Solution {
public int numSquares(int n) {
int[] dp = new int[n + 1];
dp[0] = 0;

for(int i = 1; i <= n ;i++){
dp[i] = Integer.MAX_VALUE;
}

for(int i = 0 ; i <= n ; i++){
for(int j = 1 ; j * j <= i ;j++){
dp[i] = Math.min(dp[i],dp[i - j * j] + 1);
}
}
return dp[n];
}

}

其他版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
class Solution {
// 版本一,先遍历物品, 再遍历背包
public int numSquares(int n) {
int max = Integer.MAX_VALUE;
int[] dp = new int[n + 1];
//初始化
for (int j = 0; j <= n; j++) {
dp[j] = max;
}
//如果不想要寫for-loop填充數組的話,也可以用JAVA內建的Arrays.fill()函數。
//Arrays.fill(dp, Integer.MAX_VALUE);

//当和为0时,组合的个数为0
dp[0] = 0;
// 遍历物品
for (int i = 1; i * i <= n; i++) {
// 遍历背包
for (int j = i * i; j <= n; j++) {
//if (dp[j - i * i] != max) {
dp[j] = Math.min(dp[j], dp[j - i * i] + 1);
//}
//不需要這個if statement,因爲在完全平方數這一題不會有"湊不成"的狀況發生( 一定可以用"1"來組成任何一個n),故comment掉這個if statement。
}
}
return dp[n];
}
}

class Solution {
// 版本二, 先遍历背包, 再遍历物品
public int numSquares(int n) {
int max = Integer.MAX_VALUE;
int[] dp = new int[n + 1];
// 初始化
for (int j = 0; j <= n; j++) {
dp[j] = max;
}
// 当和为0时,组合的个数为0
dp[0] = 0;
// 遍历背包
for (int j = 1; j <= n; j++) {
// 遍历物品
for (int i = 1; i * i <= j; i++) {
dp[j] = Math.min(dp[j], dp[j - i * i] + 1);
}
}
return dp[n];
}
}

20、单词拆分

139. 单词拆分 - 力扣(LeetCode)

给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。

注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。

示例 1:

1
2
3
输入: s = "leetcode", wordDict = ["leet", "code"]
输出: true
解释: 返回 true 因为 "leetcode" 可以由 "leet" 和 "code" 拼接成。

示例 2:

1
2
3
4
输入: s = "applepenapple", wordDict = ["apple", "pen"]
输出: true
解释: 返回 true 因为 "applepenapple" 可以由 "apple" "pen" "apple" 拼接成。
注意,你可以重复使用字典中的单词。

示例 3:

1
2
输入: s = "catsandog", wordDict = ["cats", "dog", "sand", "and", "cat"]
输出: false

提示:

  • 1 <= s.length <= 300
  • 1 <= wordDict.length <= 1000
  • 1 <= wordDict[i].length <= 20
  • s 和 wordDict[i] 仅由小写英文字母组成
  • wordDict 中的所有字符串 互不相同

思路

背包问题

单词就是物品,字符串s就是背包,单词能否组成字符串s,就是问物品能不能把背包装满。

拆分时可以重复使用字典中的单词,说明就是一个完全背包!

动规五部曲分析如下:

1、确定 dp 数组以及下标的含义

dp[i]:表示字符串 s 的前 i 个字符(即 s[0:i])是否可以被字典中的单词完全拆分。

  • dp[i] = true:表示子串 s[0...i-1](长度为 i)可以被拆分成字典中的单词。
  • dp[0] = true:空字符串总是可以被“拆分”(作为初始条件,方便后续递推)。

✅ 举例: 假设 s = "leetcode",i = 4,那么 dp[4] = true 表示子串 "leet" 可以被字典中的单词拆分(实际上它本身就在字典里)。

2、确定递推公式

我们要判断 dp[i] 是否为 true,可以尝试在 i 前面找一个位置 j(j < i),使得:

  1. dp[j] == true:表示前 j 个字符可以被拆分 ✅
  2. 子串 s[j:i](即从第 j 个字符到第 i-1 个字符)存在于字典中 ✅

    如果这两个条件都满足,那么 dp[i] 就可以设为 true。

3、dp数组如何初始化

从递推公式中可以看出,dp[i] 的状态依靠 dp[j] 是否为true,那么dp[0] 就是递推的根基,dp[0] 一定要为true,否则递推下去后面都是false了。

那么dp[0]有没有意义呢

dp[0] 表示如果字符串为空的话,说明出现在字典里。

但题目中说了“给定一个非空字符串s ” 所以测试数据中不会出现 i 为 0 的情况,那么dp[0] 初始为true完全就是为了推导公式

下标非0的dp[i] 初始化为false,只要没有被覆盖说明都是不可拆分为一个或多个在字典中出现的单词。

4、确定遍历顺序

题目中说是拆分为一个或多个在字典中出现的单词,所以这是完全背包。

还要讨论两层for循环的前后顺序。

如果求组合数,就是外层for遍历物品,内层遍历背包

如果是排列数,就是外层for遍历背包,内层遍历物品

本题求的事排列数!!!!为什么呢?

拿 s = “applepenapple”, wordDict = [“apple”, “pen”] 举例。

“apple”, “pen” 是物品,那么我们要求 物品的组合一定是 “apple” + “pen” + “apple” 才能组成 “applepenapple”。

“apple” + “apple” + “pen” 或者 “pen” + “apple” + “apple” 是不可以的,那么我们就是强调物品之间顺序。

所以说,本题一定是 先遍历 背包,再遍历物品。

5、举例推导dp[i]

以输入: s = “leetcode”, wordDict = [“leet”, “code”]为例,dp状态如图:
139.单词拆分

dp[s.size()]就是最终结果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public boolean wordBreak(String s, List<String> wordDict) {
HashSet<String> set = new HashSet<>(wordDict);
boolean[] valid = new boolean[s.length() + 1];
valid[0] = true;

for (int i = 1; i <= s.length(); i++) {
for (int j = 0; j < i && !valid[i]; j++) {
if (set.contains(s.substring(j, i)) && valid[j]) {
valid[i] = true;
}
}
}

return valid[s.length()];
}
}

21、多重背包理论基础

56. 携带矿石资源(第八期模拟笔试)

对于多重背包,我在力扣上还没发现对应的题目,所以这里就做一下简单介绍,大家大概了解一下。

有N种物品和一个容量为V 的背包。第i种物品最多有Mi件可用,每件耗费的空间是Ci ,价值是Wi 。求解将哪些物品装入背包可使这些物品的耗费的空间 总和不超过背包容量,且价值总和最大。

多重背包和01背包是非常像的, 为什么和01背包像呢?

每件物品最多有Mi件可用,把Mi件摊开,其实就是一个01背包问题了。

例如:

背包最大重量为10。

物品为:

重量 价值 数量
物品0 1 15 2
物品1 3 20 3
物品2 4 30 2

问背包能背的物品最大价值是多少?

和如下情况有区别么?

重量 价值 数量
物品0 1 15 1
物品0 1 15 1
物品1 3 20 1
物品1 3 20 1
物品1 3 20 1
物品2 4 30 1
物品2 4 30 1

毫无区别,这就转成了一个01背包问题了,且每个物品只用一次。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import java.io.*;
import java.util.*;

public class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int c = (int) in.nval; // 背包容量
in.nextToken();
int n = (int) in.nval; // 物品种类数

int[] weight = new int[n];
int[] value = new int[n];
int[] nums = new int[n];

// 读取重量
for (int j = 0; j < n; j++) {
in.nextToken();
weight[j] = (int) in.nval;
}
// 读取价值
for (int j = 0; j < n; j++) {
in.nextToken();
value[j] = (int) in.nval;
}
// 读取数量
for (int j = 0; j < n; j++) {
in.nextToken();
nums[j] = (int) in.nval;
}

int result = solveMultipleKnapsack(c, n, weight, value, nums);
out.println(result);
}

out.flush();
out.close();
}

public static int solveMultipleKnapsack(int c, int n, int[] weight, int[] value, int[] nums) {
// dp[j] 表示容量为 j 的背包能装下的最大价值
int[] dp = new int[c + 1];

// 外层:遍历每种物品
for (int i = 0; i < n; i++) {
// 内层:容量从大到小遍历(防止重复使用)
for (int j = c; j >= weight[i]; j--) {
// 枚举拿 k 个第 i 种物品
for (int k = 1; k <= nums[i]; k++) {
if (j >= k * weight[i]) {
dp[j] = Math.max(dp[j], dp[j - k * weight[i]] + k * value[i]);
} else {
break; // 容量不够,跳出
}
}
}
}

return dp[c];
}
}

22、打家劫舍

198. 打家劫舍 - 力扣(LeetCode)

你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。

给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。

示例 1:

1
2
3
4
输入:[1,2,3,1]
输出:4
解释:偷窃 1 号房屋 (金额 = 1) ,然后偷窃 3 号房屋 (金额 = 3)。
偷窃到的最高金额 = 1 + 3 = 4 。

示例 2:

1
2
3
4
输入:[2,7,9,3,1]
输出:12
解释:偷窃 1 号房屋 (金额 = 2), 偷窃 3 号房屋 (金额 = 9),接着偷窃 5 号房屋 (金额 = 1)。
偷窃到的最高金额 = 2 + 9 + 1 = 12 。

提示:

  • 1 <= nums.length <= 100
  • 0 <= nums[i] <= 400

思路

大家如果刚接触这样的题目,会有点困惑,当前的状态我是偷还是不偷呢?

仔细一想,当前房屋偷与不偷取决于 前一个房屋和前两个房屋是否被偷了。

所以这里就更感觉到,当前状态和前面状态会有一种依赖关系,那么这种依赖关系都是动规的递推公式。

当然以上是大概思路,打家劫舍是dp解决的经典问题,接下来我们来动规五部曲分析如下:

  1. 确定dp数组(dp table)以及下标的含义

dp[i]:考虑下标i(包括i)以内的房屋,最多可以偷窃的金额为dp[i]。

  1. 确定递推公式

决定dp[i]的因素就是第i房间偷还是不偷。

如果偷第i房间,那么dp[i] = dp[i - 2] + nums[i] ,即:第i-1房一定是不考虑的,找出 下标i-2(包括i-2)以内的房屋,最多可以偷窃的金额为dp[i-2] 加上第i房间偷到的钱。

如果不偷第i房间,那么dp[i] = dp[i - 1],即考 虑i-1房,(注意这里是考虑,并不是一定要偷i-1房,这是很多同学容易混淆的点)

然后dp[i]取最大值,即dp[i] = max(dp[i - 2] + nums[i], dp[i - 1]);

  1. dp数组如何初始化

从递推公式dp[i] = max(dp[i - 2] + nums[i], dp[i - 1]);可以看出,递推公式的基础就是dp[0] 和 dp[1]

从dp[i]的定义上来讲,dp[0] 一定是 nums[0],dp[1]就是nums[0]和nums[1]的最大值即:dp[1] = max(nums[0], nums[1]);

  1. 确定遍历顺序

dp[i] 是根据dp[i - 2] 和 dp[i - 1] 推导出来的,那么一定是从前到后遍历!

  1. 举例推导dp数组

以示例二,输入[2,7,9,3,1]为例。

198.打家劫舍

红框dp[nums.size() - 1]为结果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
class Solution {
public int rob(int[] nums) {
if(nums == null){
return 0;
}
if(nums.length == 1){
return nums[0];
}
int len = nums.length;
int[] dp = new int[len];

dp[0] = nums[0];
dp[1] = Math.max(nums[0],nums[1]);

for(int i = 2 ; i < len ; i++){
dp[i] = Math.max(dp[i - 2] + nums[i],dp[i - 1]);
}

return dp[len - 1];
}
}

23、打家劫舍2

213. 打家劫舍 II - 力扣(LeetCode)

你是一个专业的小偷,计划偷窃沿街的房屋,每间房内都藏有一定的现金。这个地方所有的房屋都 围成一圈 ,这意味着第一个房屋和最后一个房屋是紧挨着的。同时,相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警 。

给定一个代表每个房屋存放金额的非负整数数组,计算你 在不触动警报装置的情况下 ,今晚能够偷窃到的最高金额。

示例 1:

1
2
3
输入:nums = [2,3,2]
输出:3
解释:你不能先偷窃 1 号房屋(金额 = 2),然后偷窃 3 号房屋(金额 = 2), 因为他们是相邻的。

示例 2:

1
2
3
4
输入:nums = [1,2,3,1]
输出:4
解释:你可以先偷窃 1 号房屋(金额 = 1),然后偷窃 3 号房屋(金额 = 3)。
偷窃到的最高金额 = 1 + 3 = 4 。

示例 3:

1
2
输入:nums = [1,2,3]
输出:3

提示:

  • 1 <= nums.length <= 100
  • 0 <= nums[i] <= 1000

思路

这题跟上一题很像

对于一个数组,成环的话主要有如下三种情况:

  • 情况一:考虑不包含首尾元素

213.打家劫舍II

  • 情况二:考虑包含首元素,不包含尾元素

213.打家劫舍II1

  • 情况三:考虑包含尾元素,不包含首元素

213.打家劫舍II2

注意我这里用的是”考虑”,例如情况三,虽然是考虑包含尾元素,但不一定要选尾部元素! 对于情况三,取nums[1] 和 nums[3]就是最大的。

而情况二 和 情况三 都包含了情况一了,所以只考虑情况二和情况三就可以了。

所以这题就分成了两个打家劫舍1的问题,所以最后在讲两个部分比大小就行了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
public int rob(int[] nums) {
int len = nums.length;
if (len == 0) return 0;
if (len == 1) return nums[0];
if (len == 2) return Math.max(nums[0], nums[1]);

// 情况1: 抢 0 到 len-2
int res1 = robRange(nums, 0, len - 2);
// 情况2: 抢 1 到 len-1
int res2 = robRange(nums, 1, len - 1);

return Math.max(res1, res2);
}

// 辅助函数:在 [start, end] 范围内打家劫舍(线性问题)
private int robRange(int[] nums, int start, int end) {
int n = end - start + 1;
if (n == 1) return nums[start];
if (n == 2) return Math.max(nums[start], nums[start + 1]);

int[] dp = new int[n];
dp[0] = nums[start];
dp[1] = Math.max(nums[start], nums[start + 1]);

for (int i = 2; i < n; i++) {
dp[i] = Math.max(dp[i - 1], dp[i - 2] + nums[start + i]);
}

return dp[n - 1];
}
}

24、打家劫舍3

337. 打家劫舍 III - 力扣(LeetCode)

小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为 root 。

除了 root 之外,每栋房子有且只有一个“父“房子与之相连。一番侦察之后,聪明的小偷意识到“这个地方的所有房屋的排列类似于一棵二叉树”。 如果 两个直接相连的房子在同一天晚上被打劫 ,房屋将自动报警。

给定二叉树的 root 。返回 *在不触动警报的情况下 ,小偷能够盗取的最高金额* 。

示例 1:

img

1
2
3
输入: root = [3,2,3,null,3,null,1]
输出: 7
解释: 小偷一晚能够盗取的最高金额 3 + 3 + 1 = 7

示例 2:

img

1
2
3
输入: root = [3,4,5,1,3,null,1]
输出: 9
解释: 小偷一晚能够盗取的最高金额 4 + 5 = 9

提示:

  • 树的节点数在 [1, 104] 范围内
  • 0 <= Node.val <= 104

思路

对于树的话,首先就要想到遍历方式,前中后序(深度优先搜索)还是层序遍历(广度优先搜索)。

本题一定是要后序遍历,因为通过递归函数的返回值来做下一步计算。

与198.打家劫舍,213.打家劫舍II一样,关键是要讨论当前节点抢还是不抢。

如果抢了当前节点,两个孩子就不能动,如果没抢当前节点,就可以考虑抢左右孩子(注意这里说的是“考虑”)

1、暴力递归
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int rob(TreeNode root) {
if(root == null){
return 0;
}
if(root.left == null && root.right == null){
return root.val;
}

int val1 = root.val;
if(root.left != null){
val1 += rob(root.left.left) + rob(root.left.right);
}
if(root.right != null){
val1 += rob(root.right.right) + rob(root.right.left);
}

int val2 = rob(root.left) + rob(root.right);
return Math.max(val1,val2);
}
}

这个是可以的但是最后超时了。

因为偷和不偷的导致重复计算了两遍。

2、动态规划

这里可以使用一个长度为2的数组,记录当前节点偷和不偷所得到的最大金钱。

这道题目算是树形dp的入门题目,因为是在树上进行状态转移,我们在讲解二叉树的时候说过递归三部曲,那么下面以递归三部曲为框架,其中融合dp五部曲的内容进行思考

1、确定递归函数的参数和返回值。

这里我们要求一个节点 偷和不偷的两个状态所得到的金钱,那么返回值就是一个长度为2的数组

1
int[] robTree(TreeNode cur);

其实这里的返回数组就是dp数组。

所以dp数组的下标和含义:记录下标0记录不偷该节点所得到的最大金钱,下标为1记录偷该节点所得到的最大金钱。

那么长度为2的数组怎么标记树种每个节点的状态呢?

这是因为系统栈会保存每一层递归的参数。不理解的话看代码就知道了。

2、确定终止条件

在遍历过程中如果遇到空节点的话,就返回

1
2
3
if(cur == null){
return new int[]{0,0};
}

这也相当于dp数组的初始化

3、确定遍历顺序

首先明确的事使用后序遍历,因为要通过递归函数的返回值来做下一个计算。

通过递归左节点,得到左节点偷和不偷的金钱。

通过递归右节点,得到有节点偷和不偷的近期那。

1
2
int[] left = robTree(cur.left);
int[] right = robTree(cur.right);

4、确定单层递归的逻辑

如果是偷当前节点,那么左右孩子就不能偷,val1 = cur->val + left[0] + right[0];

如果不偷当前节点,那么左右孩子就可以偷,至于到底偷不偷一定是选一个最大的,所以:val2 = max(left[0], left[1]) + max(right[0], right[1]);

最后当前节点的状态就是{val2, val1}; 即:{不偷当前节点得到的最大金钱,偷当前节点得到的最大金钱}

  1. 举例推导dp数组

以示例1为例,dp数组状态如下:(注意用后序遍历的方式推导)

img

最后头结点就是 取下标0 和 下标1的最大值就是偷得的最大金钱。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
/**
* Definition for a binary tree node.
* public class TreeNode {
* int val;
* TreeNode left;
* TreeNode right;
* TreeNode() {}
* TreeNode(int val) { this.val = val; }
* TreeNode(int val, TreeNode left, TreeNode right) {
* this.val = val;
* this.left = left;
* this.right = right;
* }
* }
*/
class Solution {
public int rob(TreeNode root) {
if(root == null){
return 0;
}
int[] res = robAction1(root);
return Math.max(res[0],res[1]);
}

int[] robAction1(TreeNode root) {
int res[] = new int[2];
if (root == null)
return res;

int[] left = robAction1(root.left);
int[] right = robAction1(root.right);

res[0] = Math.max(left[0], left[1]) + Math.max(right[0], right[1]);
res[1] = root.val + left[0] + right[0];
return res;
}
}

25、买卖股票的最佳时机

121. 买卖股票的最佳时机 - 力扣(LeetCode)

给定一个数组 prices ,它的第 i 个元素 prices[i] 表示一支给定股票第 i 天的价格。

你只能选择 某一天 买入这只股票,并选择在 未来的某一个不同的日子 卖出该股票。设计一个算法来计算你所能获取的最大利润。

返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回 0 。

示例 1:

1
2
3
4
输入:[7,1,5,3,6,4]
输出:5
解释:在第 2 天(股票价格 = 1)的时候买入,在第 5 天(股票价格 = 6)的时候卖出,最大利润 = 6-1 = 5 。
注意利润不能是 7-1 = 6, 因为卖出价格需要大于买入价格;同时,你不能在买入前卖出股票。

示例 2:

1
2
3
输入:prices = [7,6,4,3,1]
输出:0
解释:在这种情况下, 没有交易完成, 所以最大利润为 0。

提示:

  • 1 <= prices.length <= 105
  • 0 <= prices[i] <= 104

思路

贪心

由于这个是只买一次,那么只找左边最小,右边最大就行了,那么就直接贪心就好了

1
2
3
4
5
6
7
8
9
10
11
12
13
class Solution {
public int maxProfit(int[] prices) {
// 找到一个最小的购入点
int low = Integer.MAX_VALUE;
// res不断更新,直到数组循环完毕
int res = 0;
for(int i = 0; i < prices.length; i++){
low = Math.min(prices[i], low);
res = Math.max(prices[i] - low, res);
}
return res;
}
}

动态规划的思路

dp五部曲

1、确定dp数组以及下标的含义

dp[i][0]表示第i天持有股票所得最多现金

其实一开始现金是 0 ,那么加入第 i 天买入股票现金就是-prices[ i ] ,这是现金是一个负数

dp[i][1]表示第i天不持有股票所得最多现金

注意这里说的是持有,持有不代表当天买入,也有可能是昨天就买入了,今天保持持有状态

2、确定递推公式

如果第 i 天持有股票即dp[i][0] ,那么可以由两个状态推出来

  • 第i - 1 天就 持有股票,那么就保持现状,所得现金就是昨天持有股票的所得现金dp[i - 1][0]
  • 第 i 天买入股票,所得现金就是买入今天的股票后所得的现金就是 - prices[ i ];

然后取最大的

如果第 i 天不持有股票即dp[i][1],也可以由两个状态推出来

  • 第 i - 1 天就不持有股票,那么就保持现状dp[i - 1][1]
  • 第 i 天卖出股票,所得现金就是按照今天股票价格卖出后所得现金prices[i] + dp[i - 1][0]

同样dp[i][1]取最大的

3、dp数组如何初始化

从递推公式看出来,要从dp[0][0]和dp[0][1]推导出来

那么dp[0][0]表示第0天持有股票,此时股票就一定是买入股票了,所以dp[0][0] -= prices[0]

dp[0][1]表示第0天不持有股票,不持有股票那么现金就是0,所以dp[0][1] = 0;

4、确定遍历顺序

肯定是从前往后

5、举例推导dp数组

以示例1,输入:[7,1,5,3,6,4]为例,dp数组状态如下:

121.买卖股票的最佳时机

dp[5][1]就是最终结果。

为什么不是dp[5][0]呢?

因为本题中不持有股票状态所得金钱一定比持有股票状态得到的多

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public int maxProfit(int[] prices) {
if (prices == null || prices.length == 0) return 0;
int length = prices.length;
// dp[i][0]代表第i天持有股票的最大收益
// dp[i][1]代表第i天不持有股票的最大收益
int[][] dp = new int[length][2];
int result = 0;
dp[0][0] = -prices[0];
dp[0][1] = 0;
for (int i = 1; i < length; i++) {
dp[i][0] = Math.max(dp[i - 1][0], -prices[i]);
dp[i][1] = Math.max(dp[i - 1][0] + prices[i], dp[i - 1][1]);
}
return dp[length - 1][1];
}
}

26、买股票最佳时机2

122. 买卖股票的最佳时机 II - 力扣(LeetCode)

给你一个整数数组 prices ,其中 prices[i] 表示某支股票第 i 天的价格。

在每一天,你可以决定是否购买和/或出售股票。你在任何时候 最多 只能持有 一股 股票。你也可以先购买,然后在 同一天 出售。

返回 你能获得的 最大 利润 。

示例 1:

1
2
3
4
5
输入:prices = [7,1,5,3,6,4]
输出:7
解释:在第 2 天(股票价格 = 1)的时候买入,在第 3 天(股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
随后,在第 4 天(股票价格 = 3)的时候买入,在第 5 天(股票价格 = 6)的时候卖出, 这笔交易所能获得利润 = 6 - 3 = 3。
最大总利润为 4 + 3 = 7 。

示例 2:

1
2
3
4
输入:prices = [1,2,3,4,5]
输出:4
解释:在第 1 天(股票价格 = 1)的时候买入,在第 5 天 (股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5 - 1 = 4。
最大总利润为 4 。

示例 3:

1
2
3
输入:prices = [7,6,4,3,1]
输出:0
解释:在这种情况下, 交易无法获得正利润,所以不参与交易可以获得最大利润,最大利润为 0。

提示:

  • 1 <= prices.length <= 3 * 104
  • 0 <= prices[i] <= 104

思路

这题可以用贪心,但是这题也可以用动规的解法。

这题和上题的唯一区别就是本题股票可以买卖多次, 注意,只有一只股票,所以再次购买前要出售掉之前的股票

在dp五部曲中,除了递推公式不同,其他都是一样的,所以这里重点讲递推公式

1、dp数组的含义

  • dp[i][0]表示第 i 天持有股票所得现金
  • dp[i][1]表示第 i 天不持有股票所得最多现金

如果第 i 天持有股票即 dp[i][0],那么可以由两个状态推出来

  • 第 i 天买入股票,所得现金就是昨天不持有股票的所得现金减去 今天的股票价格dp[i - 1][1] - prices[i]

  • 第 i 天买入股票,所得现金就是昨天不持有股票的所得现金减去 今天的股票价格 即 dp[i - 1][1] - prices[i]

这里和第一题唯一不同的地方,就是推导dp[i] [0] 的时候,第i 天买入股票的时候

上一题,因为全程只能买卖一次,所以如果买入股票,那么第 i 天 持有股票即dp[i][0]一定就是-prices[i]

而本题,因为一只股票可以买卖多次,所以当第 i 天买入股票的时候,所持有的现金可能有之前买卖过的利润

那么第 i 天持有股票即dp[i][0],如果第 i 天买入股票,所得现金就是昨天不持有股票的所得现金 减去 今天的股票价格 dp[i - 1][1] - prices[i]

在来看看如果第 i 天不持有股票的情况即dp[i][1]的情况,依然可以由两个状态推出来

  • 第i - 1 天就不持有股票,那么就保持现状,所得现金就是昨天不持有股票的所得现金 即 dp[i - 1][1]
  • 第 i 天卖出股票,所得现金就是按照今天股票价格卖出后所得现金即prices[i] + dp[i - 1][0]
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19

// 动态规划
class Solution {
// 实现1:二维数组存储
// 可以将每天持有与否的情况分别用 dp[i][0] 和 dp[i][1] 来进行存储
// 时间复杂度:O(n),空间复杂度:O(n)
public int maxProfit(int[] prices) {
int n = prices.length;
int[][] dp = new int[n][2]; // 创建二维数组存储状态
dp[0][0] = 0; // 初始状态
dp[0][1] = -prices[0];
for (int i = 1; i < n; ++i) {
dp[i][0] = Math.max(dp[i - 1][0], dp[i - 1][1] + prices[i]); // 第 i 天,没有股票
dp[i][1] = Math.max(dp[i - 1][1], dp[i - 1][0] - prices[i]); // 第 i 天,持有股票
}
return dp[n - 1][0]; // 卖出股票收益高于持有股票收益,因此取[0]
}
}

27、买卖股票的最佳时机3

123. 买卖股票的最佳时机 III - 力扣(LeetCode)

给定一个数组,它的第 i 个元素是一支给定的股票在第 i 天的价格。

设计一个算法来计算你所能获取的最大利润。你最多可以完成 两笔 交易。

注意:你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。

示例 1:

1
2
3
4
输入:prices = [3,3,5,0,0,3,1,4]
输出:6
解释:在第 4 天(股票价格 = 0)的时候买入,在第 6 天(股票价格 = 3)的时候卖出,这笔交易所能获得利润 = 3-0 = 3 。
随后,在第 7 天(股票价格 = 1)的时候买入,在第 8 天 (股票价格 = 4)的时候卖出,这笔交易所能获得利润 = 4-1 = 3 。

示例 2:

1
2
3
4
5
输入:prices = [1,2,3,4,5]
输出:4
解释:在第 1 天(股票价格 = 1)的时候买入,在第 5 天 (股票价格 = 5)的时候卖出, 这笔交易所能获得利润 = 5-1 = 4 。
注意你不能在第 1 天和第 2 天接连购买股票,之后再将它们卖出。
因为这样属于同时参与了多笔交易,你必须在再次购买前出售掉之前的股票。

示例 3:

1
2
3
输入:prices = [7,6,4,3,1] 
输出:0
解释:在这个情况下, 没有交易完成, 所以最大利润为 0。

示例 4:

1
2
输入:prices = [1]
输出:0

提示:

  • 1 <= prices.length <= 105
  • 0 <= prices[i] <= 105

思路

这道题跟前面两个相比难了很多,至多买卖两次,这意味着可以买卖一次,可以两次,也可以不买卖

用dp五部曲详细分析一下

1、确定dp数组以及下标的含义

一天一共就有五个状态

0、没有操作

1、第一次持有股票

2、第一次不持有股票

3、第二次持有股票

4、第二次不持有股票

dp[i][j] 中 i 表示第 i 天,j 为[0 - 4]五个状态,dp[i][j]表示第 i 天状态 j 所剩最大现金。

2、确定递推公式

达到dp[i][1]状态,有两个具体操作

  • 操作一:第 i 天买入股票了,那么dp[i][1] = dp[i - 1][0] - prices[i]
  • 操作二:第 i 天没哟操作,而是沿用前一天买入的状态,即dp[i][1] = dp[i - 1][1]

然后两个取最大的

同理dp[i][2]也是两个操作

然后一直推出剩下的状态部分

3、dp数组如何初始化

第0天没有操作,这个最容易想到,就是0

第0天做第一次买入的操作dp[0][1] = -prices[0]

第0天做第一次卖出的动作,就是0

第0天第二次买入操作,初始值应该是多少呢?

第二次买入依赖于第一次卖出的状态,其实相当于第0天第一次买入了,第一次卖出了,然后再买入一次(第二次买入),那么现在手头上没有现金,只要买入,现金就做相应的减少。

所以第二次买入操作,初始化为dp[0][3] = -prices[0]

同理第二次卖出初始化问为0

4、确定遍历顺序

从递归公式可以看出一定是从前往后的

5、举例推导dp数组

以输入[1,2,3,4,5]为例

123.买卖股票的最佳时机III

大家可以看到红色框为最后两次卖出的状态。

现在最大的时候一定是卖出的状态,而两次卖出的状态现金最大一定是最后一次卖出。如果想不明白的录友也可以这么理解:如果第一次卖出已经是最大值了,那么我们可以在当天立刻买入再立刻卖出。所以dp[4][4]已经包含了dp[4][2]的情况。也就是说第二次卖出手里所剩的钱一定是最多的。

所以最终最大利润是dp[4][4]

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
// 版本一
class Solution {
public int maxProfit(int[] prices) {
int len = prices.length;
// 边界判断, 题目中 length >= 1, 所以可省去
if (prices.length == 0) return 0;

/*
* 定义 5 种状态:
* 0: 没有操作, 1: 第一次买入, 2: 第一次卖出, 3: 第二次买入, 4: 第二次卖出
*/
int[][] dp = new int[len][5];
dp[0][1] = -prices[0];
// 初始化第二次买入的状态是确保 最后结果是最多两次买卖的最大利润
dp[0][3] = -prices[0];

for (int i = 1; i < len; i++) {
dp[i][1] = Math.max(dp[i - 1][1], -prices[i]);
dp[i][2] = Math.max(dp[i - 1][2], dp[i - 1][1] + prices[i]);
dp[i][3] = Math.max(dp[i - 1][3], dp[i - 1][2] - prices[i]);
dp[i][4] = Math.max(dp[i - 1][4], dp[i - 1][3] + prices[i]);
}

return dp[len - 1][4];
}
}

28、买卖股票的最佳时机4

188. 买卖股票的最佳时机 IV - 力扣(LeetCode)

给你一个整数数组 prices 和一个整数 k ,其中 prices[i] 是某支给定的股票在第 i 天的价格。

设计一个算法来计算你所能获取的最大利润。你最多可以完成 k 笔交易。也就是说,你最多可以买 k 次,卖 k 次。

注意:你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。

示例 1:

1
2
3
输入:k = 2, prices = [2,4,1]
输出:2
解释:在第 1 天 (股票价格 = 2) 的时候买入,在第 2 天 (股票价格 = 4) 的时候卖出,这笔交易所能获得利润 = 4-2 = 2 。

示例 2:

1
2
3
4
输入:k = 2, prices = [3,2,6,5,0,3]
输出:7
解释:在第 2 天 (股票价格 = 2) 的时候买入,在第 3 天 (股票价格 = 6) 的时候卖出, 这笔交易所能获得利润 = 6-2 = 4 。
随后,在第 5 天 (股票价格 = 0) 的时候买入,在第 6 天 (股票价格 = 3) 的时候卖出, 这笔交易所能获得利润 = 3-0 = 3 。

提示:

  • 1 <= k <= 100
  • 1 <= prices.length <= 1000
  • 0 <= prices[i] <= 1000

思路

这里比上面更难了,这里要求至多k次交易

dp五部曲

1、确定dp数组以及下标的含义

我们是定义了一个二维dp数组,本题依然可以用一个二维dp数组

使用二维数组dp[i][j]: 第 i 天状态为 j ,所剩下的最大现金是dp[i][j]

j 的 状态表示为:

  • 0 表示不操作
  • 1 第一次买入
  • 2 第一次卖出
  • 3 第二次买入
  • 4 第二次卖出
  • …..

大家应该发现规律了吧 ,除了0以外,偶数就是卖出,奇数就是买入。

题目要求是至多有K笔交易,那么j的范围就定义为 2 * k + 1 就可以。

2、确定递推公式

还要强调一下:dp[i][1],表示的是第i天,买入股票的状态,并不是说一定要第i天买入股票,这是很多同学容易陷入的误区。

达到dp[i][1]状态,有两个具体操作:

  • 操作一:第i天买入股票了,那么dp[i][1] = dp[i - 1][0] - prices[i]
  • 操作二:第i天没有操作,而是沿用前一天买入的状态,即:dp[i][1] = dp[i - 1][1]

选最大的,所以 dp[i][1] = max(dp[i - 1][0] - prices[i], dp[i - 1][1]);

同理dp[i][2]也有两个操作:

  • 操作一:第i天卖出股票了,那么dp[i][2] = dp[i - 1][1] + prices[i]
  • 操作二:第i天没有操作,沿用前一天卖出股票的状态,即:dp[i][2] = dp[i - 1][2]

所以dp[i][2] = max(dp[i - 1][1] + prices[i], dp[i - 1][2])

同理可以类比剩下的状态,代码如下:

1
2
3
4
for (int j = 0; j < 2 * k - 1; j += 2) {
dp[i][j + 1] = max(dp[i - 1][j + 1], dp[i - 1][j] - prices[i]);
dp[i][j + 2] = max(dp[i - 1][j + 2], dp[i - 1][j + 1] + prices[i]);
}

本题和动态规划:123.买卖股票的最佳时机III (opens new window)最大的区别就是这里要类比j为奇数是买,偶数是卖的状态。

  1. dp数组如何初始化

第0天没有操作,这个最容易想到,就是0,即:dp[0][0] = 0;

第0天做第一次买入的操作,dp[0][1] = -prices[0];

第0天做第一次卖出的操作,这个初始值应该是多少呢?

此时还没有买入,怎么就卖出呢? 其实大家可以理解当天买入,当天卖出,所以dp[0][2] = 0;

第0天第二次买入操作,初始值应该是多少呢?应该不少同学疑惑,第一次还没买入呢,怎么初始化第二次买入呢?

第二次买入依赖于第一次卖出的状态,其实相当于第0天第一次买入了,第一次卖出了,然后在买入一次(第二次买入),那么现在手头上没有现金,只要买入,现金就做相应的减少。

所以第二次买入操作,初始化为:dp[0][3] = -prices[0];

第二次卖出初始化dp[0][4] = 0;

所以同理可以推出dp[0][j]当j为奇数的时候都初始化为 -prices[0]

代码如下:

1
2
3
for (int j = 1; j < 2 * k; j += 2) {
dp[0][j] = -prices[0];
}

在初始化的地方同样要类比j为偶数是卖、奇数是买的状态。

  1. 确定遍历顺序

从递归公式其实已经可以看出,一定是从前向后遍历,因为dp[i],依靠dp[i - 1]的数值。

  1. 举例推导dp数组

以输入[1,2,3,4,5],k=2为例。

188.买卖股票的最佳时机IV

最后一次卖出,一定是利润最大的,`dp[prices.size() - 1][2 * k]即红色部分就是最后求解。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
// 版本一: 三维 dp数组
class Solution {
public int maxProfit(int k, int[] prices) {
if (prices.length == 0) return 0;

// [天数][交易次数][是否持有股票]
int len = prices.length;
int[][][] dp = new int[len][k + 1][2];

// dp数组初始化
// 初始化所有的交易次数是为确保 最后结果是最多 k 次买卖的最大利润
for (int i = 0; i <= k; i++) {
dp[0][i][1] = -prices[0];
}

for (int i = 1; i < len; i++) {
for (int j = 1; j <= k; j++) {
// dp方程, 0表示不持有/卖出, 1表示持有/买入
dp[i][j][0] = Math.max(dp[i - 1][j][0], dp[i - 1][j][1] + prices[i]);
dp[i][j][1] = Math.max(dp[i - 1][j][1], dp[i - 1][j - 1][0] - prices[i]);
}
}
return dp[len - 1][k][0];
}
}

// 版本二: 二维 dp数组
class Solution {
public int maxProfit(int k, int[] prices) {
if (prices.length == 0) return 0;

// [天数][股票状态]
// 股票状态: 奇数表示第 k 次交易持有/买入, 偶数表示第 k 次交易不持有/卖出, 0 表示没有操作
int len = prices.length;
int[][] dp = new int[len][k*2 + 1];

// dp数组的初始化, 与版本一同理
for (int i = 1; i < k*2; i += 2) {
dp[0][i] = -prices[0];
}

for (int i = 1; i < len; i++) {
for (int j = 0; j < k*2 - 1; j += 2) {
dp[i][j + 1] = Math.max(dp[i - 1][j + 1], dp[i - 1][j] - prices[i]);
dp[i][j + 2] = Math.max(dp[i - 1][j + 2], dp[i - 1][j + 1] + prices[i]);
}
}
return dp[len - 1][k*2];
}
}

29、买卖股票时机含冷冻期

309. 买卖股票的最佳时机含冷冻期 - 力扣(LeetCode)

给定一个整数数组,其中第 i 个元素代表了第 i 天的股票价格 。

设计一个算法计算出最大利润。在满足以下约束条件下,你可以尽可能地完成更多的交易(多次买卖一支股票):

  • 你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。
  • 卖出股票后,你无法在第二天买入股票 (即冷冻期为 1 天)。

示例:

  • 输入: [1,2,3,0,2]
  • 输出: 3
  • 解释: 对应的交易状态为: [买入, 卖出, 冷冻期, 买入, 卖出]

思路

1、dp数组以及下标的含义

dp[i][j],第 i 天状态为 j ,所剩的最多现金为dp[i][j]

具体可以分出如下四个状态:

  • 状态一:持有股票状态(今天买入股票,或者是之前就买入了股票然后没有操作,一直持有)
  • 不持有股票状态,这里就有两种卖出股票状态
    • 状态二:保持卖出股票的状态(两天前就卖出了股票,度过一天冷冻期。或者是前一天就是卖出股票状态,一直没操作)
    • 状态三:今天卖出股票
  • 状态四:今天为冷冻状态,但冷冻状态不可持续,只有一天。

    img

j的状态为:

  • 0:状态一
  • 1:状态二
  • 2:状态三
  • 3:状态四

很多题解为什么讲的比较模糊,是因为把这四个状态合并成三个状态了,其实就是把状态二和状态四合并在一起了。

从代码上来看确实可以合并,但从逻辑上分析合并之后就很难理解了,所以我下面的讲解是按照这四个状态来的,把每一个状态分析清楚。

如果大家按照代码随想录顺序来刷的话,会发现 买卖股票最佳时机 1,2,3,4 的题目讲解中

「今天卖出股票」我是没有单独列出一个状态的归类为「不持有股票的状态」,而本题为什么要单独列出「今天卖出股票」 一个状态呢?

因为本题我们有冷冻期,而冷冻期的前一天,只能是 「今天卖出股票」状态,如果是 「不持有股票状态」那么就很模糊,因为不一定是 卖出股票的操作。

如果没有按照 代码随想录 顺序去刷的录友,可能看这里的讲解 会有点困惑,建议把代码随想录本篇之前股票内容的讲解都看一下,领会一下每天 状态的设置。

注意这里的每一个状态,例如状态一,是持有股票股票状态并不是说今天一定就买入股票,而是说保持买入股票的状态即:可能是前几天买入的,之后一直没操作,所以保持买入股票的状态。

  1. 确定递推公式

达到买入股票状态(状态一)即:dp[i][0],有两个具体操作:

  • 操作一:前一天就是持有股票状态(状态一),dp[i][0] = dp[i - 1][0]
  • 操作二:今天买入了,有两种情况
    • 前一天是冷冻期(状态四),dp[i - 1][3] - prices[i]
    • 前一天是保持卖出股票的状态(状态二),dp[i - 1][1] - prices[i]

那么dp[i][0] = max(dp[i - 1][0], dp[i - 1][3] - prices[i], dp[i - 1][1] - prices[i]);

达到保持卖出股票状态(状态二)即:dp[i][1],有两个具体操作:

  • 操作一:前一天就是状态二
  • 操作二:前一天是冷冻期(状态四)

dp[i][1] = max(dp[i - 1][1], dp[i - 1][3]);

达到今天就卖出股票状态(状态三),即:dp[i][2] ,只有一个操作:

昨天一定是持有股票状态(状态一),今天卖出

即:dp[i][2] = dp[i - 1][0] + prices[i];

达到冷冻期状态(状态四),即:dp[i][3],只有一个操作:

昨天卖出了股票(状态三)

dp[i][3] = dp[i - 1][2];

综上分析,递推代码如下:

1
2
3
4
dp[i][0] = max(dp[i - 1][0], max(dp[i - 1][3], dp[i - 1][1]) - prices[i]);
dp[i][1] = max(dp[i - 1][1], dp[i - 1][3]);
dp[i][2] = dp[i - 1][0] + prices[i];
dp[i][3] = dp[i - 1][2];
  1. dp数组如何初始化

这里主要讨论一下第0天如何初始化。

如果是持有股票状态(状态一)那么:dp[0][0] = -prices[0],一定是当天买入股票。

保持卖出股票状态(状态二),这里其实从 「状态二」的定义来说 ,很难明确应该初始多少,这种情况我们就看递推公式需要我们给他初始成什么数值。

如果i为1,第1天买入股票,那么递归公式中需要计算 dp[i - 1][1] - prices[i],即 dp[0][1] - prices[1],那么大家感受一下 dp[0][1](即第0天的状态二)应该初始成多少,只能初始为0。想一想如果初始为其他数值,是我们第1天买入股票后 手里还剩的现金数量是不是就不对了。

今天卖出了股票(状态三),同上分析,dp[0][2]初始化为0,dp[0][3]也初始为0。

  1. 确定遍历顺序

从递归公式上可以看出,dp[i] 依赖于 dp[i-1],所以是从前向后遍历。

  1. 举例推导dp数组

以 [1,2,3,0,2] 为例,dp数组如下:

309.最佳买卖股票时机含冷冻期

最后结果是取 状态二,状态三,和状态四的最大值,不少同学会把状态四忘了,状态四是冷冻期,最后一天如果是冷冻期也可能是最大值

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public int maxProfit(int[] prices) {
if (prices == null || prices.length < 2) {
return 0;
}
int[][] dp = new int[prices.length][2];

// bad case
dp[0][0] = 0;
dp[0][1] = -prices[0];
dp[1][0] = Math.max(dp[0][0], dp[0][1] + prices[1]);
dp[1][1] = Math.max(dp[0][1], -prices[1]);

for (int i = 2; i < prices.length; i++) {
// dp公式
dp[i][0] = Math.max(dp[i - 1][0], dp[i - 1][1] + prices[i]);
dp[i][1] = Math.max(dp[i - 1][1], dp[i - 2][0] - prices[i]);
}

return dp[prices.length - 1][0];
}
}

30、买卖股票的最佳时机含手续费

714. 买卖股票的最佳时机含手续费 - 力扣(LeetCode)

给定一个整数数组 prices,其中第 i 个元素代表了第 i 天的股票价格 ;非负整数 fee 代表了交易股票的手续费用。

你可以无限次地完成交易,但是你每笔交易都需要付手续费。如果你已经购买了一个股票,在卖出它之前你就不能再继续购买股票了。

返回获得利润的最大值。

注意:这里的一笔交易指买入持有并卖出股票的整个过程,每笔交易你只需要为支付一次手续费。

示例 1:

  • 输入: prices = [1, 3, 2, 8, 4, 9], fee = 2
  • 输出: 8

解释: 能够达到的最大利润:

  • 在此处买入 prices[0] = 1
  • 在此处卖出 prices[3] = 8
  • 在此处买入 prices[4] = 4
  • 在此处卖出 prices[5] = 9
  • 总利润: ((8 - 1) - 2) + ((9 - 4) - 2) = 8.

注意:

  • 0 < prices.length <= 50000.
  • 0 < prices[i] < 50000.
  • 0 <= fee < 50000

思路

相对于动态规划:122.买卖股票的最佳时机II (opens new window),本题只需要在计算卖出操作的时候减去手续费就可以了,代码几乎是一样的。

唯一差别在于递推公式部分,所以本篇也就不按照动规五部曲详细讲解了,主要讲解一下递推公式部分。

这里重申一下dp数组的含义:

dp[i][0]表示第i天持有股票所得最多现金。 dp[i][1] 表示第i天不持有股票所得最多现金

如果第i天持有股票即dp[i][0], 那么可以由两个状态推出来

  • 第i-1天就持有股票,那么就保持现状,所得现金就是昨天持有股票的所得现金 即:dp[i - 1][0]
  • 第i天买入股票,所得现金就是昨天不持有股票的所得现金减去 今天的股票价格 即:dp[i - 1][1] - prices[i]

所以:dp[i][0] = max(dp[i - 1][0], dp[i - 1][1] - prices[i]);

在来看看如果第i天不持有股票即dp[i][1]的情况, 依然可以由两个状态推出来

  • 第i-1天就不持有股票,那么就保持现状,所得现金就是昨天不持有股票的所得现金 即:dp[i - 1][1]
  • 第i天卖出股票,所得现金就是按照今天股票价格卖出后所得现金,注意这里需要有手续费了即:`dp[i - 1][0] + prices[i] - fee

所以:dp[i][1] = max(dp[i - 1][1], dp[i - 1][0] + prices[i] - fee);

本题和动态规划:122.买卖股票的最佳时机II (opens new window)的区别就是这里需要多一个减去手续费的操作。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
/**
* 卖出时支付手续费
* @param prices
* @param fee
* @return
*/
public int maxProfit(int[] prices, int fee) {
int len = prices.length;
// 0 : 持股(买入)
// 1 : 不持股(售出)
// dp 定义第i天持股/不持股 所得最多现金
int[][] dp = new int[len][2];
dp[0][0] = -prices[0];
for (int i = 1; i < len; i++) {
dp[i][0] = Math.max(dp[i - 1][0], dp[i - 1][1] - prices[i]);
dp[i][1] = Math.max(dp[i - 1][0] + prices[i] - fee, dp[i - 1][1]);
}
return Math.max(dp[len - 1][0], dp[len - 1][1]);
}

31、最长递增子序列

300. 最长递增子序列 - 力扣(LeetCode)

给你一个整数数组 nums ,找到其中最长严格递增子序列的长度。

子序列是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7] 是数组 [0,3,1,6,2,2,7] 的子序列。

示例 1:

  • 输入:nums = [10,9,2,5,3,7,101,18]
  • 输出:4
  • 解释:最长递增子序列是 [2,3,7,101],因此长度为 4 。

示例 2:

  • 输入:nums = [0,1,0,3,2,3]
  • 输出:4

示例 3:

  • 输入:nums = [7,7,7,7,7,7,7]
  • 输出:1

提示:

  • 1 <= nums.length <= 2500
  • -10^4 <= nums[i] <= 104

思路

首先通过本题大家要明确什么是子序列,“子序列是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。”

子序列问题是动态规划解决的经典问题 当前下标 i 的递增子序列长度,其实和 i 之前的下标 j 的子序列长度有关系,那又是什么样的关系呢。

接下来,我们依然用动规五部曲来详细分析一下:

1、dp[i]的定义

本题中,定义dp数组的含义十分重要

dp[i]表示 i 之前包括 i 的以nums[i]结尾的最长递增子序列的长度

为什么一定表示以nums[i]结尾的最长递增子序列,因为我们在做 递增比较的时候,如果比较nums[j]和nums[i]的大小,那么两个递增子序列一定分别以nums[j]结尾和nums[i]为结尾, 要不然这个比较就没有意义了,不是尾部元素的比较那么 如何算递增呢。

2、 状态转移方程

位置i的最长升序子序列等于j从0到i-1各个位置的最长升序子序列 + 1 的最大值。

所以:if (nums[i] > nums[j]) dp[i] = max(dp[i], dp[j] + 1);

注意这里不是要dp[i] 与 dp[j] + 1进行比较,而是我们要取dp[j] + 1的最大值。

3、dp[i]的初始化

每一个i,对应的dp[i](即最长递增子序列)起始大小至少都是1.

4、确定遍历顺序

dp[i] 是有0到i-1各个位置的最长递增子序列 推导而来,那么遍历i一定是从前向后遍历。

j其实就是遍历0到i-1,那么是从前到后,还是从后到前遍历都无所谓,只要吧 0 到 i-1 的元素都遍历了就行了。 所以默认习惯 从前向后遍历。

遍历i的循环在外层,遍历j则在内层,代码如下:

1
2
3
4
5
6
for (int i = 1; i < nums.size(); i++) {
for (int j = 0; j < i; j++) {
if (nums[i] > nums[j]) dp[i] = max(dp[i], dp[j] + 1);
}
if (dp[i] > result) result = dp[i]; // 取长的子序列
}

5、举例推导dp数组

输入:[0,1,0,3,2],dp数组的变化如下:

300.最长上升子序列

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public int lengthOfLIS(int[] nums) {
if (nums.length <= 1) return nums.length;
int[] dp = new int[nums.length];
int res = 1;
Arrays.fill(dp, 1);
for (int i = 1; i < dp.length; i++) {
for (int j = 0; j < i; j++) {
if (nums[i] > nums[j]) {
dp[i] = Math.max(dp[i], dp[j] + 1);
}
}
res = Math.max(res, dp[i]);
}
return res;
}
}

32、最长连续递增序列

674. 最长连续递增序列 - 力扣(LeetCode)

给定一个未经排序的整数数组,找到最长且 连续递增的子序列,并返回该序列的长度。

连续递增的子序列 可以由两个下标 l 和 r(l < r)确定,如果对于每个 l <= i < r,都有 nums[i] < nums[i + 1] ,那么子序列 [nums[l], nums[l + 1], …, nums[r - 1], nums[r]] 就是连续递增子序列。

示例 1:

  • 输入:nums = [1,3,5,4,7]
  • 输出:3
  • 解释:最长连续递增序列是 [1,3,5], 长度为3。尽管 [1,3,5,7] 也是升序的子序列, 但它不是连续的,因为 5 和 7 在原数组里被 4 隔开。

示例 2:

  • 输入:nums = [2,2,2,2,2]
  • 输出:1
  • 解释:最长连续递增序列是 [2], 长度为1。

提示:

  • 0 <= nums.length <= 10^4
  • -10^9 <= nums[i] <= 10^9

思路

dp五部曲

1、确定dp数组以及下标的含义

dp[i]:以下标i为结尾的连续递增的子序列长度为dp[i]。

注意这里的定义,一定是以下标i为结尾,并不是说一定以下标0为起始位置。

2、确定递推公式

如果nums[i] > nums[i - 1],那么以 i 为结尾的连续递增的子序列长度一定等于 以 i - 1为结尾的连续递增的子序列长度 + 1

即:dp[i] = dp[i - 1] + 1;

因为本题要求连续递增子序列,所以就只要比较nums[i]与nums[i - 1],而不用去比较nums[j]与nums[i] (j是在0到i之间遍历)。

既然不用j了,那么也不用两层for循环,本题一层for循环就行,比较nums[i] 和 nums[i - 1]。

3、dp数组如何初始化

以下标i为结尾的连续递增的子序列长度最少也应该是1,即就是nums[i]这一个元素。

所以dp[i]应该初始1;

4、确定遍历顺序

从前向后遍历

1
2
3
4
5
for (int i = 1; i < nums.size(); i++) {
if (nums[i] > nums[i - 1]) { // 连续记录
dp[i] = dp[i - 1] + 1;
}
}

5、举例推导dp数组

已输入nums = [1,3,5,4,7]为例,dp数组状态如下:

674.最长连续递增序列

注意这里要取dp[i]里的最大值,所以dp[2]才是结果!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public static int findLengthOfLCIS(int[] nums) {
int[] dp = new int[nums.length];
for (int i = 0; i < dp.length; i++) {
dp[i] = 1;
}
int res = 1;
//可以注意到,這邊的 i 是從 0 開始,所以會出現和卡哥的C++ code有差異的地方,在一些地方會看到有 i + 1 的偏移。
for (int i = 0; i < nums.length - 1; i++) {
if (nums[i + 1] > nums[i]) {
dp[i + 1] = dp[i] + 1;
}
res = res > dp[i + 1] ? res : dp[i + 1];
}
return res;
}
}

33、最长重复子数组

718. 最长重复子数组 - 力扣(LeetCode)

给两个整数数组 nums1 和 nums2 ,返回 两个数组中 公共的 、长度最长的子数组的长度 。

示例 1:

1
2
3
输入:nums1 = [1,2,3,2,1], nums2 = [3,2,1,4,7]
输出:3
解释:长度最长的公共子数组是 [3,2,1] 。

示例 2:

1
2
输入:nums1 = [0,0,0,0,0], nums2 = [0,0,0,0,0]
输出:5

提示:

  • 1 <= nums1.length, nums2.length <= 1000
  • 0 <= nums1[i], nums2[i] <= 100

思路

要求两个数组中最长重复子数组,如果是暴力的解法,只需要先两层for循环确定两个数组起始位置,然后 再来一个循环可以是for或者while,两个从位置开始比较,取得重复子数组的长度。

本题其实是动规解决的经典题目,要想到用二维数组可以记录两个字符串的所有比较情况,这样就比较好推递推公式了。

1、确定dp数组以及下标的含义

dp[i][j]:以下标i - 1 为结尾的A,和以下标j - 1 为结尾大的B,最长重复子数组长度为dp[i][j]。

那么dp[0][0]是什么含义呢?总不能是以下标-1为结尾的A数组吧

其实这个定义决定,在遍历dp数组的时候 i 和 j 都要从1 开始。

2、确定递推公式

根据dp[i][j]的定义,dp[i][j]的状态只能由dp[i - 1][j - 1]推导出来。

即当A[i - 1] 和B[j - 1]相等的时候,dp[i][j] = dp[i - 1][j - 1] + 1;

根据递推公式可以看出,遍历i 和 j 要从1开始!

3、dp数组如何初始化

根据dp[i][j]的定义,dp[i][0] 和dp[0][j]其实都是没有意义的!

但dp[i][0] 和dp[0][j]要初始值,因为 为了方便递归公式dp[i][j] = dp[i - 1][j - 1] + 1;

所以dp[i][0] 和dp[0][j]初始化为0。

举个例子A[0]如果和B[0]相同的话,dp[1][1] = dp[0][0] + 1,只有dp[0][0]初始为0,正好符合递推公式逐步累加起来。

4、确定遍历顺序

外层for循环遍历A,内层for循环遍历B。

那又有同学问了,外层for循环遍历B,内层for循环遍历A。不行么?

也行,一样的,我这里就用外层for循环遍历A,内层for循环遍历B了。

同时题目要求长度最长的子数组的长度。所以在遍历的时候顺便把dp[i][j]的最大值记录下来。

代码如下:

1
2
3
4
5
6
7
8
for (int i = 1; i <= nums1.size(); i++) {
for (int j = 1; j <= nums2.size(); j++) {
if (nums1[i - 1] == nums2[j - 1]) {
dp[i][j] = dp[i - 1][j - 1] + 1;
}
if (dp[i][j] > result) result = dp[i][j];
}
}
  1. 举例推导dp数组

拿示例1中,A: [1,2,3,2,1],B: [3,2,1,4,7]为例,画一个dp数组的状态变化,如下:

718.最长重复子数组

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Solution {
public int findLength(int[] nums1, int[] nums2) {
int result = 0;
int[][] dp = new int[nums1.length + 1][nums2.length + 1];

for (int i = 1; i < nums1.length + 1; i++) {
for (int j = 1; j < nums2.length + 1; j++) {
if (nums1[i - 1] == nums2[j - 1]) {
dp[i][j] = dp[i - 1][j - 1] + 1;
result = Math.max(result, dp[i][j]);
}
}
}

return result;
}
}

34、最长公共子序列

1143. 最长公共子序列 - 力扣(LeetCode)

给定两个字符串 text1 和 text2,返回这两个字符串的最长 公共子序列 的长度。如果不存在 公共子序列 ,返回 0 。

一个字符串的 子序列 是指这样一个新的字符串:它是由原字符串在不改变字符的相对顺序的情况下删除某些字符(也可以不删除任何字符)后组成的新字符串。

  • 例如,"ace" 是 "abcde" 的子序列,但 "aec" 不是 "abcde" 的子序列。

两个字符串的 公共子序列 是这两个字符串所共同拥有的子序列。

示例 1:

1
2
3
输入:text1 = "abcde", text2 = "ace" 
输出:3
解释:最长公共子序列是 "ace" ,它的长度为 3 。

示例 2:

1
2
3
输入:text1 = "abc", text2 = "abc"
输出:3
解释:最长公共子序列是 "abc" ,它的长度为 3 。

示例 3:

1
2
3
输入:text1 = "abc", text2 = "def"
输出:0
解释:两个字符串没有公共子序列,返回 0 。

提示:

  • 1 <= text1.length, text2.length <= 1000
  • text1 和 text2 仅由小写英文字符组成。

思路

这题跟上题区别是相对顺序,不是子序列

动规五部曲

1、确定dp数组以及下标的含义

dp[i][j]:长度为[0, i - 1]的字符串text1与长度为[0,j - 1]的字符串text2的最长公共子序列为dp[i][j]

2、确定递推公式

主要就是两大情况:text1[i - 1]与text2[j - 1]相同,text1[i - 1]与text2[j - 1]不相同

如果相同,那么找到了一个公共元素,所以dp[i][j] = dp[i - 1][j - 1] + 1

如果不相同,那么就看看text1[0 , i - 2]与text2[0 , j - 1]的最长公共子序列和text1[0 , i - 1]和text2[0 , j - 2] 的最长公共子序列,取最大的。

相当于在说:“既然最后一个字符不匹配,那我看看少一个字符的情况,哪个能给我更长的公共子序列?”

举个例子

  • dp[1][2]:"a" 和 "ae" 的 LCS → 是 1(”a”)
  • dp[2][1]:"ab" 和 "a" 的 LCS → 是 1(”a”)

取最大值 → dp[2][2] = 1

即:dp[i][j] = Math.max(dp[i - 1][j], dp[i][j - 1]);

代码如下:

1
2
3
4
5
if(text1[i - 1] == text2[ j - 1]){
dp[i][j] = dp[i - 1][j - 1] + 1;
}else{
dp[i][j] = Math.max(dp[i - 1][j],dp[i][j - 1]);
}

3、dp数组如何初始化

先看看dp[i] [0] 应该是多少呢?

text1[0, i -1]和空串的LCS = 0 所以dp[i][0] = 0

同理dp[0][j] = 0

4、确定遍历顺序

从递推公式可以看出,有三个方向可以推出dp,如图:

1143.最长公共子序列

那么为了递推的过程中,这三个方向都是经过计算的数值,所以要从前向后,从上到下来遍历这个矩阵

  1. 举例推导dp数组

以输入:text1 = “abcde”, text2 = “ace” 为例,dp状态如图:

1143.最长公共子序列1

最后红框dp[text1.size()][text2.size()]为最终结果

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public int longestCommonSubsequence(String text1, String text2) {
if (text1 == null || text2 == null || text1.length() == 0 || text2.length() == 0) {
return 0;
}

int len1 = text1.length();
int len2 = text2.length();

// dp[i][j] 表示 text1 的前 i 个字符 和 text2 的前 j 个字符 的 LCS 长度
int[][] dp = new int[len1 + 1][len2 + 1];

// 从 1 开始,因为 dp[0][*] 和 dp[*][0] 是边界(空字符串)
for (int i = 1; i <= len1; i++) {
for (int j = 1; j <= len2; j++) {
if (text1.charAt(i - 1) == text2.charAt(j - 1)) {
// 字符相同:LCS = 前面的 LCS + 1
dp[i][j] = dp[i - 1][j - 1] + 1;
} else {
// 字符不同:取“少一个字符”的最大值
dp[i][j] = Math.max(dp[i - 1][j], dp[i][j - 1]);
}
}
}

return dp[len1][len2];
}
}

35、不相交的线

1035. 不相交的线 - 力扣(LeetCode)

在两条独立的水平线上按给定的顺序写下 nums1 和 nums2 中的整数。

现在,可以绘制一些连接两个数字 nums1[i] 和 nums2[j] 的直线,这些直线需要同时满足:

  • nums1[i] == nums2[j]
  • 且绘制的直线不与任何其他连线(非水平线)相交。

请注意,连线即使在端点也不能相交:每个数字只能属于一条连线。

以这种方法绘制线条,并返回可以绘制的最大连线数。

示例 1:

img

1
2
3
4
输入:nums1 = [1,4,2], nums2 = [1,2,4]
输出:2
解释:可以画出两条不交叉的线,如上图所示。
但无法画出第三条不相交的直线,因为从 nums1[1]=4 到 nums2[2]=4 的直线将与从 nums1[2]=2 到 nums2[1]=2 的直线相交。

示例 2:

1
2
输入:nums1 = [2,5,1,2,5], nums2 = [10,5,2,1,5,2]
输出:3

示例 3:

1
2
输入:nums1 = [1,3,7,1,7,5], nums2 = [1,9,2,5,1]
输出:2

提示:

  • 1 <= nums1.length, nums2.length <= 500
  • 1 <= nums1[i], nums2[j] <= 2000

思路

直线不能相交,这就说明在字符串Nums1中找到一个字符串num2相同的子序列,且这个子序列不能改变相对顺序,只要相对顺序不改变,连接相同数字的直线就不会相交。

其实也就是说nums1和nums2的最长公共子序列是1,4,也就是求两个字符串的最长公共子序列的长度。所以跟上题是一样的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {
public int maxUncrossedLines(int[] nums1, int[] nums2) {

if(nums1 == null || nums2 == null){
return 0;
}
int len1 = nums1.length;
int len2 = nums2.length;

int[][] dp = new int[len1 + 1][len2 + 1];

for(int i = 1; i <= len1 ; i++){
for(int j = 1 ; j <= len2 ; j++){
if(nums1[i - 1] == nums2[j - 1]){
dp[i][j] = dp[i - 1][j - 1] + 1;
}else{
dp[i][j] = Math.max(dp[i - 1][j],dp[i][j - 1]);
}
}
}
return dp[len1][len2];
}
}

36、最大子序和

53. 最大子数组和 - 力扣(LeetCode)

给你一个整数数组 nums ,请你找出一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和。

子数组是数组中的一个连续部分。

示例 1:

1
2
3
输入:nums = [-2,1,-3,4,-1,2,1,-5,4]
输出:6
解释:连续子数组 [4,-1,2,1] 的和最大,为 6 。

示例 2:

1
2
输入:nums = [1]
输出:1

示例 3:

1
2
输入:nums = [5,4,-1,7,8]
输出:23

提示:

  • 1 <= nums.length <= 105
  • -104 <= nums[i] <= 104

思路

dp五部曲

1、确定dp数组下标含义

dp[i] 表示 nums[0 - i -1]最大子数组和

2、确定递推公式

  • dp[i - 1] + nums[i],即:nums[i]加入当前连续子序列和
  • nums[i],即:从头开始计算当前连续子序列和

一定是取最大的,所以dp[i] = max(dp[i - 1] + nums[i], nums[i]);

3、确定遍历顺序

肯定是从前往后

4、初始化

dp[0] = nums[0]

5、举例推导dp数组

以示例一为例,输入:nums = [-2,1,-3,4,-1,2,1,-5,4],对应的dp状态如下: 53.最大子序和(动态规划)

注意最后的结果可不是dp[nums.size() - 1]! ,而是dp[6]。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Solution {
public static int maxSubArray(int[] nums) {
if (nums.length == 0) {
return 0;
}

int res = nums[0];
int[] dp = new int[nums.length];
dp[0] = nums[0];
for (int i = 1; i < nums.length; i++) {
dp[i] = Math.max(dp[i - 1] + nums[i], nums[i]);
res = res > dp[i] ? res : dp[i];
}
return res;
}
}

37、判断子序列

392. 判断子序列 - 力扣(LeetCode)

给定字符串 s 和 t ,判断 s 是否为 t 的子序列。

字符串的一个子序列是原始字符串删除一些(也可以不删除)字符而不改变剩余字符相对位置形成的新字符串。(例如,"ace"是"abcde"的一个子序列,而"aec"不是)。

进阶:

如果有大量输入的 S,称作 S1, S2, … , Sk 其中 k >= 10亿,你需要依次检查它们是否为 T 的子序列。在这种情况下,你会怎样改变代码?

致谢:

特别感谢 @pbrother 添加此问题并且创建所有测试用例。

示例 1:

1
2
输入:s = "abc", t = "ahbgdc"
输出:true

示例 2:

1
2
输入:s = "axc", t = "ahbgdc"
输出:false

提示:

  • 0 <= s.length <= 100
  • 0 <= t.length <= 10^4
  • 两个字符串都只由小写字符组成。

思路

这套题也可以用双指针的思路来实现,时间复杂度也是On

这道题是 编辑距离的入门题目,因为从题意中我们也可以发现,只需要计算删除的情况,不用考虑增加和替换的情况。

所以掌握本题的动态规划解法是对后面要学的编辑距离的题目打下基础

dp五部曲分析如下

1、确定dp数组以及下标的含义

dp[i][j]表示以下标i - 1为结尾的字符串s , 和以下标j - 1为结尾的字符串 t ,相同子序列的长度为dp[i][j]

注意这里是判断s是否为t的子序列。即 t 的长度是大于等于s的。

2、确定递推公式

在确定递推公式的时候,首先要考虑如何做出如下两种操作,整理如下

  • if (s[i - 1] == t[j - 1])
    • t中找到了一个字符在s中也出现了
  • if (s[i - 1] != t[j - 1])
    • 相当于t要删除元素,继续匹配

if (s[i - 1] == t[j - 1]),那么dp[i][j] = dp[i - 1][j - 1] + 1;,因为找到了一个相同的字符,相同子序列长度自然要在dp[i-1][j-1]的基础上加1

if (s[i - 1] != t[j - 1]),此时相当于t要删除元素,t如果把当前元素t[j - 1]删除,那么`dp[i][j]的数值就是 看s[i - 1]与 t[j - 2]的比较结果了

即dp[i][j] = dp[i][j - 1]

3、dp数组如何初始化

从递推公式可以看出dp[i][j]都是依赖于dp[i - 1][j - 1] 和 dp[i][j - 1],所以dp[0][0]和dp[i][0]是一定要初始化的。

这里大家已经可以发现,在定义dp[i][j]含义的时候为什么要**表示以下标i-1为结尾的字符串s,和以下标j-1为结尾的字符串t,相同子序列的长度为dp[i][j]**。

因为这样的定义在dp二维矩阵中可以留出初始化的区间,如图:

392.判断子序列

如果要是定义的dp[i][j]是以下标i为结尾的字符串s和以下标j为结尾的字符串t,初始化就比较麻烦了。

dp[i][0] 表示以下标i-1为结尾的字符串,与空字符串的相同子序列长度,所以为0. dp[0][j]同理。

4、确定遍历顺序

同理从递推公式可以看出dp[i][j]都是依赖于dp[i - 1][j - 1] 和 dp[i][j - 1],那么遍历顺序也应该是从上到下,从左到右

如图所示:

392.判断子序列1

  1. 举例推导dp数组

以示例一为例,输入:s = “abc”, t = “ahbgdc”,dp状态转移图如下:

392.判断子序列2

dp[i][j]表示以下标i-1为结尾的字符串s和以下标j-1为结尾的字符串t 相同子序列的长度,所以如果`dp[s.size()][t.size()]与 字符串s的长度相同说明:s与t的最长相同子序列就是s,那么s 就是 t 的子序列。

图中`dp[s.size()][t.size()] = 3, 而s.size() 也为3。所以s是t 的子序列,返回true。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public boolean isSubsequence(String s, String t) {
int length1 = s.length(); int length2 = t.length();
int[][] dp = new int[length1+1][length2+1];
for(int i = 1; i <= length1; i++){
for(int j = 1; j <= length2; j++){
if(s.charAt(i-1) == t.charAt(j-1)){
dp[i][j] = dp[i-1][j-1] + 1;
}else{
dp[i][j] = dp[i][j-1];
}
}
}
if(dp[length1][length2] == length1){
return true;
}else{
return false;
}
}
}

38、不同的子序列

115. 不同的子序列 - 力扣(LeetCode)

给你两个字符串 s 和 t ,统计并返回在 s 的 子序列 中 t 出现的个数。

测试用例保证结果在 32 位有符号整数范围内。

示例 1:

1
2
3
4
5
6
7
输入:s = "rabbbit", t = "rabbit"
输出:3
解释:
如下所示, 有 3 种可以从 s 中得到 "rabbit" 的方案。
rabbbit
rabbbit
rabbbit

示例 2:

1
2
3
4
5
6
7
8
9
输入:s = "babgbag", t = "bag"
输出:5
解释:
如下所示, 有 5 种可以从 s 中得到 "bag" 的方案。
babgbag
babgbag
babgbag
babgbag
babgbag

提示:

  • 1 <= s.length, t.length <= 1000
  • s 和 t 由英文字母组成

思路

这道题目如果不是子序列,而是要求连续序列的,那就可以考虑用KMP。

这道题目相对于72.编辑距离,简单了不少,因为本题相当于只有删除操作,不用考虑替换增加之类的。

但相对于上一题有难度了,这道题目双指针法做不了,开始dp五部曲。

1、确定dp数组以及下标的含义

dp[i][j]:以i - 1为结尾的s子序列中出现以j - 1为结尾的t的个数为dp[i][j]

2、确定递推公式

这一类问题,基本是要分析两种情况

  • s[i - 1] 与 t[j - 1]相等
  • s[i - 1] 与 t[j - 1] 不相等

当s[i - 1] 与 t[j - 1]相等时,dp[i][j]可以有两部分组成。

一部分是用s[i - 1]来匹配,那么个数为dp[i - 1][j - 1]。

即不需要考虑当前s子串和t子串的最后一位字母,所以只需要 dp[i-1][j-1]。

一部分是不用s[i - 1]来匹配,个数为dp[i - 1][j]

为什么还要考虑不用s[i - 1]来匹配

例如: s:bagg 和 t:bag ,s[3] 和 t[2]是相同的,但是字符串s也可以不用s[3]来匹配,即用s[0]s[1]s[2]组成的bag。

当然也可以用s[3]来匹配,即:s[0]s[1]s[3]组成的bag。

所以当s[i - 1] 与 t[j - 1]相等时,dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j];

当s[i - 1] 与 t[j - 1]不相等时,dp[i][j]只有一部分组成,不用s[i - 1]来匹配(就是模拟在s中删除这个元素),即:`dp[i - 1][j]

所以将两种情况加起来就是最终的递推公式

所以递推公式为:dp[i][j] = dp[i - 1][j];

这里可能有录友还疑惑,为什么只考虑 “不用s[i - 1]来匹配” 这种情况, 不考虑 “不用t[j - 1]来匹配” 的情况呢。

这里大家要明确,我们求的是 s 中有多少个 t,而不是 求t中有多少个s,所以只考虑 s中删除元素的情况,即 不用s[i - 1]来匹配 的情况。

  1. dp数组如何初始化

从递推公式dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j]; 和 dp[i][j] = dp[i - 1][j]; 中可以看出 dp[i][j]是从上方和左上方推导而来,如图:,那么 dp[i][0] 和dp[0][j]是一定要初始化的。

img

每次当初始化的时候,都要回顾一下dp[i][j]的定义,不要凭感觉初始化。

dp[i][0]表示什么呢?

dp[i][0]表示:以i-1为结尾的s可以随便删除元素,出现空字符串的个数。

那么dp[i][0]一定都是1,因为也就是把以i-1为结尾的s,删除所有元素,出现空字符串的个数就是1。

再来看dp[0][j],dp[0][j]:空字符串s可以随便删除元素,出现以j-1为结尾的字符串t的个数。

那么`dp[0][j]一定都是0,s如论如何也变成不了t。

最后就要看一个特殊位置了,即:`dp[0][0]应该是多少。

dp[0][0]应该是1,空字符串s,可以删除0个元素,变成空字符串t。

初始化分析完毕,代码如下:

1
2
3
vector<vector<long long>> dp(s.size() + 1, vector<long long>(t.size() + 1));
for (int i = 0; i <= s.size(); i++) dp[i][0] = 1;
for (int j = 1; j <= t.size(); j++) dp[0][j] = 0; // 其实这行代码可以和dp数组初始化的时候放在一起,但我为了凸显初始化的逻辑,所以还是加上了。
  1. 确定遍历顺序

从递推公式`dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j]; 和 dp[i][j] = dp[i - 1][j];中可以看出dp[i][j]都是根据左上方和正上方推出来的。

img

所以遍历的时候一定是从上到下,从左到右,这样保证dp[i][j]可以根据之前计算出来的数值进行计算。

代码如下:

1
2
3
4
5
6
7
8
9
for (int i = 1; i <= s.size(); i++) {
for (int j = 1; j <= t.size(); j++) {
if (s[i - 1] == t[j - 1]) {
dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j];
} else {
dp[i][j] = dp[i - 1][j];
}
}
}
  1. 举例推导dp数组

以s:”baegg”,t:”bag”为例,推导dp数组状态如下:

115.不同的子序列

如果写出来的代码怎么改都通过不了,不妨把dp数组打印出来,看一看,是不是这样的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public int numDistinct(String s, String t) {
int len1 = s.length();
int len2 = t.length();

// dp[i][j]: s 的前 i 个字符中,构成 t 的前 j 个字符的子序列数量
long[][] dp = new long[len1 + 1][len2 + 1];

// 空 t 可以被任何 s 前缀以 1 种方式构成
for (int i = 0; i <= len1; i++) {
dp[i][0] = 1;
}

// 填表
for (int i = 1; i <= len1; i++) {
for (int j = 1; j <= len2; j++) {
if (s.charAt(i - 1) == t.charAt(j - 1)) {
dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j];
} else {
dp[i][j] = dp[i - 1][j];
}
}
}

// 题目保证结果在 int 范围内
return (int) dp[len1][len2];
}
}

39、两个字符串的删除操作

583. 两个字符串的删除操作 - 力扣(LeetCode)

给定两个单词 word1 和 word2 ,返回使得 word1 和 word2 相同所需的最小步数。

每步 可以删除任意一个字符串中的一个字符。

示例 1:

1
2
3
输入: word1 = "sea", word2 = "eat"
输出: 2
解释: 第一步将 "sea" 变为 "ea" ,第二步将 "eat "变为 "ea"

示例 2:

1
2
输入:word1 = "leetcode", word2 = "etco"
输出:4

提示:

  • 1 <= word1.length, word2.length <= 500
  • word1 和 word2 只包含小写英文字母

思路

动态规划

本题和上题相比,其实就是两个字符串都可以删除,情况虽说复杂一些,但整体思路是不变的。

这次是两个字符串可以互删了,这种题目也知道用动态规划的思路来解,动规五部曲

1、确定dp数组以及下标的含义

dp[i][j]:以i - 1为结尾的字符串word1,和以j - 1为结尾的字符串word2,想要达到相等所需要删除元素的最少次数

2、确定递推公式

  • 当word1[i - 1] 和 word2[ j - 1]相同的时候
  • 当不同的时候

相同的时候

dp[i][j] = dp [i - 1][j - 1]

不同的时候有三种情况

1、删除word1[i - 1] 最少操作次数为dp[i - 1][j] + 1

2、删除word2[j - 1],最少操作次数为dp[i][j - 1] + 1

3、同时删除两个dp[i - 1][j - 1] + 2

那最后是取最小值

因为dp[i][j - 1] + 1 = dp[i - 1][j - 1] + 2

所以递推公式可以简化为dp[i][j] = min(dp[i - 1][j] + 1,dp[i][j - 1] + 1)

3、dp数组如何初始化

很明显dp[i][0] = i因为要让两个字符串相同就要把i全删除

同理dp[0][j] = j

4、确定遍历顺序

遍历一定是从上到下,从左到右的。

5、举例推导dp数组

以word1:”sea”,word2:”eat”为例,推导dp数组状态图如下:

583.两个字符串的删除操作1

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public int numDistinct(String s, String t) {
int len1 = s.length();
int len2 = t.length();

// dp[i][j]: s 的前 i 个字符中,构成 t 的前 j 个字符的子序列数量
long[][] dp = new long[len1 + 1][len2 + 1];

// 空 t 可以被任何 s 前缀以 1 种方式构成
for (int i = 0; i <= len1; i++) {
dp[i][0] = 1;
}

// 填表
for (int i = 1; i <= len1; i++) {
for (int j = 1; j <= len2; j++) {
if (s.charAt(i - 1) == t.charAt(j - 1)) {
dp[i][j] = dp[i - 1][j - 1] + dp[i - 1][j];
} else {
dp[i][j] = dp[i - 1][j];
}
}
}

// 题目保证结果在 int 范围内
return (int) dp[len1][len2];
}
}

40、编辑距离

72. 编辑距离 - 力扣(LeetCode)

给你两个单词 word1 和 word2, 请返回将 word1 转换成 word2 所使用的最少操作数 。

你可以对一个单词进行如下三种操作:

  • 插入一个字符
  • 删除一个字符
  • 替换一个字符

示例 1:

1
2
3
4
5
6
输入:word1 = "horse", word2 = "ros"
输出:3
解释:
horse -> rorse (将 'h' 替换为 'r')
rorse -> rose (删除 'r')
rose -> ros (删除 'e')

示例 2:

1
2
3
4
5
6
7
8
输入:word1 = "intention", word2 = "execution"
输出:5
解释:
intention -> inention (删除 't')
inention -> enention (将 'i' 替换为 'e')
enention -> exention (将 'n' 替换为 'x')
exention -> exection (将 'n' 替换为 'c')
exection -> execution (插入 'u')

提示:

  • 0 <= word1.length, word2.length <= 500
  • word1 和 word2 由小写英文字母组成

思路

这是用dp能解决的题目

dp五部曲

1、确定dp数组以及下标的含义

dp[i][j]表示以下标i - 1为结尾的字符串word1,和以下标j - 1为结尾的字符串word2,最近编辑距离为dp[i][j]

2、确定递推公式

在确定递推公式的时候,首先要考虑清楚编辑的几种操作

1
2
3
4
5
6
if (word1[i - 1] == word2[j - 1])
不操作
if (word1[i - 1] != word2[j - 1])
增
删
换

也就是如上4种情况。

如果两个字符串相等,那么说明不用任何编辑,dp[i][j]就等于dp[i - 1][j - 1]

那么如果不相等就需要编辑了,如何编辑呢?

  • 操作一:word1删除一个元素,那么就是以下标I - 2为结尾的word1与 j - 1为结尾的word2的最近编辑距离在加上一个操作。

即dp[i][j] = dp[i - 1][j] + 1

  • 操作二:word2删除一个元素,那么就是

dp[i][j] = dp[i][ j - 1] + 1

那怎么都是删除元素,增加元素怎么处理。

增加元素相当于另一个word删除一个元素。

  • 操作三:替换元素,只需要一个操作就能让word1[i - 1]和word2[j - 1]相同

所以dp[i][j] = dp[i - 1][j - 1] + 1

3、dp数组初始化

再回顾一下`dp[i][j]的定义:

dp[i][j] `表示以下标i-1为结尾的字符串word1,和以下标j-1为结尾的字符串word2,最近编辑距离为`dp[i][j]。

那么`dp[i][0] 和 dp[0][j]表示什么呢?

dp[i][0] :以下标i-1为结尾的字符串word1,和空字符串word2,最近编辑距离为dp[i][0]。

那么dp[i][0]就应该是i,对word1里的元素全部做删除操作,即:dp[i][0] = i;

同理dp[0][j] = j;

4、确定遍历顺序

从左到右从上到下

5、举例推导

以示例1为例,输入:word1 = "horse", word2 = "ros"为例,dp矩阵状态图如下:

72.编辑距离1

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
public int minDistance(String word1, String word2) {
if(word1 == null || word2 == null){
return 0;
}
int len1 = word1.length();
int len2 = word2.length();

int[][] dp = new int[len1 + 1][len2 + 1];

//初始化
for(int i = 0 ; i <= len1 ; i++){
dp[i][0] = i;
}
for(int j = 0 ; j <= len2 ; j++){
dp[0][j] = j;
}

for(int i = 1 ; i <= len1 ; i++){
for(int j = 1 ; j <= len2 ; j++){
if(word1.charAt(i - 1) == (word2.charAt(j - 1))){
dp[i][j] = dp[i - 1][j - 1];
}else{
dp[i][j] = Math.min(Math.min(dp[i - 1][j] + 1,dp[i][j - 1] + 1),dp[i - 1][j - 1] + 1);
}
}
}

return dp[len1][len2];

}
}

41、回文子串

647. 回文子串 - 力扣(LeetCode)

给你一个字符串 s ,请你统计并返回这个字符串中 回文子串 的数目。

回文字符串 是正着读和倒过来读一样的字符串。

子字符串 是字符串中的由连续字符组成的一个序列。

示例 1:

1
2
3
输入:s = "abc"
输出:3
解释:三个回文子串: "a", "b", "c"

示例 2:

1
2
3
输入:s = "aaa"
输出:6
解释:6个回文子串: "a", "a", "a", "aa", "aa", "aaa"

提示:

  • 1 <= s.length <= 1000
  • s 由小写英文字母组成

思路

动态规划

1、确定dp数组以及下标的含义

做了很多这种子序列相关的题目,在定义dp数组的时候,很自然就会想到,题目球什么,就咋那么定义dp数组。

绝大多数题目确实是这样,不过本题如果我们定义,dp[i] 为 下标i结尾的字符串有 dp[i]个回文串的话,我们会发现很难找到递归关系。

dp[i] 和 dp[i-1] ,dp[i + 1] 看上去都没啥关系。

所以我们要看回文串的性质。 如图:

img

我们在判断字符串S是否是回文,那么如果我们知道 s[1],s[2],s[3] 这个子串是回文的,那么只需要比较 s[0]和s[4]这两个元素是否相同,如果相同的话,这个字符串s 就是回文串。

那么此时我们是不是能找到一种递归关系,也就是判断一个子字符串(字符串下标范围[i,j])是否回文,依赖于,子字符串(下标范围[i + 1, j - 1])) 是否是回文。

所以为了明确这种递归关系,我们的dp数组是要定义成一位二维dp数组。

布尔类型的dp[i][j]:表示区间范围[i,j] (注意是左闭右闭)的子串是否是回文子串,如果是dp[i][j]为true,否则为false。

2、确定递推公式

在确定递推公式时,要分析如下几种情况。

整体上是两种,就是s[i]与s[j]相等,s[i]与s[j]不相等这两种。

当不相等,那没啥好说的了,一定是false。

如果相等的时候,就复杂一点了,有如下三种情况

  • 情况一:下标 i 和 j 相同,同一个字符例如a,当然是回文子串
  • 情况二:下标i 和 j 相差为 1,例如 aa ,也是回文
  • 情况三:下标 i 与 j 相差大于1的时候,例如cabac,此时s[ i ] 和s[ j ]已经相同了,我们看到 i 到 j 区间是不是回文子串就看aba是不是回文就可以了,那么aba区间就是 i +1与 j - 1区间,这个区间是不是回文就看dp[i + 1] [j - 1]是否为true

递归公式如下

1
2
3
4
5
6
7
8
9
if (s[i] == s[j]) {
if (j - i <= 1) { // 情况一 和 情况二
result++;
dp[i][j] = true;
} else if (dp[i + 1][j - 1]) { // 情况三
result++;
dp[i][j] = true;
}
}

result就是统计回文子串的数量。

注意这里我没有列出当s[i]与s[j]不相等的时候,因为在下面dp[i][j]初始化的时候,就初始为false。

3、dp数组初始化

初始化为false

4、确定遍历顺序

这次遍历顺序可以看出来,情况三是根据dp[i+1][j - 1]是否为true来对dp[i][j]赋值的。

dp[i + 1][j - 1]在dp[i][j]的左下角如图:

647.回文子串

如果这个矩阵是从上到下,从左到右遍历,那么会用到没有计算过的dp[i + 1][j - 1],也就是根据不确定是不是回文的区间来判断是不是回文,所以肯定不对。

所以一定要从下到上,从左到右遍历,这样保证dp[i + 1][j - 1]都是经过计算的

有的代码实现是优先遍历列,然后遍历行,也是一个道路,都是为了保证dp[i +1][j - 1]都是经过计算的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
for (int i = s.size() - 1; i >= 0; i--) {  // 注意遍历顺序
for (int j = i; j < s.size(); j++) {
//为什么是从i开始因为仔细思考一下i等于边界的时候,j那个时候是跟i相等的,因为我们只计算对角线右上部分
if (s[i] == s[j]) {
if (j - i <= 1) { // 情况一 和 情况二
result++;
dp[i][j] = true;
} else if (dp[i + 1][j - 1]) { // 情况三
result++;
dp[i][j] = true;
}
}
}
}
  1. 举例推导dp数组

举例,输入:”aaa”,dp[i][j]状态如下:

647.回文子串1

图中有6个true,所以就是有6个回文子串。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Solution {
public int countSubstrings(String s) {
if(s == null){
return 0;
}
int len = s.length();

boolean[][] dp = new boolean[len][len];
int res = 0;

for (int i = len - 1; i >= 0; i--) {
for (int j = i; j < len; j++) {
if (s.charAt(i) == s.charAt(j)) {
if (j - i <= 1) { // 情况一 和 情况二
res++;
dp[i][j] = true;
} else if (dp[i + 1][j - 1]) { //情况三
res++;
dp[i][j] = true;
}
}
}
}

return res;

}
}

42、最长回文子序列

516. 最长回文子序列 - 力扣(LeetCode)

给你一个字符串 s ,找出其中最长的回文子序列,并返回该序列的长度。

子序列定义为:不改变剩余字符顺序的情况下,删除某些字符或者不删除任何字符形成的一个序列。

示例 1:

1
2
3
输入:s = "bbbab"
输出:4
解释:一个可能的最长回文子序列为 "bbbb" 。

示例 2:

1
2
3
输入:s = "cbbd"
输出:2
解释:一个可能的最长回文子序列为 "bb" 。

提示:

  • 1 <= s.length <= 1000
  • s 仅由小写英文字母组成

思路

我们刚做过回文子串,求的是回文子串,而本题是回文子序列。

回文子串是要连续的,回文子序列可不是连续的

dp五部曲

1、确定dp数组以及下标含义

dp[i][j]:字符串s在[i , j ]范围内最长的回文子序列的长度为dp[i][j]

2、确定递推公式

在判断回文子串的题目中,最关键的就是判断s[i]和s[j]是否相同。

如果相同那么dp[i][j] = dp[i + 1][j - 1] + 2

如图: 516.最长回文子序列

如果不相同,说明s[i]和s[j]的同时加入 并不能增加回文子序列的长度,那么就分别加入s[i]、s[j]看看哪个一可以

加入s[j]的回文子序列长度为dp[i + 1][j]。

加入s[i]的回文子序列长度为dp[i][j - 1]。

那么dp[i][j]一定是取最大的,即:dp[i][j] = max(dp[i + 1][j], dp[i][j - 1]);

516.最长回文子序列1

1
2
3
4
5
if (s[i] == s[j]) {
dp[i][j] = dp[i + 1][j - 1] + 2;
} else {
dp[i][j] = Math.max(dp[i + 1][j], dp[i][j - 1]);
}

3、dp数组如何初始化

首先考虑当 i 和 j 相同的情况,从递推公式:dp[i][j] = dp[i + 1][j - 1] +2可以看出 递推公式是计算不到 i 和 j 相同时候的情况。

所以需要手动初始化一下,当 i 和 j相同,那么dp[i][j]一定是等于1的。即 一个字符串的回文子序列长度为1

其他情况默认初始为0就可以。

4、确定遍历顺序

从递推公式可以看出,dp[i][j] 依赖于 dp[i + 1][j - 1] ,dp[i + 1][j]和 dp[i][j - 1],如图:
img

所以遍历i的时候一定要从下到上遍历,这样才能保证下一行的数据是经过计算的。

j的话,可以正常从左向右遍历。

1
2
3
4
5
6
7
8
9
for (int i = s.size() - 1; i >= 0; i--) {
for (int j = i + 1; j < s.size(); j++) {
if (s[i] == s[j]) {
dp[i][j] = dp[i + 1][j - 1] + 2;
} else {
dp[i][j] = max(dp[i + 1][j], dp[i][j - 1]);
}
}
}
  1. 举例推导dp数组

输入s:”cbbd” 为例,dp数组状态如图:

516.最长回文子序列3

红色框即:dp[0][s.size() - 1]; 为最终结果。

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
class Solution {
public int longestPalindromeSubseq(String s) {
int len = s.length();
int[][] dp = new int[len][len];

for(int i = len - 1 ; i >= 0 ; i--){
dp[i][i] = 1;
}

for(int i = len - 1 ; i >= 0 ; i--){
for(int j = i + 1; j < len ; j++){
if(s.charAt(i) == s.charAt(j)){
dp[i][j] = dp[i + 1][j - 1] + 2;
}else{
dp[i][j] = Math.max(dp[i + 1][j], dp[i][j - 1]);
}
}
}

return dp[0][len - 1];

}
}

第十章 单调栈

1、每日温度

739. 每日温度 - 力扣(LeetCode)

给定一个整数数组 temperatures ,表示每天的温度,返回一个数组 answer ,其中 answer[i] 是指对于第 i 天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用 0 来代替。

示例 1:

1
2
输入: temperatures = [73,74,75,71,69,72,76,73]
输出: [1,1,4,2,1,1,0,0]

示例 2:

1
2
输入: temperatures = [30,40,50,60]
输出: [1,1,1,0]

示例 3:

1
2
输入: temperatures = [30,60,90]
输出: [1,1,0]

提示:

  • 1 <= temperatures.length <= 105
  • 30 <= temperatures[i] <= 100

思路

首先想到的当然是暴力解法,两层for循环,把至少要等待的天数就出来了,时间复杂度是On*2

那么接下来就看看单调栈的解法。

那么什么时候会想到用单调栈呢?

通常是一维数组,要寻找任意一个元素的右边或者左边第一个比自己大或者小的元素的位置,此时我们就要想到可以用单调栈了。时间复杂度为On

例如本题其实就是找到一个元素右边第一个比自己大的元素,此时就应该想到单调栈了。

那么单调栈的原理是什么呢?为什么时间复杂度是On就可以找到每一个元素的右边第一个比他大的元素位置呢?

单调栈的本质就是空间换时间,因为在便利的过过程中需要用一个栈来记录右边第一个比当前元素高的元素。优点是整个数组只需要遍历一次。

更直白的来说,就是用一个栈来记录我们遍历过的元素因为我们遍历数组的时候,我们不知道之前都遍历了哪些元素,以至于遍历一个元素找不到是不是之前遍历过一个更小的,所以我们需要用一个容器(这里用单调栈)来记录我们遍历过的元素。

在使用单调栈的时候首先要明确如下几点:

1、单调栈里存放的元素是什么?

单调栈里只需要存放元素的下标 i 就可以了,如果需要使用对应的元素,直接T[i] 就可以获取。

2、单调栈里元素是递增呢?还是递减呢?

注意以下讲解中,顺序的描述为 从栈头到栈底的顺序,因为单纯的说从左到右或者从前到后,不说栈头朝哪个方向的话,大家一定比较懵。

这里我们要使用递增循序(再强调一下是指从栈头到栈底的顺序),因为只有递增的时候,栈里要加入一个元素i的时候,才知道栈顶元素在数组中右面第一个比栈顶元素大的元素是i。

即:如果求一个元素右边第一个更大元素,单调栈就是递增的,如果求一个元素右边第一个更小元素,单调栈就是递减的。

文字描述理解起来有点费劲,接下来我画了一系列的图,来讲解单调栈的工作过程,大家再去思考,本题为什么是递增栈。

使用单调栈主要有三个判断条件。

  • 当前遍历的元素T[i]小于栈顶元素T[st.top()]的情况
  • 当前遍历的元素T[i]等于栈顶元素T[st.top()]的情况
  • 当前遍历的元素T[i]大于栈顶元素T[st.top()]的情况

把这三种情况分析清楚了,也就理解透彻了。

接下来我们用temperatures = [73, 74, 75, 71, 71, 72, 76, 73]为例来逐步分析,输出应该是 [1, 1, 4, 2, 1, 1, 0, 0]。

首先先将第一个遍历元素加入单调栈

739.每日温度1


加入T[1] = 74,因为T[1] > T[0](当前遍历的元素T[i]大于栈顶元素T[st.top()]的情况)。

我们要保持一个递增单调栈(从栈头到栈底),所以将T[0]弹出,T[1]加入,此时result数组可以记录了,result[0] = 1,即T[0]右面第一个比T[0]大的元素是T[1]。

739.每日温度2


加入T[2],同理,T[1]弹出

739.每日温度3


加入T[3],T[3] < T[2] (当前遍历的元素T[i]小于栈顶元素T[st.top()]的情况),加T[3]加入单调栈。

739.每日温度4


加入T[4],T[4] == T[3] (当前遍历的元素T[i]等于栈顶元素T[st.top()]的情况),此时依然要加入栈,不用计算距离,因为我们要求的是右面第一个大于本元素的位置,而不是大于等于!

739.每日温度5


加入T[5],T[5] > T[4] (当前遍历的元素T[i]大于栈顶元素T[st.top()]的情况),将T[4]弹出,同时计算距离,更新result 739.每日温度6


T[4]弹出之后, T[5] > T[3] (当前遍历的元素T[i]大于栈顶元素T[st.top()]的情况),将T[3]继续弹出,同时计算距离,更新result 739.每日温度7


直到发现T[5]小于T[st.top()],终止弹出,将T[5]加入单调栈

739.每日温度8


加入T[6],同理,需要将栈里的T[5],T[2]弹出

739.每日温度9


同理,继续弹出

739.每日温度10


此时栈里只剩下了T[6]

739.每日温度11


加入T[7], T[7] < T[6] 直接入栈,这就是最后的情况,result数组也更新完了。

739.每日温度12

此时有同学可能就疑惑了,那result[6] , result[7]怎么没更新啊,元素也一直在栈里。

其实定义result数组的时候,就应该直接初始化为0,如果result没有更新,说明这个元素右面没有更大的了,也就是为0。

以上在图解的时候,已经把,这三种情况都做了详细的分析。

  • 情况一:当前遍历的元素T[i]小于栈顶元素T[st.top()]的情况
  • 情况二:当前遍历的元素T[i]等于栈顶元素T[st.top()]的情况
  • 情况三:当前遍历的元素T[i]大于栈顶元素T[st.top()]的情况

通过以上过程,大家可以自己再模拟一遍,就会发现:只有单调栈递增(从栈口到栈底顺序),就是求右边第一个比自己大的,单调栈递减的话,就是求右边第一个比自己小的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Solution {
// 版本 1
public int[] dailyTemperatures(int[] temperatures) {

int lens=temperatures.length;
int []res=new int[lens];

/**
如果当前遍历的元素 大于栈顶元素,表示 栈顶元素的 右边的最大的元素就是 当前遍历的元素,
所以弹出 栈顶元素,并记录
如果栈不空的话,还要考虑新的栈顶与当前元素的大小关系
否则的话,可以直接入栈。
注意,单调栈里 加入的元素是 下标。
*/
Deque<Integer> stack=new LinkedList<>();
stack.push(0);
for(int i=1;i<lens;i++){

if(temperatures[i]<=temperatures[stack.peek()]){
stack.push(i);
}else{
while(!stack.isEmpty()&&temperatures[i]>temperatures[stack.peek()]){
res[stack.peek()]=i-stack.peek();
stack.pop();
}
stack.push(i);
}
}

return res;
}
}

2、下一个更大元素1

496. 下一个更大元素 I - 力扣(LeetCode)

nums1 中数字 x 的 下一个更大元素 是指 x 在 nums2 中对应位置 右侧 的 第一个 比 x 大的元素。

给你两个 没有重复元素 的数组 nums1 和 nums2 ,下标从 0 开始计数,其中nums1 是 nums2 的子集。

对于每个 0 <= i < nums1.length ,找出满足 nums1[i] == nums2[j] 的下标 j ,并且在 nums2 确定 nums2[j] 的 下一个更大元素 。如果不存在下一个更大元素,那么本次查询的答案是 -1 。

返回一个长度为 nums1.length 的数组 ans 作为答案,满足 ans[i] 是如上所述的 下一个更大元素 。

示例 1:

1
2
3
4
5
6
输入:nums1 = [4,1,2], nums2 = [1,3,4,2].
输出:[-1,3,-1]
解释:nums1 中每个值的下一个更大元素如下所述:
- 4 ,用加粗斜体标识,nums2 = [1,3,4,2]。不存在下一个更大元素,所以答案是 -1 。
- 1 ,用加粗斜体标识,nums2 = [1,3,4,2]。下一个更大元素是 3 。
- 2 ,用加粗斜体标识,nums2 = [1,3,4,2]。不存在下一个更大元素,所以答案是 -1 。

示例 2:

1
2
3
4
5
输入:nums1 = [2,4], nums2 = [1,2,3,4].
输出:[3,-1]
解释:nums1 中每个值的下一个更大元素如下所述:
- 2 ,用加粗斜体标识,nums2 = [1,2,3,4]。下一个更大元素是 3 。
- 4 ,用加粗斜体标识,nums2 = [1,2,3,4]。不存在下一个更大元素,所以答案是 -1 。

提示:

  • 1 <= nums1.length <= nums2.length <= 1000
  • 0 <= nums1[i], nums2[i] <= 104
  • nums1和nums2中所有整数 互不相同
  • nums1 中的所有整数同样出现在 nums2 中

思路

需要对单调栈使用的更熟练一些,才能顺利的把题目写出来。

从题目示例中,我们可以看出最后是要求nums1的每个元素在nums2中下一个比当前元素大的元素,那么就要定义一个和nums1一样大小的数组res来存放结果。

那么定义这个res数组初始化应该为多少呢?

题目说如果不存在对应位置就输出-1,所以res数组如果某位位置没有被复制,那么就应该是-1,所以初始化为-1.

在遍历num2的过过程中,我们要判断nums2[i] 是否在nums1中出现过,因为最后是要根据nums1元素的下标来更新res数组。

注意题目中说是两个没有重复元素 的数组 nums1 和 nums2

没有重复元素,我们就可以用map来做映射了,根据数值快速找到下标,还可以判断nums2[i] 是否在nums1中出现过。

然后就先初始化一下

1
2
3
4
HashMap<int,int> map = new HashMap<>();
for(int i = 0 ; i < nums1.length ; i++){
map.put(nums1[i],i);
}

使用单调栈,首先要想单调栈是从大道到小还是从小到大。

栈头到栈底的顺序,要从小到大,也就是保持栈里的元素为递增顺序。

只要保持递增,才能找到右边第一个比自己大的元素。

接下来分析如下三种情况,一定要分析清楚。

1、情况一:当前遍历的元素T[i] 小于栈顶元素T[st.peek()]的情况

此时满足递增栈,所以直接入栈。

2、情况二:当前遍历的元素T[i] 等于栈顶元素T[st.peek()]的情况

如果相等的话,依然直接入栈,因为我们要求的是右边第一个比自己大的元素,而不是大于等于

3、情况三:当前遍历的元素T[i] 大于栈顶元素T[peek()]的情况

此时如果入栈就不满足递增栈了,这也是找到右边第一个比自己大的元素的时候。

判断栈顶元素是否在nums1出现过,(注意栈里的元素是nums2的元素),如果出现过,开始记录结果。

记录结果,要清楚,此时栈顶元素在nums2数组的右边第一个大的元素是nums2[i] (即当前遍历元素)

代码如下

1
2
3
4
5
6
7
8
9
10
11
//当前遍历的元素大于栈顶元素并且栈不为空
while(!st.isEmpty() && nums2[i] > nums2[st.peek()])
{
//map中是否存在nums2的元素,也就是说当前栈顶元素是否在nums1中
if(hashmap.containsKey(nums2[st.peek()])){
int index = hashmap.get(nums2[st.peek()]);
res[index] = nums2[i];
}
st.pop();
}
st.push(i);

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
class Solution {
public int[] nextGreaterElement(int[] nums1, int[] nums2) {
//初始化答案数组,是nums1
int[] res = new int[nums1.length];
Arrays.fill(res,-1);

//初始化好之后由于没有重复元素,所以将nums1中的元素存到hashmap里面方便后面遍历nums2的时候查找是否在Nums1中
HashMap<Integer,Integer> map = new HashMap<>();

//然后将nums1中的元素都放到map里面然后nums1的元素当做键,下标为值
for(int i = 0 ; i < nums1.length ; i++){
map.put(nums1[i] , i);
}

//然后用stack来开始存下一个,st中存的是下标
Deque<Integer> st = new ArrayDeque<>();
st.push(0);//把nums2的第一个下标存入

for(int i = 1 ; i < nums2.length ; i++){
if(nums2[i] <= nums2[st.peek()]){
//情况一和二,当前遍历的元素小于等于栈顶都可以直接放入栈中
st.push(i);
}else{
while(!st.isEmpty() && nums2[i] > nums2[st.peek()]){
//如果当前遍历的元素大于栈顶了,那么这时候就是记录到右侧第一个比x大的元素的时候了
if(map.containsKey(nums2[st.peek()])){
//如果栈顶的元素在nums1中,需要记录
int index = map.get(nums2[st.peek()]);
res[index] = nums2[i];
}
//如果在nums1中没有或者已经记录完了,把前面小于的全部剔除栈
st.pop();
}
st.push(i);
}
}
return res;
}
}

3、下一个更大元素2

503. 下一个更大元素 II - 力扣(LeetCode)

给定一个循环数组 nums ( nums[nums.length - 1] 的下一个元素是 nums[0] ),返回 nums 中每个元素的 下一个更大元素 。

数字 x 的 下一个更大的元素 是按数组遍历顺序,这个数字之后的第一个比它更大的数,这意味着你应该循环地搜索它的下一个更大的数。如果不存在,则输出 -1 。

示例 1:

1
2
3
4
5
输入: nums = [1,2,1]
输出: [2,-1,2]
解释: 第一个 1 的下一个更大的数是 2;
数字 2 找不到下一个更大的数;
第二个 1 的下一个最大的数需要循环搜索,结果也是 2。

示例 2:

1
2
输入: nums = [1,2,3,4,3]
输出: [2,3,4,-1,4]

提示:

  • 1 <= nums.length <= 104
  • -109 <= nums[i] <= 109

思路

这题和每日温度几乎如出一辙

但是本题是循环数组

问题是如何处理循环数组,首先循环数组不一定是递增的,其次如果循环到最后还找不到比当前元素大的是否有可能在左边部分,并且如果是最大的元素如何判断出来,不然就会一直循环下去了

反正是循环数组,那么可以把两个数组拼接在一起,然后使用单调栈求下一个最大值。

将两个nums数组拼接在一起,使用单调栈计算出每一个元素的下一个最大值,最后再把结果集res数组,恢复到原数组大小就可以了。

但是优化一下,遇到循环数组可以使用 % 的方法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
class Solution {
public int[] nextGreaterElements(int[] nums) {
//边界判断
if(nums == null || nums.length <= 1) {
return new int[]{-1};
}
int size = nums.length;
int[] result = new int[size];//存放结果
Arrays.fill(result,-1);//默认全部初始化为-1
Stack<Integer> st= new Stack<>();//栈中存放的是nums中的元素下标
for(int i = 0; i < 2*size; i++) {
while(!st.empty() && nums[i % size] > nums[st.peek()]) {
result[st.peek()] = nums[i % size];//更新result
st.pop();//弹出栈顶
}
st.push(i % size);
}
return result;
}
}

4、接雨水

42. 接雨水 - 力扣(LeetCode)

给定 n 个非负整数表示每个宽度为 1 的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。

示例 1:

img

1
2
3
输入:height = [0,1,0,2,1,0,1,3,2,1,2,1]
输出:6
解释:上面是由数组 [0,1,0,2,1,0,1,3,2,1,2,1] 表示的高度图,在这种情况下,可以接 6 个单位的雨水(蓝色部分表示雨水)。

示例 2:

1
2
输入:height = [4,2,0,3,2,5]
输出:9

提示:

  • n == height.length
  • 1 <= n <= 2 * 104
  • 0 <= height[i] <= 105

思路

单调栈

首先这道题目先思考一下,怎么会接到雨水,是不是右边最大元素以及左边最大元素,也就是右边有比自己大的元素,并且左边也有比自己大的元素。

准备工作

那么本题使用单调栈有如下几个问题

1、首先单调栈是按照行方向来计算雨水的,如图:

42.接雨水2

2、使用单调栈内元素的顺序

从大到小还是从小到大呢?

从栈头到栈底应该的顺序是从小到大的顺序。

因为一旦发现添加的竹子高度大于栈头元素了,此时就出现凹槽了,栈头元素就是凹槽底部的柱子,栈头第二个元素就是凹槽左边的柱子,而添加的元素就是凹槽右边的柱子。

求一个元素右边第一个更大元素,单调栈就是递增的

求一个元素右边第一个更小元素,单调栈就是递减的

3、遇到相同高的柱子怎么办

遇到相同的元素,更新栈内下标,就是将栈里元素(旧下标)弹出,新元素加入栈中。

例如5 5 1 3 这种情况,如果添加第二个5的时候就应该将第一个5的下标弹出,第二个5加入到栈中。

因为我们要求宽度的时候 如果遇到相同高度的柱子,需要使用最右边的柱子来计算宽度

4、栈里要保存什么数值

使用单调栈,也就是通过 长 * 宽 来计算雨水面积的。

长就是通过柱子的高度来计算,宽是通过柱子之间的下标来计算。

单调栈的处理逻辑

以下逻辑主要就是三种情况

  • 情况一:当前遍历的元素(柱子)高度小于栈顶元素的高度 height[i] < height[st.top()]
  • 情况二:当前遍历的元素(柱子)高度等于栈顶元素的高度 height[i] == height[st.top()]
  • 情况三:当前遍历的元素(柱子)高度大于栈顶元素的高度 height[i] > height[st.top()]

先将下标0的柱子加入到栈中,st.push(0);。 栈中存放我们遍历过的元素,所以先将下标0加进来。

然后开始从下标1开始遍历所有的柱子,for (int i = 1; i < height.size(); i++)。

如果当前遍历的元素(柱子)高度小于栈顶元素的高度,就把这个元素加入栈中,因为栈里本来就要保持从小到大的顺序(从栈头到栈底)。

代码如下:

1
if (height[i] < height[st.top()])  st.push(i);

如果当前遍历的元素(柱子)高度等于栈顶元素的高度,要跟更新栈顶元素,因为遇到相相同高度的柱子,需要使用最右边的柱子来计算宽度。

代码如下:

1
2
3
4
if (height[i] == height[st.top()]) { // 例如 5 5 1 7 这种情况
st.pop();
st.push(i);
}

如果当前遍历的元素(柱子)高度大于栈顶元素的高度,此时就出现凹槽了,如图所示:
42.接雨水4

取栈顶元素,将栈顶元素弹出,这个就是凹槽的底部,也就是中间位置,下标记为mid,对应的高度为height[mid](就是图中的高度1)。

此时的栈顶元素st.top(),就是凹槽的左边位置,下标为st.top(),对应的高度为height[st.top()](就是图中的高度2)。

当前遍历的元素i,就是凹槽右边的位置,下标为i,对应的高度为height[i](就是图中的高度3)。

此时大家应该可以发现其实就是栈顶和栈顶的下一个元素以及要入栈的元素,三个元素来接水!

那么雨水高度是 min(凹槽左边高度, 凹槽右边高度) - 凹槽底部高度,代码为:int h = min(height[st.top()], height[i]) - height[mid];

雨水的宽度是 凹槽右边的下标 - 凹槽左边的下标 - 1(因为只求中间宽度),代码为:int w = i - st.top() - 1 ;

当前凹槽雨水的体积就是:h * w。

求当前凹槽雨水的体积代码如下:

1
2
3
4
5
6
7
8
9
while (!st.empty() && height[i] > height[st.top()]) { // 注意这里是while,持续跟新栈顶元素
int mid = st.top();
st.pop();
if (!st.empty()) {
int h = min(height[st.top()], height[i]) - height[mid];
int w = i - st.top() - 1; // 注意减一,只求中间宽度
sum += h * w;
}
}

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
class Solution {
public int trap(int[] height) {
int len = height.length;

if(len <= 2) return 0;

Deque<Integer> st = new ArrayDeque<>();

st.push(0);

int sum = 0 ;
for(int index = 1 ; index < len ; index++){
int stackTop = st.peek();
if(height[index] < height[stackTop]){
st.push(index);
}else if(height[index] == height[stackTop]){
//两个相等的墙出现只要右边的
st.pop();
st.push(index);
}else{
int heightAtIdx = height[index];
while(!st.isEmpty() && heightAtIdx > height[stackTop]){
//这就说明已经遇到右边第一个大的
int mid = st.pop();

if(!st.isEmpty()){
int left = st.peek();
int h = Math.min(height[left], height[index]) - height[mid];
int w = index - left - 1;
int hold = h * w;
if(hold > 0){
sum += hold;
}
stackTop = st.peek();
}
}
st.push(index);
}
}
return sum;
}
}
暴力解法

本题暴力解法也是双指针

首先要明确,要按照行来计算,还是按照列来计算。

按照行来计算如图: 42.接雨水2

按照列来计算如图: 42.接雨水1

一些同学在实现的时候,很容易一会按照行来计算一会按照列来计算,这样就会越写越乱。

我个人倾向于按照列来计算,比较容易理解,接下来看一下按照列如何计算。

首先,如果按照列来计算的话,宽度一定是1了,我们再把每一列的雨水的高度求出来就可以了。

可以看出每一列雨水的高度,取决于,该列 左侧最高的柱子和右侧最高的柱子中最矮的那个柱子的高度。

这句话可以有点绕,来举一个理解,例如求列4的雨水高度,如图:

42.接雨水3

列4 左侧最高的柱子是列3,高度为2

列4 右侧最高的柱子是列7,高度为3

列4 柱子的高度为1

那么列4的雨水高度为 列3和列7的高度最小值减列4高度

列4的雨水高度求出来了,宽度为1,相乘就是列4的雨水的体积了。

首先从头遍历所有的列,并且要注意第一个柱子和最后一个柱子不接雨水

整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Solution {
public int trap(int[] height) {
int sum = 0;
for (int i = 0; i < height.length; i++) {
// 第一个柱子和最后一个柱子不接雨水
if (i==0 || i== height.length - 1) continue;

int rHeight = height[i]; // 记录右边柱子的最高高度
int lHeight = height[i]; // 记录左边柱子的最高高度
for (int r = i+1; r < height.length; r++) {
if (height[r] > rHeight) rHeight = height[r];
}
for (int l = i-1; l >= 0; l--) {
if(height[l] > lHeight) lHeight = height[l];
}
int h = Math.min(lHeight, rHeight) - height[i];
if (h > 0) sum += h;
}
return sum;

}
}

但是这个方法是超时了。

这里其实是有重复的,因为每次都要找左边最高的列和右边最高的列,可能两列或者三列的左边最高和右边最高时同一个。

双指针优化

在暴力解法中,我们可以看到只要记录左边柱子的最高高度 和 右边柱子的最高高度,就可以计算当前位置的雨水面积。

那么为了解决记录左右柱子的最高高度,我们使用双指针来遍历。把每一个位置的左边最高高度记录在一个数组上(maxLeft),右边也是记录在(maxRight)上,这样就避免了重复计算。

双指针版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
class Solution {
public int trap(int[] height) {
int length = height.length;
if (length <= 2) return 0;
int[] maxLeft = new int[length];
int[] maxRight = new int[length];

// 记录每个柱子左边柱子最大高度
maxLeft[0] = height[0];
for (int i = 1; i< length; i++) maxLeft[i] = Math.max(height[i], maxLeft[i-1]);

// 记录每个柱子右边柱子最大高度
maxRight[length - 1] = height[length - 1];
for(int i = length - 2; i >= 0; i--) maxRight[i] = Math.max(height[i], maxRight[i+1]);

// 求和
int sum = 0;
for (int i = 0; i < length; i++) {
int count = Math.min(maxLeft[i], maxRight[i]) - height[i];
if (count > 0) sum += count;
}
return sum;
}
}

5、柱状图中最大的矩形

84. 柱状图中最大的矩形 - 力扣(LeetCode)

给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。

求在该柱状图中,能够勾勒出来的矩形的最大面积。

示例 1:

img

1
2
3
输入:heights = [2,1,5,6,2,3]
输出:10
解释:最大的矩形为图中红色区域,面积为 10

示例 2:

img

1
2
输入: heights = [2,4]
输出: 4

提示:

  • 1 <= heights.length <=105
  • 0 <= heights[i] <= 104

思路

原理上跟接雨水相同,但是细节上又有差异。

双指针

本题要记录每个柱子左边第一个小于该柱子的下标,而不是左边第一个小于该柱子的高度。

min一开始记录的不是最小值而是每一列第一个更小的左边和第一个更小的右边。

然后怎么记录第一个更小的呢?

一开始记录左边第一个小于该柱子的下标是-1,然后从第一列开始,然后用一个t记录该点的左边一列,然后用一个while循环,while循环的条件是t的高度,然后如果t的高度小于当前列的高度,那么就说明是第一个小的了,然后记录在Min里面,如果是大于这里优化过,t是直接跳到第一个比t小的下标的元素中,而不是t减减。

注意这里完成minLeft的时候是从左到右,记录MinRight是从右到左因为left是记录第一个左边比他小的,而right是右边比他大的

准备好Minleft和minright后就开始求和

求和的逻辑是

首先sum是一列一列求的,所以高度是已经知道了,然后宽度就是用高度乘宽度,宽度是下标相减,然后求出最大的面积就行了。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
class Solution {
public int largestRectangleArea(int[] heights) {
int length = heights.length;
int[] minLeftIndex = new int [length];
int[] minRightIndex = new int [length];
// 记录左边第一个小于该柱子的下标
minLeftIndex[0] = -1 ;
for (int i = 1; i < length; i++) {
int t = i - 1;
// 这里不是用if,而是不断向右寻找的过程
while (t >= 0 && heights[t] >= heights[i]) t = minLeftIndex[t];
minLeftIndex[i] = t;
}
// 记录每个柱子右边第一个小于该柱子的下标
minRightIndex[length - 1] = length;
for (int i = length - 2; i >= 0; i--) {
int t = i + 1;
while(t < length && heights[t] >= heights[i]) t = minRightIndex[t];
minRightIndex[i] = t;
}
// 求和
int result = 0;
for (int i = 0; i < length; i++) {
int sum = heights[i] * (minRightIndex[i] - minLeftIndex[i] - 1);
result = Math.max(sum, result);
}
return result;
}
}

第十一章 图论

前言

图论分为五大模块:

1、深搜和广搜

2、并查集

3、最小生成树

4、拖布排序

5、最短路算法

输出细节

同样,图论的输出也有细节,例如 求节点1 到节点5的所有路径, 输出可能是:

1
2
1 2 4 5
1 3 5

表示有两条路可以到节点5, 那储存这个结果需要二维数组,最后在一起输出,力扣是直接return数组就好了,但 ACM模式要求我们自己输出,这里有就细节了。

就拿 只输出一行数据,输出 1 2 4 5 来说,发现结果是对的,一提交,发现OJ返回 格式错误 或者 结果错误。

如果没练习过这种输出方式的录友,就开始怀疑了,这结果一样一样的,怎么就不对,我在力扣上提交都是对的!

大家要注意,5 后面要不要有空格!

上面这段代码输出,5后面是加上了空格了,如果判题机判断 结果的长度,标准答案1 2 4 5长度是7,而上面代码输出的长度是 8,很明显就是不对的。

1、图论理论基础

图的基本概念


二维坐标中,两个点可以连成线,多个点连成的线就构成了图。

当然图也可以就一个几点,甚至没有节点(空图)

图的种类

整体上一般分为 有向图 和 无向图

有向图是指 图中边是有方向的:

img

无向图是指 图中边没有方向:

img

加权有向图,就是图中边是有权值的,例如:

img

加权无向图也是同理。

度

无向图中有几条边连接该节点,该节点就有几度。

例如,该无向图中,节点4的度为5,节点6的度为3.

img

在有向图中,每个节点有出度和入度。

出度:从该节点出发的边的个数。

入度:指向该节点边的个数。

例如,该有向图中,节点3的入度为2,出度为1,节点1的入度为0,出度为2。

img

连通性


在图中表示节点的联通情况,我们称之为连通性。

连通图

在无向图中,任何两个节点都是可以到达的,我们称之为连通图。

如图:

img

如果有节点不能到达其他节点,则为非连通图,如图:

img

节点1 不能到达节点4。

强连通图

在有向图中,任何两个节点是可以相互到达的,我们称之为 强连通图。

这个跟连通图有什么区别

我们来看这个有向图:

img

这个图是强连通图吗?

初步一看,好像这节点都连着呢,但这不是强连通图,节点1 可以到节点5,但节点5 不能到 节点1 。

强连通图是在有向图中任何两个节点是可以相互到达

下面这个有向图才是强连通图:

img

图的构造


我们如何用代码来表示一个图呢?

一般使用邻接表、邻接矩阵 或者用类来表示。

主要是 朴素存储、邻接表和邻接矩阵。

关于朴素存储,这是自创的名字,因为这种存储方式,就是将所有边存下来。

图的存储方式

朴素存储

例如图:

img

图中有8条边,我们就定义 8 2的数组,即有n条边就申请n 2,这么大的数组:

img

数组第一行:6 7,就表示节点6 指向 节点7,以此类推。

当然可以不用数组,用map,或者用 类 到可以表示出 这种边的关系。

这种表示方式的好处就是直观,把节点与节点之间关系很容易展现出来。

但如果我们想知道 节点1 和 节点6 是否相连,我们就需要把存储空间都枚举一遍才行。

这是明显的缺点,同时,我们在深搜和广搜的时候,都不会使用这种存储方式。

因为 搜索中,需要知道 节点与其他节点的链接情况,而这种朴素存储,都需要全部枚举才知道链接情况。

在图论章节的后面文章讲解中,我会举例说明的。大家先有个印象。

邻接矩阵

邻接矩阵 使用 二维数组来表示图结构。 邻接矩阵是从节点的角度来标示图,有多少节点就申请多大的二维数组。

例如: grid[2][5] = 6,表示 节点 2 连接 节点5 为有向图,节点2 指向 节点5,边的权值为6。

如果想表示无向图,即:`grid[2][5] = 6,grid[5][2] = 6,表示节点2 与 节点5 相互连通,权值为6。

如图:

img

在一个 n (节点数)为8 的图中,就需要申请 8 * 8 这么大的空间。

图中有一条双向边,即:grid[2][5] = 6,grid[5][2]= 6

这种表达方式(邻接矩阵) 在 边少,节点多的情况下,会导致申请过大的二维数组,造成空间浪费。

而且在寻找节点连接情况的时候,需要遍历整个矩阵,即 n * n 的时间复杂度,同样造成时间浪费。

邻接矩阵的优点:

  • 表达方式简单,易于理解
  • 检查任意两个顶点间是否存在边的操作非常快
  • 适合稠密图,在边数接近顶点数平方的图中,邻接矩阵是一种空间效率较高的表示方法。

缺点:

  • 遇到稀疏图,会导致申请过大的二维数组造成空间浪费 且遍历 边 的时候需要遍历整个n * n矩阵,造成时间浪费
邻接表

邻接表 使用 数组 + 链表的方式来表示。邻接表是从边的数量来表示图,有多少边 才会申请对应大小的链表。

邻接表的构造如图:

img

这里表达的图是:

  • 节点1 指向 节点3 和 节点5
  • 节点2 指向 节点4、节点3、节点5
  • 节点3 指向 节点4
  • 节点4指向节点1

有多少边 邻接表才会申请多少个对应的链表节点。

从图中可以直观看出 使用 数组 + 链表 来表达 边的连接情况 。

邻接表的优点:

  • 对于稀疏图的存储,只需要存储边,空间利用率高
  • 遍历节点连接情况相对容易

缺点:

  • 检查任意两个节点间是否存在边,效率相对低,需要 O(V)时间,V表示某节点连接其他节点的数量。
  • 实现相对复杂,不易理解

以上大家可能理解比较模糊,没关系,因为大家还没做过图论的题目,对于图的表达没有概念。

这里我先不给出具体的实现代码,大家先有个初步印象,在后面算法题实战中,我还会讲到具体代码实现,等带大家做算法题,写了代码之后,自然就理解了。

图的遍历方式


图的遍历方式基本是两大类:

1、深度优先搜索 dfs

2、广度优先搜索 bfs

在讲解二叉树章节的时候,其实就用过两种遍历方式。

二叉树的递归遍历,是dfs 在二叉树上的遍历方式。

二叉树的层序遍历,是bfs 在二叉树上的遍历方式。

这两种都是搜索算法, 可以用在不同的数据结构上进行搜索。

2、深度优先搜索理论基础

dfs 和 bfs的区别

两者的大概的区别

  • dfs是一个方向去搜,不到黄河不回头,知道遇到绝境了,搜不下去了,再换方向(换方向的过程就涉及到了回溯)。
  • bfs是先把本节点所连接的所有节点遍历一遍,走到下一个节点的时候,在把链接节点的所有节点遍历一遍,搜索方向是四面八方的搜索。

dfs的搜索过程

上面说道dfs是可一个方向搜,不到黄河不回头。 那么我们来举一个例子。

如图一,是一个无向图,我们要搜索从节点1到节点6的所有路径。

图一

那么dfs搜索的第一条路径是这样的: (假设第一次延默认方向,就找到了节点6),图二

图二

此时我们找到了节点6,(遇到黄河了,是不是应该回头了),那么应该再去搜索其他方向了。 如图三:

图三

路径2撤销了,改变了方向,走路径3(红色线), 接着也找到终点6。 那么撤销路径2,改为路径3,在dfs中其实就是回溯的过程(这一点很重要,很多录友不理解dfs代码中回溯是用来干什么的)

又找到了一条从节点1到节点6的路径,又到黄河了,此时再回头,下图图四中,路径4撤销(回溯的过程),改为路径5。

图四

又找到了一条从节点1到节点6的路径,又到黄河了,此时再回头,下图图五,路径6撤销(回溯的过程),改为路径7,路径8 和 路径7,路径9, 结果发现死路一条,都走到了自己走过的节点。

图五

那么节点2所连接路径和节点3所链接的路径 都走过了,撤销路径只能向上回退,去选择撤销当初节点4的选择,也就是撤销路径5,改为路径10 。 如图图六:

图六

上图演示中,其实我并没有把 所有的 从节点1 到节点6的dfs(深度优先搜索)的过程都画出来,那样太冗余了,但 已经把dfs 关键的地方都涉及到了,关键就两点:

  • 搜索方向,是认准一个方向搜,直到碰壁之后再换方向
  • 换方向是撤销原路径,改为节点链接的下一个路径,回溯的过程

dfs的代码框架

首先dfs 搜索一个方向,并需要回溯,所以用递归的方式来实现是最方便的。

有递归的地方就有回溯,那么回溯在哪里呢?

1
2
3
4
5
void dfs(参数){
处理节点
dfs(图,选择的节点);// 递归
回溯,撤销处理结果
}

所以dfs,bfs其实是基础搜索算法,也广泛应用与其他数据结构和算法之中。

这里回顾一下回溯法的代码框架:

1
2
3
4
5
6
7
8
9
10
11
void backtracking(参数){
if(终止条件){
存放结果;
return;
}
for(选择:本层集合中的元素(树种节点孩子的数量就是集合的大小)){
处理节点;
backtracking(路径,选择列表);//递归
回溯,撤销处理结果;
}
}

回溯算法,其实就是dfs的过程,这里给出dfs的代码框架:

1
2
3
4
5
6
7
8
9
10
11
12
void dfs(参数) {
if (终止条件) {
存放结果;
return;
}

for (选择:本节点所连接的其他节点) {
处理节点;
dfs(图,选择的节点); // 递归
回溯,撤销处理结果
}
}

深搜三部曲

之前在递归给出递归三部曲,回溯给出回溯三部曲,深搜也是一样深搜三部曲

1、确认递归函数,参数

1
void dfs(参数)

通常我们递归的时候,我们递归搜索需要了解那些参数,其实也可以在写递归函数的时候,发现需要什么参数,再去补充就可以。

一般情况,深搜需要 二维数组结构保存所有路径,需要一维数组保存单一路径,这种保存结果的数组,我们可以定义一个全局变量,避免让我们的函数参数过多。

1
2
3
List<List<Integer>> res;//保存符合条件的所有路径
List<Integer> path;//保存一条路径从起点到终点(符合的路径)
void dfs(图,目前搜索的节点)

2、确认终止条件

1
2
3
4
if(终止条件){
存放结果;
return;
}

3、处理目前搜索节点出发的路径

一般这里就是一个for循环的操作,取遍历 目前搜索节点 所能到的所有节点。

1
2
3
4
5
for(选择:本节点所连接的其他节点){
处理节点;
dfs(图,选择的节点);//递归
回溯,撤销处理结果
}

3、所有可达路径

98. 所有可达路径

题目描述

给定一个有 n 个节点的有向无环图,节点编号从 1 到 n。请编写一个函数,找出并返回所有从节点 1 到节点 n 的路径。每条路径应以节点编号的列表形式表示。

输入描述

第一行包含两个整数 N,M,表示图中拥有 N 个节点,M 条边

后续 M 行,每行包含两个整数 s 和 t,表示图中的 s 节点与 t 节点中有一条路径

输出描述

输出所有的可达路径,路径中所有节点之间空格隔开,每条路径独占一行,存在多条路径,路径输出的顺序可任意。如果不存在任何一条路径,则输出 -1。

注意输出的序列中,最后一个节点后面没有空格! 例如正确的答案是 1 3 5,而不是 1 3 5, 5后面没有空格!

输入示例

1
2
3
4
5
6
5 5
1 3
3 5
1 2
2 4
4 5

输出示例

1
2
1 3 5
1 2 4 5

提示信息

img

用例解释:

有五个节点,其中的从 1 到达 5 的路径有两个,分别是 1 -> 3 -> 5 和 1 -> 2 -> 4 -> 5。

因为拥有多条路径,所以输出结果为:

1 3 5
1 2 4 5

或

1 2 4 5
1 3 5
都算正确。

数据范围:

  • 图中不存在自环
  • 图中不存在平行边
  • 1 <= N <= 100
  • 1 <= M <= 500

图的存储

在 图论理论基础中我们讲到 两种 图的存储方式:邻接表 和 邻接矩阵

这里演示两种存储图的方法。

邻接矩阵

领接矩阵 使用 二维数组来表述图结构。 邻接矩阵是从节点的角度来表示图,有多少节点就申请多大的二维数组。

本题我们会有 n 个节点,因为节点标号是从1 开始的,为了节点标号和下标对齐,我们申请 n + 1 * n + 1 这么大的二维数组

1
int[][] graph = new int[n + 1][n + 1];

输入 m 个边,构造方式如下:

1
2
3
4
while(m--){
读取两个s ,t
graph[s][t] = 1;
}
邻接表

邻接表 使用 数组 + 链表的方式来表示。邻接表是从边的数量来表示图,有多少遍才会申请对应大小的链表。

这里表达的图是:

  • 节点1 指向 节点3 和 节点5
  • 节点2 指向 节点4、节点3、节点5
  • 节点3 指向 节点4
  • 节点4指向节点1

我们需要构造一个数组,数组里的元素是一个链表。

1
List<LinkedList<Integer>> graph = new ArrayList<>(n + 1);

输入m个边,构造方式如下

1
2
3
4
while(m--){
输入 s ,t;
graph[s].add(t);
}

本题使用邻接表 或者 邻接矩阵都可以,因为后台数据并没有对图的大小以及稠密度做很大的区分。

所以两种方法我们都需要掌握

深度优先搜索

深度三部曲

1、确认递归函数,参数

首先我们dfs函数一定要存一个图,用来遍历的,需要存一个目前我们遍历的节点,定义为 x。

至于 单一路径 和路径集合 可以放在全局变量,那么代码是这样的

1
2
3
4
5
6
List<List<Integer>> res;
List<Integer> path;
//x 当前遍历的节点
//graph 存当前的图
//n 终点
void dfs(int[][] graph,int x,int n)

2、确认终止条件

什么时候我们就找到一条路径了?

当目前遍历的节点 为 最后一个节点 n 的时候 就找到了一条从出发点到终止点 的路径

1
2
3
4
if(x == n){
result.add(path);
return;
}

3、处理目前搜索节点出发的路径

接下来是走 当前遍历节点 x 的下一个节点。

首先是要找到 x节点指向了哪些节点呢?遍历方式是这样的

1
2
3
4
for (int i = 1; i <= n; i++) { // 遍历节点x链接的所有节点
if (graph[x][i] == 1) { // 找到 x指向的节点,就是节点i
}
}

接下来就是将 选中的 x 所指向的节点,加入到 单一路径来

1
path.add(i);//遍历到节点加入到路径中来

进入下一层递归

1
dfs(graph,i,n);进入下一层递归

最后就是回溯的过程,撤销本次添加节点的操作。

1
2
3
4
5
6
7
for (int i = 1; i <= n; i++) { // 遍历节点x链接的所有节点
if (graph[x][i] == 1) { // 找到 x链接的节点
path.add(i); // 遍历到的节点加入到路径中来
dfs(graph, i, n); // 进入下一层递归
path.remove(path.size() - 1); // 回溯,撤销本节点
}
}

整体代码如下

邻接矩阵格式


1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
import java.io.*;
import java.util.*;

public class Main {
// 将 res 和 path 保留在类级别是可以的,但必须在每组数据前清空
public static List<List<Integer>> res = new ArrayList<>();
public static List<Integer> path = new ArrayList<>();

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval; // n个节点
in.nextToken();
int m = (int) in.nval; // m条边

// ======== 关键:重置全局状态 ========
res.clear(); // 清空上一轮的结果
path.clear(); // 清空上一轮的路径
// ================================

// 存储图
int[][] graph = new int[n + 1][n + 1];
while (m-- > 0) {
in.nextToken();
int s = (int) in.nval;
in.nextToken();
int t = (int) in.nval;
graph[s][t] = 1;
}

path.add(1); // 从节点1开始 (现在 path 是空的)
dfs(graph, 1, n); // 开始遍历

// 输出结果
if (res.isEmpty()) {
out.println(-1);
} else {
for (List<Integer> pa : res) {
for (int i = 0; i < pa.size() - 1; i++) {
out.print(pa.get(i) + " ");
}
out.println(pa.get(pa.size() - 1));
}
}
}
out.flush();
out.close();
}

public static void dfs(int[][] graph, int x, int n) {
if (x == n) {
res.add(new ArrayList<>(path)); // 添加路径的副本
return;
}
for (int i = 1; i <= n; i++) {
if (graph[x][i] == 1) {
path.add(i);
dfs(graph, i, n);
path.remove(path.size() - 1); // 回溯
}
}
}
}

邻接表格式


1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
import java.io.*;
import java.util.*;

public class Main {
// 将 res 和 path 保留在类级别是可以的,但必须在每组数据前清空
public static List<List<Integer>> res = new ArrayList<>();
public static List<Integer> path = new ArrayList<>();

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval; // n个节点
in.nextToken();
int m = (int) in.nval; // m条边

// ======== 关键:重置全局状态 ========
res.clear(); // 清空上一轮的结果
path.clear(); // 清空上一轮的路径
// ================================

// 存储图
List<LinkedList<Integer>> graph = new ArrayList<>(n + 1);
for(int i = 0 ; i <= n ; i++){
graph.add(new LinkedList<>());
}
while (m-- > 0) {
in.nextToken();
int s = (int) in.nval;
in.nextToken();
int t = (int) in.nval;
// 使用邻接表表示 s -> t 是相连的
graph.get(s).add(t);
}

path.add(1); // 从节点1开始 (现在 path 是空的)
dfs(graph, 1, n); // 开始遍历

// 输出结果
if (res.isEmpty()) {
out.println(-1);
} else {
for (List<Integer> pa : res) {
for (int i = 0; i < pa.size() - 1; i++) {
out.print(pa.get(i) + " ");
}
out.println(pa.get(pa.size() - 1));
}
}
}
out.flush();
out.close();
}

public static void dfs(List<LinkedList<Integer>> graph, int x, int n) {
if (x == n) {
res.add(new ArrayList<>(path)); // 添加路径的副本
return;
}
for (int i : graph.get(x)) { // 找到 x指向的节点
path.add(i); // 遍历到的节点加入到路径中来
dfs(graph, i, n); // 进入下一层递归
path.remove(path.size() - 1); // 回溯,撤销本节点
}
}
}

4、广度优先搜索理论基础

广搜的搜索方式就适合于解决两点之间的最短路径问题。

因为广搜是从起点出发,以起始点为中心一圈一圈进行搜索,一旦遇到终点,记录之前走过的节点就是一条最短路。

广搜的过程

BFS是一圈一圈的搜索过程,但具体是怎么一圈一圈来搜呢。

我们用一个方格地图,假如每次搜索的方向为 上下左右(不包含斜上方),那么给出一个start起始位置,那么BFS就是从四个方向走出第一步。

图一

如果加上一个end终止位置,那么使用BFS的搜索过程如图所示:

图二

我们从图中可以看出,从start起点开始,是一圈一圈,向外搜索,方格编号1为第一步遍历的节点,方格编号2为第二步遍历的节点,第四步的时候我们找到终止点end。

正是因为BFS一圈一圈的遍历方式,所以一旦遇到终止点,那么一定是一条最短路径。

而且地图还可以有障碍,如图所示:

图三

在第五步,第六步 我只把关键的节点染色了,其他方向周边没有去染色,大家只要关注关键地方染色的逻辑就可以。

从图中可以看出,如果添加了障碍,我们是第六步才能走到end终点。

只要BFS只要搜到终点一定是一条最短路径,大家可以参考上面的图,自己再去模拟一下。

代码框架

这一圈一圈的搜索过程是怎么做到的,是放在什么容器里,才能这样去遍历。

其实我们仅仅需要一个容器,能保存我们要遍历过的元素就可以,那么勇队列,还是用栈,甚至用数组,都是可以的

用队列的话,就是保证灭一圈都是一个方向去赚,例如同意顺时针或者逆时针。

因为队列是先进先出,加入元素和弹出元素的顺序是没有改变的。

如果用栈的话,就是第一圈顺时针遍历,第二圈逆时针遍历,第三圈又顺时针遍历

因为栈是先进后厨,加入元素和弹出元素的顺序改变了。

那么广搜需要注意 转圈搜索的顺序吗?不需要

所以用队列,还是用栈都是可以的,但大家习惯用队列了,所以下面还是用队列来讲,但是并不是非要用队列。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
import java.util.*;

/**
* 广度优先搜索 (BFS) 模板
* 用于在二维网格(地图)上进行遍历
*
* @param grid 二维字符数组,表示地图
* @param visited 二维布尔数组,用于标记已访问的格子,防止重复访问
* @param x 起始搜索位置的行索引
* @param y 起始搜索位置的列索引
*/
public static void bfs(char[][] grid, boolean[][] visited, int x, int y) {
// 方向数组:定义了上下左右四个移动方向
// dir[0] = {0, 1} -> 右 (行不变,列+1)
// dir[1] = {1, 0} -> 下 (行+1,列不变)
// dir[2] = {-1, 0} -> 上 (行-1,列不变)
// dir[3] = {0, -1} -> 左 (行不变,列-1)
int[][] dir = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};

// 创建一个队列,用于存储待探索的格子坐标
// Java 中使用 LinkedList 作为 Queue 的实现
Queue<int[]> queue = new LinkedList<>();

// 将起始位置 (x, y) 加入队列
queue.offer(new int[]{x, y});

// 标记起始位置为已访问,避免重复入队
visited[x][y] = true;

// 当队列不为空时,继续搜索
while (!queue.isEmpty()) {
// 从队列头部取出当前要探索的格子
int[] current = queue.poll();
int curX = current[0]; // 当前格子的行坐标
int curY = current[1]; // 当前格子的列坐标

// 遍历四个方向
for (int i = 0; i < 4; i++) {
// 计算下一个要探索的格子的坐标
int nextX = curX + dir[i][0];
int nextY = curY + dir[i][1];

// 边界检查:判断新坐标是否超出网格范围
if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) {
continue; // 越界,跳过这个方向
}

// 检查该格子是否已经被访问过
if (!visited[nextX][nextY]) {
// 如果未访问,则将其加入队列,准备后续探索
queue.offer(new int[]{nextX, nextY});
// 立即标记为已访问,这是防止重复入队的关键!
visited[nextX][nextY] = true;
}
}
}
// 当队列为空时,说明从起始点 (x, y) 出发所有能到达的格子都已探索完毕
}

5、岛屿数量

99. 岛屿数量

题目描述:

给定一个由 1(陆地)和 0(水)组成的矩阵,你需要计算岛屿的数量。岛屿由水平方向或垂直方向上相邻的陆地连接而成,并且四周都是水域。你可以假设矩阵外均被水包围。

输入描述:

第一行包含两个整数 N, M,表示矩阵的行数和列数。

后续 N 行,每行包含 M 个数字,数字为 1 或者 0。

输出描述:

输出一个整数,表示岛屿的数量。如果不存在岛屿,则输出 0。

输入示例:

1
2
3
4
5
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1

输出示例:

3

提示信息

img

根据测试案例中所展示,岛屿数量共有 3 个,所以输出 3。

数据范围:

  • 1 <= N, M <= 50

深搜版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
import java.io.*;
import java.util.*;

public class Main {

public static int[][] dir = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval; // 行数
in.nextToken();
int m = (int) in.nval; // 列数
int[][] grid = new int[n][m];
// 构造岛屿
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
in.nextToken();
grid[i][j] = (int) in.nval;
}
}
// 构造答案
boolean[][] visited = new boolean[n][m];
int ans = 0;
// ======== 修正:正确的索引顺序 ========
for (int i = 0; i < n; i++) { // i 是行
for (int j = 0; j < m; j++) { // j 是列
if (!visited[i][j] && grid[i][j] == 1) {
ans++;
visited[i][j] = true;
dfs(visited, i, j, grid);
}
}
}
out.println(ans);
}
out.flush();
out.close();
}

public static void dfs(boolean[][] visited, int x, int y, int[][] grid) {
for (int i = 0; i < 4; i++) {
int nextX = x + dir[i][0];
int nextY = y + dir[i][1];
// 边界检查
if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) {
continue;
}
// 检查是否未访问且是陆地
if (!visited[nextX][nextY] && grid[nextX][nextY] == 1) {
visited[nextX][nextY] = true; // 标记为已访问
dfs(visited, nextX, nextY, grid); // 递归探索
}
}
}
}

广度优先搜索版本

不少同学用广搜做这道题目的时候,超时了。 这里有一个广搜中很重要的细节:

根本原因是只要 加入队列就代表 走过,就需要标记,而不是从队列拿出来的时候再去标记走过。

很多同学可能感觉这有区别吗?

如果从队列拿出节点,再去标记这个节点走过,就会发生下图所示的结果,会导致很多节点重复加入队列。

img

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
import java.io.*;
import java.util.*;

public class Main {

public static int[][] dir = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};

// ✅ 修正1:定义静态内部类 Pair (首字母大写)
static class Pair {
int first;
int second;

public Pair(int first, int second) {
this.first = first;
this.second = second;
}
}

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval; // 行数
in.nextToken();
int m = (int) in.nval; // 列数
int[][] grid = new int[n][m];
// 构造岛屿
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
in.nextToken();
grid[i][j] = (int) in.nval;
}
}
// 构造答案
boolean[][] visited = new boolean[n][m];
int ans = 0;

// ✅ 修正2:正确的索引顺序 (i 是行, j 是列)
for (int i = 0; i < n; i++) { // i 从 0 到 n-1 (行)
for (int j = 0; j < m; j++) { // j 从 0 到 m-1 (列)
if (!visited[i][j] && grid[i][j] == 1) {
ans++;
bfs(grid, visited, i, j);
}
}
}
out.println(ans);
}
out.flush();
out.close();
}

public static void bfs(int[][] grid, boolean[][] visited, int x, int y) {
Queue<Pair> queue = new LinkedList<>(); // ✅ 使用 Pair (首字母大写)
queue.add(new Pair(x, y));
visited[x][y] = true;

while (!queue.isEmpty()) {
// ✅ 修正3:先 poll() 获取完整对象,再提取坐标
Pair cur = queue.poll(); // 一次操作获取完整坐标
int curX = cur.first;
int curY = cur.second;

for (int i = 0; i < 4; i++) {
int nextX = curX + dir[i][0];
int nextY = curY + dir[i][1];

if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) {
continue;
}

if (!visited[nextX][nextY] && grid[nextX][nextY] == 1) {
queue.add(new Pair(nextX, nextY));
visited[nextX][nextY] = true;
}
}
}
}
}

6、岛屿的最大面积

100. 岛屿的最大面积

题目描述

给定一个由 1(陆地)和 0(水)组成的矩阵,计算岛屿的最大面积。岛屿面积的计算方式为组成岛屿的陆地的总数。岛屿由水平方向或垂直方向上相邻的陆地连接而成,并且四周都是水域。你可以假设矩阵外均被水包围。

输入描述

第一行包含两个整数 N, M,表示矩阵的行数和列数。后续 N 行,每行包含 M 个数字,数字为 1 或者 0,表示岛屿的单元格。

输出描述

输出一个整数,表示岛屿的最大面积。如果不存在岛屿,则输出 0。

输入示例

1
2
3
4
5
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1

输出示例

4

提示信息

img

样例输入中,岛屿的最大面积为 4。

数据范围:

  • 1 <= M, N <= 50。

思路

本题思路上比较简单,难点其实都是dfs和bfs的理论基础。

DFS

很多人写dfs其实也是凭感觉来的,有的时候dfs函数中写终止条件能过,有的时候dfs函数不写终止条件也能过。

这里其实涉及到dfs的两种写法。

写法一,dfs处理当前节点的相邻节点,即在主函数遇到岛屿就计数为1,dfs处理接下来的相邻陆地

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
import java.io.*;
import java.util.*;

public class Main {

static final int[][] dir = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};
static int count = 0; //记录面积
static int res = 0; //记录最终最大面积

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));

StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval;
in.nextToken();
int m = (int) in.nval;
in.nextToken();
int[][] map = new int[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
map[i][j] = (int) in.nval;
in.nextToken();
}
}

boolean[][] visited = new boolean[n][m];

for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (!visited[i][j] && map[i][j] == 1) {
count = 0;
dfs(map, visited, i, j);
res = Math.max(count, res);
}
}
}
out.println(res);
}
out.flush();
out.close();
}

public static void dfs(int[][] map, boolean[][] visited, int x, int y) {
count++;
visited[x][y] = true;
for (int i = 0; i < 4; i++) {
int nextX = x + dir[i][0];
int nextY = y + dir[i][1];
//水或者已经访问过的跳过
if (nextX < 0
|| nextY < 0
|| nextX >= map.length
|| nextY >= map[0].length
|| visited[nextX][nextY]
|| map[nextX][nextY] == 0) continue;

dfs(map, visited, nextX, nextY);
}
}
}

版本2 这里写终止条件了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
import java.util.Scanner;

public class Main {
// 全局变量 count 记录当前岛屿的面积
private static int count;

// 四个方向:右、下、上、左
private static final int[][] dir = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};

/**
* DFS 遍历岛屿,统计连通的陆地数量
* @param grid 地图(0 表示海水,1 表示陆地)
* @param visited 访问标记数组
* @param x 当前行
* @param y 当前列
*/
public static void dfs(int[][] grid, boolean[][] visited, int x, int y) {
// 终止条件:已访问 或 是海水
if (visited[x][y] || grid[x][y] == 0) return;

// 标记为已访问,并累加岛屿面积
visited[x][y] = true;
count++;

// 向四个方向扩展
for (int i = 0; i < 4; i++) {
int nextX = x + dir[i][0];
int nextY = y + dir[i][1];

// 越界检查
if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) {
continue;
}

dfs(grid, visited, nextX, nextY);
}
}

public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);

// 读入行数 n 和列数 m
int n = scanner.nextInt();
int m = scanner.nextInt();

// 创建地图数组
int[][] grid = new int[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
grid[i][j] = scanner.nextInt();
}
}

// 创建访问标记数组
boolean[][] visited = new boolean[n][m];

// 记录最大岛屿面积
int result = 0;

// 遍历整个地图
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (!visited[i][j] && grid[i][j] == 1) {
count = 0; // 重置当前岛屿面积
dfs(grid, visited, i, j);
result = Math.max(result, count);
}
}
}

// 输出结果
System.out.println(result);

scanner.close();
}
}

那为什么一个需要写一个不需要写,这两个版本的区别是啥,版本1不用写是因为在主函数里计算count1了也就是已经在领地中了,进dfs是继续计算整个领地大小的作用,然后循环上下左右四个方向后自动结束,这是因为提前在主函数里判断过是合法的才会进入dfs。

第二个要写是因为是进去dfs才开始计算领地的一开始count是0,所以需要判断当前访问的是否是陆地,不一定合法。

BFS

这里有人会疑惑为什么BFS需要建立个类封装坐标,DFS不用,因为DFS利用函数调用栈自动保存 x,y坐标,而bfs使用显示队列,需要封装坐标存入队列里面。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import java.util.*;
import java.math.*;

/**
* BFS版
*/
public class Main {
static class Node {
int x;
int y;

public Node(int x, int y) {
this.x = x;
this.y = y;
}
}

static final int[][] dir = {{0, 1}, {1, 0}, {0, -1}, {-1, 0}};
static int result = 0;
static int count = 0;

public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
int n = scanner.nextInt();
int m = scanner.nextInt();
int[][] map = new int[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
map[i][j] = scanner.nextInt();
}
}
boolean[][] visited = new boolean[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (!visited[i][j] && map[i][j] == 1) {
count = 0;
bfs(map, visited, i, j);
result = Math.max(count, result);

}
}
}
System.out.println(result);
}

static void bfs(int[][] map, boolean[][] visited, int x, int y) {
Queue<Node> q = new LinkedList<>();
q.add(new Node(x, y));
visited[x][y] = true;
count++;
while (!q.isEmpty()) {
Node node = q.remove();
for (int i = 0; i < 4; i++) {
int nextX = node.x + dir[i][0];
int nextY = node.y + dir[i][1];
if (nextX < 0 || nextY < 0 || nextX >= map.length || nextY >= map[0].length || visited[nextX][nextY] || map[nextX][nextY] == 0)
continue;
q.add(new Node(nextX, nextY));
visited[nextX][nextY] = true;
count++;
}
}
}
}

7、孤岛的总面积

101. 孤岛的总面积

题目描述

给定一个由 1(陆地)和 0(水)组成的矩阵,岛屿指的是由水平或垂直方向上相邻的陆地单元格组成的区域,且完全被水域单元格包围。孤岛是那些位于矩阵内部、所有单元格都不接触边缘的岛屿。

现在你需要计算所有孤岛的总面积,岛屿面积的计算方式为组成岛屿的陆地的总数。

输入描述

第一行包含两个整数 N, M,表示矩阵的行数和列数。之后 N 行,每行包含 M 个数字,数字为 1 或者 0。

输出描述

输出一个整数,表示所有孤岛的总面积,如果不存在孤岛,则输出 0。

输入示例

1
2
3
4
5
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1

输出示例:

1

提示信息:

img

在矩阵中心部分的岛屿,因为没有任何一个单元格接触到矩阵边缘,所以该岛屿属于孤岛,总面积为 1。

数据范围:

1 <= M, N <= 50。

思路

本题使用dfs,bfs,并查集都是可以的。

本题要求找到不靠边的陆地面积,那么我们只要从周边找到陆地然后通过dfs或者bfs将周边靠陆地且相邻的陆地变成海洋,然后再去重新遍历地图 统计此时还剩下的陆地就可以了。

如图,在遍历地图周围四个边,靠地图四边的陆地,都为绿色,

img

在遇到地图周边陆地的时候,将1都变为0,此时地图为这样:

img

然后我们再去遍历这个地图,遇到有陆地的地方,去采用深搜或者广搜,边统计所有陆地。

思路就是先淹没所有与边界相连的陆地,然后统计剩下的孤立陆地块数量

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
import java.util.*;
import java.io.*;

public class Main{

private static int count = 0;//记录孤岛大小
private static final int[][] dir = {{0,1},{1,0},{-1,0},{0,-1}};//方向

public static void main(String[] args) throws IOException{
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);

PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while(in.nextToken() != StreamTokenizer.TT_EOF){
int n = (int)in.nval;
in.nextToken();
int m = (int)in.nval;
int[][] grid = new int[n][m];

//读取网格
for(int i = 0 ; i < n ; i++){
for(int j = 0 ; j < m ; j++){
in.nextToken();
grid[i][j] = (int)in.nval;
}
}

//淹没左右两边的岛屿
for(int i = 0 ; i < n ; i++){
if(grid[i][0] == 1) bfs(grid,i,0);//淹没
if(grid[i][m - 1] == 1) bfs(grid,i , m - 1);//淹没
}


//淹没上和下两边的岛屿
for(int j = 0 ; j < m ; j++){
if(grid[0][j] == 1) bfs(grid,0,j);
if(grid[n - 1][j] == 1) bfs(grid, n - 1, j);
}

count = 0;
for(int i = 0 ; i < n ; i++){
for(int j = 0 ; j < m ; j++){
if(grid[i][j] == 1) bfs(grid,i,j);
}
}

out.println(count);

}
out.flush();
out.close();

}
public static void bfs(int[][] grid , int x , int y){
Queue<int[]> que = new LinkedList<>();
que.add(new int[]{x,y});
grid[x][y] = 0;//只要加入队列,立刻标记
count++;
while(!que.isEmpty()){
int[] cur = que.poll();
int curx = cur[0];
int cury = cur[1];
for(int i = 0 ; i < 4 ; i++){
int nextx = curx + dir[i][0];
int nexty = cury + dir[i][1];
if(nextx < 0 || nextx >= grid.length || nexty < 0 || nexty >= grid[0].length) continue;//越界了,直接跳过
if(grid[nextx][nexty] == 1){
que.add(new int[]{nextx,nexty});
count++;
grid[nextx][nexty] = 0;//只要加入队列立刻标记
}
}
}
}
}

dfs版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
import java.util.*;
import java.io.*;

public class Main {

private static final int[][] dir = {{0,1},{1,0},{-1,0},{0,-1}}; // 四个方向

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval;
in.nextToken();
int m = (int) in.nval;
int[][] grid = new int[n][m];

// 读取网格
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
in.nextToken();
grid[i][j] = (int) in.nval;
}
}

// 第一步:从四条边界开始,用 DFS 淹没所有与边界相连的陆地
// 淹没左右边界
for (int i = 0; i < n; i++) {
if (grid[i][0] == 1) dfs(grid, i, 0);
if (grid[i][m - 1] == 1) dfs(grid, i, m - 1);
}
// 淹没上下边界
for (int j = 0; j < m; j++) {
if (grid[0][j] == 1) dfs(grid, 0, j);
if (grid[n - 1][j] == 1) dfs(grid, n - 1, j);
}

// 第二步:统计剩余封闭岛屿的总陆地块数
int count = 0;
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (grid[i][j] == 1) {
count += dfs(grid, i, j); // 每次返回该岛屿的面积
}
}
}

out.println(count);
}

out.flush();
out.close();
br.close();
}

/**
* DFS 函数:从 (x, y) 开始淹没连通的陆地,并返回访问到的陆地块数量
*/
public static int dfs(int[][] grid, int x, int y) {
// 越界或已是水域,返回 0
if (x < 0 || x >= grid.length || y < 0 || y >= grid[0].length || grid[x][y] == 0) {
return 0;
}

grid[x][y] = 0; // 标记为已访问(淹没)
int area = 1; // 当前格子贡献 1

// 向四个方向递归
for (int[] d : dir) {
int nx = x + d[0];
int ny = y + d[1];
area += dfs(grid, nx, ny);
}

return area;
}
}

8、沉没孤岛

102. 沉没孤岛

题目描述:

给定一个由 1(陆地)和 0(水)组成的矩阵,岛屿指的是由水平或垂直方向上相邻的陆地单元格组成的区域,且完全被水域单元格包围。孤岛是那些位于矩阵内部、所有单元格都不接触边缘的岛屿。

现在你需要将所有孤岛“沉没”,即将孤岛中的所有陆地单元格(1)转变为水域单元格(0)。

输入描述:

第一行包含两个整数 N, M,表示矩阵的行数和列数。

之后 N 行,每行包含 M 个数字,数字为 1 或者 0,表示岛屿的单元格。

输出描述

输出将孤岛“沉没”之后的岛屿矩阵。

输入示例:

1
2
3
4
5
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1

输出示例:

1
2
3
4
1 1 0 0 0
1 1 0 0 0
0 0 0 0 0
0 0 0 1 1

提示信息:

img

将孤岛沉没:

img

数据范围:

1 <= M, N <= 50

思路

这题刚好跟上一题正好反过来了,那么死路上也是差不多的。

s留上依然是从地图周边出发,将周边空格相邻的陆地都做上标记,然后再遍历一遍地图,遇到 陆地 且没做过标记的,那么都是地图中间的陆地,全部改成水域就行。

有的录友可能想,我再定义一个 visited 二维数组,单独标记周边的陆地,然后遍历地图的时候同时对 地图数组 和 数组visited 进行判断,决定 陆地是否变成水域。

这样做其实就有点麻烦了,不用额外定义空间了,标记周边的陆地,可以直接改陆地为其他特殊值作为标记。

步骤一:深搜或者广搜将地图周边的 1 (陆地)全部改成 2 (特殊标记)

步骤二:将水域中间 1 (陆地)全部改成 水域(0)

步骤三:将之前标记的 2 改为 1 (陆地)

如图:

img

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
import java.io.*;
import java.util.*;

public class Main {

private static final int[][] dir = {{0, 1}, {0, -1}, {1, 0}, {-1, 0}};

public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval;
in.nextToken();
int m = (int) in.nval;
int[][] grid = new int[n][m];

//读取小岛
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
in.nextToken();
grid[i][j] = (int) in.nval;
}
}

//左右变2
for (int i = 0; i < n; i++) {
if (grid[i][0] == 1) dfs(grid, i, 0);
if (grid[i][m - 1] == 1) dfs(grid, i, m - 1);
}

//上下变2
for (int j = 0; j < m; j++) {
if (grid[0][j] == 1) dfs(grid, 0, j);
if (grid[n - 1][j] == 1) dfs(grid, n - 1, j);
}

//孤岛变0
// 步骤二、步骤三
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (grid[i][j] == 1) grid[i][j] = 0;
if (grid[i][j] == 2) grid[i][j] = 1;
}
}

//打印
for(int i = 0 ; i < n ; i++){
for(int j = 0 ; j < m ; j++){
out.print(grid[i][j] + " ");
}
out.println();
}
}
out.flush();
out.close();
}

public static void dfs(int[][] grid, int x, int y) {
grid[x][y] = 2;
for (int[] d : dir) {
int nextX = x + d[0];
int nextY = y + d[1];
// 超过边界
if (nextX < 0 || nextX >= grid.length || nextY < 0 || nextY >= grid[0].length) continue;
// 不符合条件,不继续遍历
if (grid[nextX][nextY] == 0 || grid[nextX][nextY] == 2) continue;
dfs(grid, nextX, nextY);
}
}
}

9、水流问题

103. 水流问题

题目描述:

现有一个 N × M 的矩阵,每个单元格包含一个数值,这个数值代表该位置的相对高度。矩阵的左边界和上边界被认为是第一组边界,而矩阵的右边界和下边界被视为第二组边界。

矩阵模拟了一个地形,当雨水落在上面时,水会根据地形的倾斜向低处流动,但只能从较高或等高的地点流向较低或等高并且相邻(上下左右方向)的地点。我们的目标是确定那些单元格,从这些单元格出发的水可以达到第一组边界和第二组边界。

输入描述:

第一行包含两个整数 N 和 M,分别表示矩阵的行数和列数。

后续 N 行,每行包含 M 个整数,表示矩阵中的每个单元格的高度。

输出描述:

输出共有多行,每行输出两个整数,用一个空格隔开,表示可达第一组边界和第二组边界的单元格的坐标,输出顺序任意。

输入示例:

1
2
3
4
5
6
5 5
1 3 1 2 4
1 2 1 3 2
2 4 7 2 1
4 5 6 1 1
1 4 1 2 1

输出示例:

1
2
3
4
5
6
7
8
0 4
1 3
2 2
3 0
3 1
3 2
4 0
4 1

提示信息:

img

图中的蓝色方块上的雨水既能流向第一组边界,也能流向第二组边界。所以最终答案为所有蓝色方块的坐标。

数据范围:

1 <= M, N <= 50

思路

一个比较直白的想法,就是遍历每个点,然后看这个点能不能同时到达第一组边界和第二组边界,至于遍历方式可以用dfs,也可以用bfs

这种思路很直白,但很明显代码超时了,我们来看看时间复杂度。

遍历每一个节点是 m n ,遍历每一个节点的时候,都要做深搜,深搜的时间复杂度是: m n

那么整体的时间复杂度就是m m n * n 了是一个四次方的时间复杂度

优化一下

那么我们可以反过来想,从第一组边界上的节点逆流而上,将遍历过的节点都标记上。

同样从第二组边界的边上节点 逆流而上,将遍历过的节点也标记上。

然后两房都标记过的节点就是既可以流向第一组边界也可以流向第二组边界的节点。

从第一组边界边上节点出发,如图: (图中并没有把所有遍历的方向都画出来,只画关键部分)

img

从第二组边界上节点出发,如图: (图中并没有把所有遍历的方向都画出来,只画关键部分)

img

最后,我们得到两个方向交界的这些节点,就是我们最后要求的节点。

按照这样的逻辑,就可以写出如下遍历代码:(详细注释)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
import java.io.*;
import java.util.*;

public class Main {
public static void main(String[] args) throws IOException {
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StreamTokenizer in = new StreamTokenizer(br);
PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));

while (in.nextToken() != StreamTokenizer.TT_EOF) {
int n = (int) in.nval; // 行数
in.nextToken();
int m = (int) in.nval; // 列数

int[][] heights = new int[n][m];
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
in.nextToken();
heights[i][j] = (int) in.nval;
}
}

// 两个标记数组:能否流到太平洋 / 大西洋
boolean[][] pacific = new boolean[n][m];
boolean[][] atlantic = new boolean[n][m];

// 从左边界(太平洋)和右边界(大西洋)开始 DFS(列固定,行变化)
for (int i = 0; i < n; i++) {
dfs(heights, i, 0, pacific, Integer.MIN_VALUE); // 左边:太平洋
dfs(heights, i, m - 1, atlantic, Integer.MIN_VALUE); // 右边:大西洋
}

// 从上边界(太平洋)和下边界(大西洋)开始 DFS(行固定,列变化)
for (int j = 0; j < m; j++) {
dfs(heights, 0, j, pacific, Integer.MIN_VALUE); // 上边:太平洋
dfs(heights, n - 1, j, atlantic, Integer.MIN_VALUE); // 下边:大西洋
}

// 收集能同时到达两个海洋的位置
List<List<Integer>> res = new ArrayList<>();
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (pacific[i][j] && atlantic[i][j]) {
res.add(Arrays.asList(i, j));
}
}
}

// 输出结果
for (List<Integer> cell : res) {
out.println(cell.get(0) + " " + cell.get(1));
}
}

out.flush();
out.close();
}

// 从 (row, col) 开始逆流而上(水往高处流)
public static void dfs(int[][] heights, int row, int col, boolean[][] visited, int preHeight) {
// 越界或已访问
if (row < 0 || row >= heights.length || col < 0 || col >= heights[0].length || visited[row][col]) {
return;
}

// 当前高度低于前一个位置,无法逆流
if (heights[row][col] < preHeight) {
return;
}

// 标记为可到达
visited[row][col] = true;

// 向四个方向搜索
dfs(heights, row + 1, col, visited, heights[row][col]);
dfs(heights, row - 1, col, visited, heights[row][col]);
dfs(heights, row, col + 1, visited, heights[row][col]);
dfs(heights, row, col - 1, visited, heights[row][col]);
}
}

10、建造最大岛屿

104. 建造最大岛屿

题目描述:

给定一个由 1(陆地)和 0(水)组成的矩阵,你最多可以将矩阵中的一格水变为一块陆地,在执行了此操作之后,矩阵中最大的岛屿面积是多少。

岛屿面积的计算方式为组成岛屿的陆地的总数。岛屿是被水包围,并且通过水平方向或垂直方向上相邻的陆地连接而成的。你可以假设矩阵外均被水包围。

输入描述:

第一行包含两个整数 N, M,表示矩阵的行数和列数。之后 N 行,每行包含 M 个数字,数字为 1 或者 0,表示岛屿的单元格。

输出描述:

输出一个整数,表示最大的岛屿面积。

输入示例:

1
2
3
4
5
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1

输出示例

6

提示信息

img

对于上面的案例,有两个位置可将 0 变成 1,使得岛屿的面积最大,即 6。

img

数据范围:

1 <= M, N <= 50。

思路

本题的一个暴力想法,应该是遍历地图尝试讲每一0改成1,然后去搜索地图中的最大的岛屿面积

计算地图的最大面积:遍历地图 + 深搜岛屿 , 时间复杂度就是 n * n

每改变一个0 的方格,都需要计算一个地图的最大面积,所以整体的时间复杂度是 n ^ 4(有n ^ 2 个方格,然后翻转一次然后遍历+深搜一次就是n ^ 2 所以相乘就是n ^4)

优化思路

其实每次深搜遍历计算最大岛屿面积,我们都做了很多重复的工作,

只要用一次深搜把每个岛屿的面积记录下俩就好

1、一次遍历地图,得出哥哥岛屿的面积,然后编号记录,可以使用map记录,key为岛屿编号,value为岛屿面积。

2、再遍历地图,遍历0的方格(因为要将0变成1),并统计该1(由0变成1)周边岛屿面积,将其相邻面积相加在一起,遍历所有0之后,就可以得出 选一个0 变成 1 之后的最大面积

第二步:再遍历地图,遍历0的方格(因为要将0变成1),并统计该1(由0变成的1)周边岛屿面积,将其相邻面积相加在一起,遍历所有 0 之后,就可以得出 选一个0变成1 之后的最大面积。

拿如下地图的岛屿情况来举例: (1为陆地)

img

第一步,则遍历地图,并将岛屿的编号和面积都统计好,过程如图所示:

img

这个过程时间复杂度 n n 。可能有录友想:分明是两个for循环下面套这一个dfs,时间复杂度怎么回事 n n呢?

其实大家可以仔细看一下代码,n * n这个方格地图中,每个节点我们就遍历一次,并不会重复遍历。

第二步过程如图所示:

img

也就是遍历每一个0的方格,并统计其相邻岛屿面积,最后取一个最大值。

这个过程的时间复杂度也为 n * n。

所以整个解法的时间复杂度,为 n n + n n 也就是 n^2。

最后整体代码如下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
public class Main {
// 该方法采用 DFS
// 定义全局变量
// 记录每次每个岛屿的面积
static int count;
// 对每个岛屿进行标记
static int mark;
// 定义二维数组表示四个方位
static int[][] dirs = {{0, 1}, {0, -1}, {1, 0}, {-1, 0}};

// DFS 进行搜索,将每个岛屿标记为不同的数字
public static void dfs(int[][] grid, int x, int y, boolean[][] visited) {
// 当遇到边界,直接return
if (x < 0 || x >= grid.length || y < 0 || y >= grid[0].length) return;
// 遇到已经访问过的或者遇到海水,直接返回
if (visited[x][y] || grid[x][y] == 0) return;

visited[x][y] = true;
count++;
grid[x][y] = mark;

// 继续向下层搜索
dfs(grid, x, y + 1, visited);
dfs(grid, x, y - 1, visited);
dfs(grid, x + 1, y, visited);
dfs(grid, x - 1, y, visited);
}

public static void main (String[] args) {
// 接收输入
Scanner sc = new Scanner(System.in);
int m = sc.nextInt();
int n = sc.nextInt();

int[][] grid = new int[m][n];
for (int i = 0; i < m; i++) {
for (int j = 0; j < n; j++) {
grid[i][j] = sc.nextInt();
}
}

// 初始化mark变量,从2开始(区别于0水,1岛屿)
mark = 2;

// 定义二位boolean数组记录该位置是否被访问
boolean[][] visited = new boolean[m][n];

// 定义一个HashMap,记录某片岛屿的标记号和面积
HashMap<Integer, Integer> getSize = new HashMap<>();

// 定义一个HashSet,用来判断某一位置水四周是否存在不同标记编号的岛屿
HashSet<Integer> set = new HashSet<>();

// 定义一个boolean变量,看看DFS之后,是否全是岛屿
boolean isAllIsland = true;

// 遍历二维数组进行DFS搜索,标记每片岛屿的编号,记录对应的面积
for (int i = 0; i < m; i++) {
for (int j = 0; j < n; j++) {
if (grid[i][j] == 0) isAllIsland = false;
if (grid[i][j] == 1) {
count = 0;
dfs(grid, i, j, visited);
getSize.put(mark, count);
mark++;
}
}
}

int result = 0;
if (isAllIsland) result = m * n;

// 对标记完的grid继续遍历,判断每个水位置四周是否有岛屿,并记录下四周不同相邻岛屿面积之和
// 每次计算完一个水位置周围可能存在的岛屿面积之和,更新下result变量
for (int i = 0; i < m; i++) {
for (int j = 0; j < n; j++) {
if (grid[i][j] == 0) {
set.clear();
// 当前水位置变更为岛屿,所以初始化为1
int curSize = 1;

for (int[] dir : dirs) {
int curRow = i + dir[0];
int curCol = j + dir[1];

if (curRow < 0 || curRow >= m || curCol < 0 || curCol >= n) continue;
int curMark = grid[curRow][curCol];
// 如果当前相邻的岛屿已经遍历过或者HashMap中不存在这个编号,继续搜索
if (set.contains(curMark) || !getSize.containsKey(curMark)) continue;
set.add(curMark);
curSize += getSize.get(curMark);
}

result = Math.max(result, curSize);
}
}
}

// 打印结果
System.out.println(result);
}
}

11、并查集理论

并查集解决连通性问题。

并查集功能:将两个元素添加到一个集合中,判断两个元素在不在同一个集合。

那么为什么需要并查集,用set或者map不就可以了吗?

因为操作效率不同,在优化后的并查集中,合并两个集合只需要O(1)的复杂度就能完成,如果用现成的Set或者map需要遍历一个集合并加入到另一个,就慢了。

那么并查集是如何判断两个元素在一个集合内?

举例有A,B,C三个元素,然后A指向B,B指向C,C指向自己C,那么这时候判断A和B是否在同一个集合内,这时候由于A和B的根节点都是C,所以判断都在同一个集合内。

这就是并查集大体的工作过程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
void init(){
for(int i ; i < n ;i++){
father[i] = i;//默认自己指向自己
}
}
void join(int a ,int b){
a = find(a);
b = find(b);
if(a == b){//判断是否原本就是同一个集合了
return;
}
father[a] = b;//这里其实就是将a的根节点和b的根节点连在一起
}
boolean isSame(int a,int b){
//找根节点的函数实现
a = find(a);
b = find(b);
if(a == b){
return true;
}else{
return false;
}
}
int find(int u){
if( u == father[u]){
return u;
}
int father = find(father[u]);
return father;
}
//只有最深层的递归(满足 u == father[u] 的那层)
//所有上层递归都必须执行到最后的 return,把结果一层层传回去

在find里面还能进行性能优化

路径压缩

假设find里面非常的深,每次find都要一层一层递归才找到根节点,递归是特别耗时的。优化就是把所有层变成两层,扁平化,只需要递归一次就能找到根节点,那么如何压缩呢?在find里面修改

1
2
3
4
5
6
7
int find(int u){
if(u == father[u]){
return u;
}
father[u] = find(father[u]);
return father[u];
}

那么这样就实现了路径压缩了。